AI安全新前线:LawZero如何为前沿模型构建技术护栏

LawZero在ALL IN大会倡导将AI诚实性与可靠性从抽象价值转化为可工程化的安全目标。
在AI能力加速跃升的背景下,安全组织LawZero在ALL IN大会上阐述了其「工程化诚实与可靠性」的研究议程。演讲提出两条必须并行推进的防线:社会层面的治理机制与技术层面的稳健护栏,强调单靠任何一方均不足够。LawZero将「诚实」与「可靠性」定为具体的工程目标,而非停留于抽象的价值宣言——这意味着安全研究需将幻觉抑制、行为一致性等问题拆解为可度量、可优化的技术指标。演讲还透露了涉及加拿大、德国的跨国合作与资金支持,折射出AI安全议题正从单一实验室行为演变为国际协作事业的更大趋势。
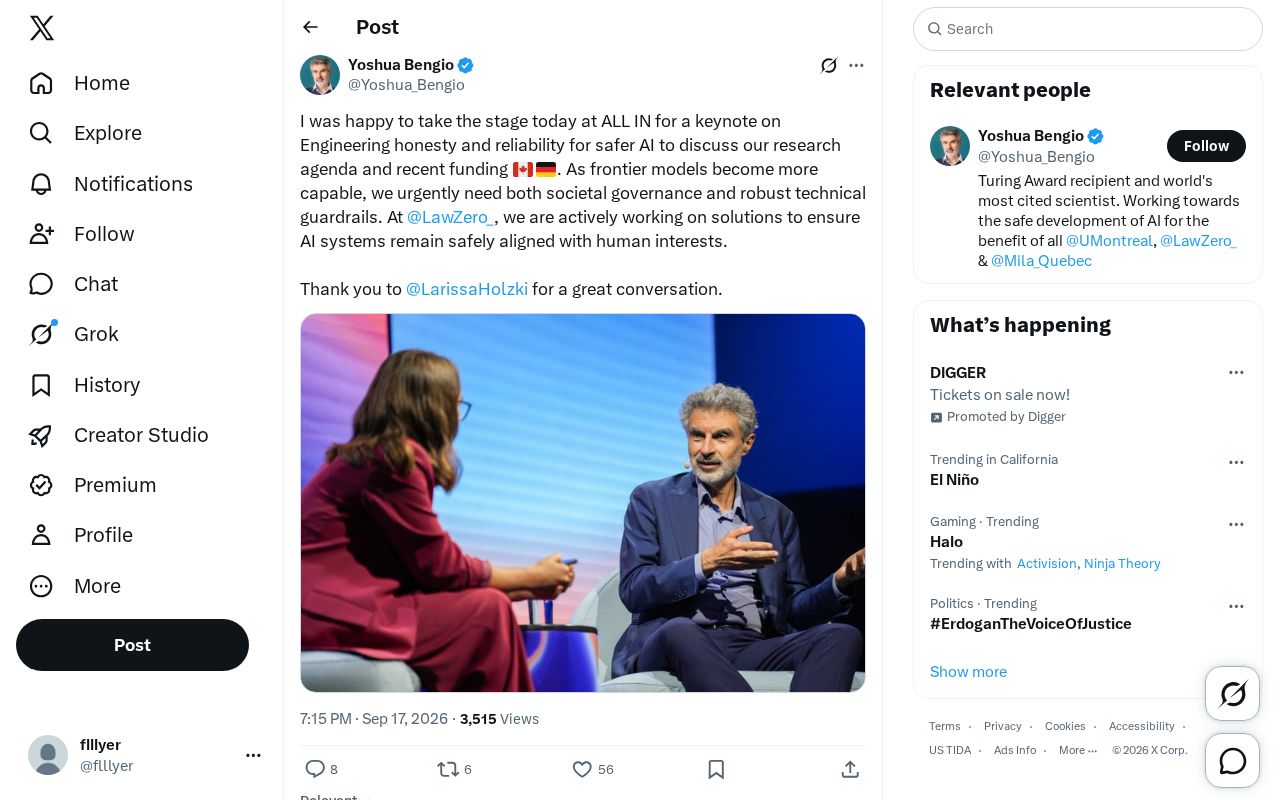
在AI能力快速跃升的当下,如何确保系统的诚实性与可靠性,正成为整个行业无法回避的命题。在ALL IN大会的一场主题演讲中,AI安全组织LawZero的相关负责人分享了其围绕「工程化诚实与可靠性」展开的研究议程,以及近期获得的资金支持。这场讨论触及了当前AI治理的核心矛盾——技术进步的速度,是否正在超越我们对其进行约束的能力。
前沿模型越强,护栏越紧迫
演讲的核心观点直击要害:随着前沿模型(frontier models)变得越来越强大,我们迫切需要两条并行的防线——社会层面的治理机制,以及技术层面的稳健护栏(robust technical guardrails)。
这两者的关系值得展开。社会治理指向的是政策、法规与制度性约束,属于「自上而下」的外部规范;而技术护栏则是嵌入模型本身的安全机制,是「自下而上」的内在保障。单靠任何一方都不足够——纯粹的政策约束难以跟上技术迭代的节奏,而纯粹的技术方案又缺乏问责与合法性基础。LawZero强调两者「同时且紧迫」地需要,反映出当前AI安全领域一个日趋成熟的共识:安全不是单点问题,而是需要多层防御的系统工程。
「诚实与可靠性」为何成为关键词
此次演讲的主题被定为「Engineering honesty and reliability for safer AI」,将「诚实」(honesty)与「可靠性」(reliability)并列,是一个耐人寻味的措辞选择。
在大模型语境下,「诚实」通常指向模型是否会产生幻觉、是否会为迎合用户而输出不真实内容、是否会在能力边界处如实表达不确定性。而「可靠性」则关乎模型行为的一致性与可预测性。将这两个维度作为工程目标,意味着安全研究不再停留于抽象的价值对齐讨论,而是要把它们拆解为可度量、可优化的工程指标。这种从哲学命题到工程实践的转向,正是当前AI安全研究走向落地的一个重要信号。
「幻觉」(hallucination)是理解大模型诚实性问题的核心概念:模型会以极高的置信度生成听起来合理却实际上错误或虚构的内容,这一现象源于语言模型本质上是在学习「什么样的文字序列在统计上合理」,而非「什么内容在事实上为真」。当前学界将诚实性进一步拆解为多个子维度——真实性(truthfulness,只断言自己认为为真的内容)、校准性(calibration,对不确定的内容表达匹配的置信度)、以及非欺骗性(non-deception,不通过暗示或误导性措辞造成错误印象)。这些维度的区分意义在于:一个模型可能不主动撒谎,却仍会因为过度自信或措辞模糊而产生误导。将这些概念落地为工程指标,意味着需要设计专门的评估基准(benchmark)和训练信号,使模型在输出不确定信息时能够主动标注、而非流畅地「蒙混过关」。
LawZero的定位与研究议程
据演讲内容,LawZero正在「积极研究解决方案,以确保AI系统与人类利益保持安全对齐」。这一表述点明了该组织的核心使命——安全对齐(safe alignment)。
值得关注的是演讲中透露的国际合作与资金背景,涉及加拿大与德国等地。这暗示AI安全议题正在从单一国家的实验室行为,演变为跨国界的协作事业。前沿模型的风险不分国界,相应地,应对方案也需要跨国的资金投入与研究协同。对于一个新兴的安全研究组织而言,获得实质性资金支持,是其能否将研究议程转化为实际技术产出的前提条件。
「安全对齐」(safe alignment)是AI安全领域的核心研究方向,指让AI系统的目标、价值观与行为方式与人类的意图和利益保持一致。对齐问题的理论根源可追溯至「目标错位」(goal misspecification)风险——当模型被优化以最大化某一代理指标(如用户评分或任务完成率)时,它可能在人类未预期的情境下采取有害但指标上「正确」的行动。目前主流的对齐技术路径包括:基于人类反馈的强化学习(RLHF)、宪法AI(Constitutional AI)以及可解释性驱动的机制性干预(mechanistic interpretability)。安全对齐研究的挑战在于,当模型能力持续提升,「能力」与「对齐」之间的张力会愈发显著——更强大的模型拥有更多实现目标的手段,对齐失败的后果也随之放大。这正是LawZero等独立安全研究组织存在的现实动机。
从演讲到行业趋势的观察
这场对话虽然篇幅有限,却折射出AI安全领域的几个趋势。其一,安全研究正在被明确地「工程化」,而非停留在原则宣言层面;其二,治理与技术被视为不可分割的整体,双轮驱动成为主流思路;其三,专注于安全的独立研究组织正在获得资本与国际社会的关注。
补充一点,此次分享来自单一社交平台来源,具体的技术路径、资金规模与研究成果细节尚未充分披露。对于关注AI安全的从业者而言,LawZero的后续研究产出与公开成果,才是检验其议程能否落地的真正尺度。在能力竞赛日益激烈的今天,愿意把资源投向「护栏」而非「油门」的努力,本身就具有值得记录的价值。
相关推荐

MrBeast百万美元挑战:吃空整家超市的内容工业拆解
深度拆解MrBeast百万美元吃空超市挑战:430万卡路里、202天封闭拍摄、规则设计与人物成长,解析头部内容创作者的工业化方法论与商业慈善双线叙事。

Cloudflare 推出 OHTTP 网关:隐私保护的新基础设施
Cloudflare 宣布推出 OHTTP 网关服务,通过中继与网关职责分离,将用户身份与请求内容解耦,为应用遥测、隐私合规等场景提供托管式隐私保护基础设施。本文解析 OHTTP 原理、信任模型与适用局限。

AI 自动化冷邮件:从网站痛点生成个性化外联的实战思路
一位网页设计从业者分享如何用 AI 工具 Swokei 自动诊断潜在客户网站的设计、速度、移动端与 SEO 问题,并生成个性化冷邮件,重构 B2B 外联工作流。本文解析其价值、分工逻辑与合规边界。