AI编程Agent横评:Claude Code、Codex、Devin谁更强
横评主流AI编程Agent:Claude Code最聪明但最贵,Codex性价比突出,混搭使用是当下最优策略。
AI编程Agent已从交互式助手演进为可后台自主运行的云端智能体。根据Artificial Analysis编程Agent指数,Claude Code以66分领先,Codex和Devin以62分紧随,但Claude Code单任务成本高达13美元,是Codex(Sol)的4倍以上。用户规模方面,ChatGPT和Gemini以周/月活9亿级别占据入口优势,而Claude Code凭借专业开发者付费意愿实现约25亿美元年化营收。评测建议按场景选型:复杂代码库选Claude Code,追求低价选Codex,全权托管选Devin,免费方案选Gemini。最优解是组合使用——一个Agent负责编写,另一个负责交叉验证,兼顾成本与质量。
AI编程助手已经从单纯的对话工具,演变为能够独立完成任务的智能体(Agent)。这些新一代工具不再只是给你建议,而是真正地替你写代码、改Bug、跑测试——有些甚至能在云端的独立机器上持续工作,不需要你盯着屏幕。本文基于一场主流AI编程Agent的横向评测,从智能程度、成本和用户规模三个维度,拆解各家产品的真实表现。
云端Agent新浪潮:边睡边干活
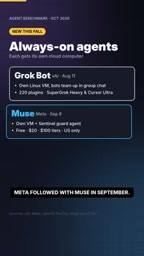
当下最值得关注的变化,是一批全新的云端Agent登场。它们不再依附于你的本地IDE,而是运行在云端的独立计算环境里,可以在你休息时继续推进任务。
据评测视频梳理,这一波云端Agent的节奏相当密集:xAI先推出了Grokbot,Meta紧随其后发布了Muse,而OpenAI则直接把一个名为DOTS的Agent嵌入了ChatGPT内部。
这种「后台持续运行」的模式,代表了AI编程工具的一个重要方向:从交互式助手转向自主执行的数字员工。你给它一个任务,它自己规划、自己动手,完成后再回来向你汇报结果。
云端Agent与传统IDE插件(如GitHub Copilot早期形态)的本质区别在于执行环境的独立性。传统编程助手依附于开发者本地的代码编辑器,每次交互都需要人工触发并等待响应;而云端Agent拥有自己的沙箱计算环境,能够自主调用终端命令、运行测试、读写文件,甚至通过浏览器查阅文档。这种架构让Agent得以执行跨越数小时的长任务,而不受本地网络波动或机器休眠的影响。从技术层面看,大多数云端Agent基于"工具调用"(Tool Use)能力构建——大型语言模型不再只输出文本,而是输出结构化的操作指令,由外部执行引擎代为完成实际操作,结果再反馈回模型进行下一步判断,形成完整的感知-规划-执行循环。
智能程度排名:Claude Code登顶
衡量一个编程Agent聪不聪明,最直接的指标是它能否真正解决复杂的编码问题。根据Artificial Analysis发布的编程Agent指数(Coding Agent Index),各家产品的得分排序如下:
- Claude Code(运行Opus 5.5):66分,位居榜首
- Codex(GPT-6 Astra) 与 Devin:62分,紧随其后
- Codex(Sol):57分
- Grok Build:56分
从这组数据看,Claude Code在处理编码任务上保持了明显的领先,而Codex和Devin构成了第二梯队。值得关注的是,同一个Codex在搭配不同底层模型(Astra与Sol)时,分数差距达到5分,说明底层模型的选择对最终表现影响巨大。
Artificial Analysis的编程Agent指数(Coding Agent Index)是目前业内较具参考价值的第三方基准测试之一,其评测体系主要基于SWE-bench等标准化任务集。SWE-bench从GitHub真实开源项目中抽取已修复的Bug,要求Agent在不知晓标准答案的情况下,独立定位问题并提交可通过测试的代码补丁。这类基准的优势在于贴近真实工程场景,而非合成题目;但也存在局限:它更侧重"修复孤立Bug"的能力,对"从零构建新功能"或"理解超大规模代码库"等场景的覆盖相对有限。因此,排行榜上的分数可作为能力参考,但不能完全等同于某款Agent在具体项目中的实际表现。
成本账:聪明从来不便宜
能力强不等于划算。评测特别对比了各家Agent完成单个任务的平均成本和耗时,这组数据对实际使用决策尤为关键。
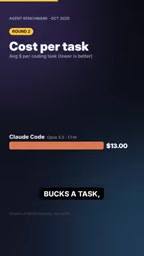
- Claude Code:平均每个任务约13美元,耗时约1小时
- Codex(Astra):每任务7.47美元,30分钟以内完成
- Codex(Sol):每任务仅2.99美元
这里出现了明显的性价比分化。Claude Code虽然最聪明,但单任务成本是Codex(Sol)的四倍多,速度也更慢。对于追求效率和预算控制的团队来说,Codex在速度与价格上的优势相当突出。
从订阅模式看,Anti-gravity、OpenClaw广告和Meta的Muse都提供免费层级;大多数付费方案集中在每月20美元左右;而面向重度场景的Grokbot或DOTS类Agent,则可能达到每次操作100美元的量级。这意味着使用成本的跨度极大,选型时必须结合任务强度来算总账。
用户规模:谁在被真正使用
技术指标之外,用户基数反映了产品的真实市场接受度。
- ChatGPT:每周9亿活跃用户
- Gemini App:每月9亿活跃用户
- Muse:冲到美国App Store第二名
- OpenClaw:320万活跃用户
- Codex:每周超200万用户
- Claude Code:到评测提及的时间点,年化营收约25亿美元
这组数字说明,综合型入口(ChatGPT、Gemini)仍然占据绝对的用户体量,而专注编程的Agent虽然用户基数相对小,但变现能力惊人——Claude Code约25亿美元的年化营收,印证了专业开发者愿意为高质量工具付费。
怎么选:按场景对号入座
没有一个Agent能通吃所有场景。评测给出了相当实用的选型建议:
- 大型、混乱的代码库 → Claude Code,它在复杂工程上最可靠
- 追求速度和低价 → Codex
- 想直接把整个任务甩手交出去 → Devin
- 追求每美元产出最大化 → Grok Build
- 想要免费方案 → Gemini
- 想在自己的机器上运行 → OpenClaw
- 需要后台持续工作的助手 → Muse、DOTS 或 Grokbot
最聪明的用法是「混搭」
评测给出的一个核心洞察是:最优解往往不是选一个,而是组合使用。让一个Agent负责规划和编写,再让另一个Agent去检查和验证它的工作。这种「交叉校验」的工作流,既能利用高性价比工具降低成本,又能借助高智能工具把关质量。
对于开发者而言,这意味着未来的编程工作流可能不再是「选定一款工具」,而是像管理一支团队那样,把不同Agent安排到最适合它们的岗位上。
Devin是由Cognition AI开发的全托管编程Agent,其设计哲学是让用户以自然语言描述需求,由Agent全程接管后续所有技术决策——包括技术选型、架构设计、代码实现和测试验证。与其他Agent更多定位于"辅助开发者"不同,Devin的目标更接近于替代初级工程师完成完整工作单元。OpenClaw则侧重于本地部署场景,允许Agent直接访问用户自己机器上的文件和工具,适合对数据隐私或网络环境有严格要求的企业用户。理解这些产品的定位差异,有助于在混搭策略中为每个Agent分配最匹配的任务类型,而非仅凭排行榜分数做决策。
结语
AI编程Agent的竞争已经进入白热化,各家在智能、成本、生态上各有侧重。Claude Code代表能力天花板,Codex主打性价比,Devin强调全权托管,Grok Build追求每美元效率,而云端Agent则在重新定义「助手」的边界。与其纠结哪个最强,不如根据自己的代码库规模、预算和工作习惯做组合选择——这或许才是当下最务实的答案。
相关推荐

谷歌AMIE临床研究登上《柳叶刀》:AI问诊首次真实诊所验证
谷歌与BIDMC合作的AMIE对话式诊断AI研究登上《柳叶刀》主刊,首次在真实诊所前瞻性验证。鉴别诊断与医生吻合率达90%,75%病例帮助医生准备问诊,开创患者端AI问诊临床落地新路径。

自然语言 vs SQL:AI 驱动数据可视化的变革
探讨 AI 驱动的数据分析如何用自然语言替代传统 SQL 进行数据可视化,分析两种方式的优势、局限与融合趋势,以及对企业数据团队角色的影响。

NVIDIA Megatron Core实现位级确定性预训练解析
NVIDIA Megatron Core引入位级确定性预训练能力,让大规模模型训练在调试、验证与恢复中实现逐位可复现。本文解析位级确定性的原理、技术挑战及其对AI工程实践的意义。