AI编程Agent能写代码,但谁来掌控代码之后的命运?

AI编程Agent写代码已不是难题,真正的挑战是如何通过工程控制平面治理Agent行为边界与生产权限。
随着AI编程Agent能力成熟,行业讨论的焦点已从"Agent能否写代码"转向"代码写完后由谁掌控"。自主Agent在实际运行中存在无限重试、技术正确但业务错误、权限过度、验证片面通过、缺乏人工决策节点等六类失控风险,核心问题往往不在代码生成阶段,而在变更完成后的推进过程中。为此,业界倾向于将Agent的执行能力与推向生产的权力显式分离,通过引入"工程控制平面"来统一管理身份与权限、任务边界、重试恢复、可审计性和人工审批。一种务实的分层授权策略是:在个人分支和沙箱中给予Agent较高自主度,越接近生产环境则门槛越高。这标志着行业心态从追问Agent能力,转向构建围绕Agent的治理、约束与问责体系。
当Agent能改代码,真正的问题才刚开始
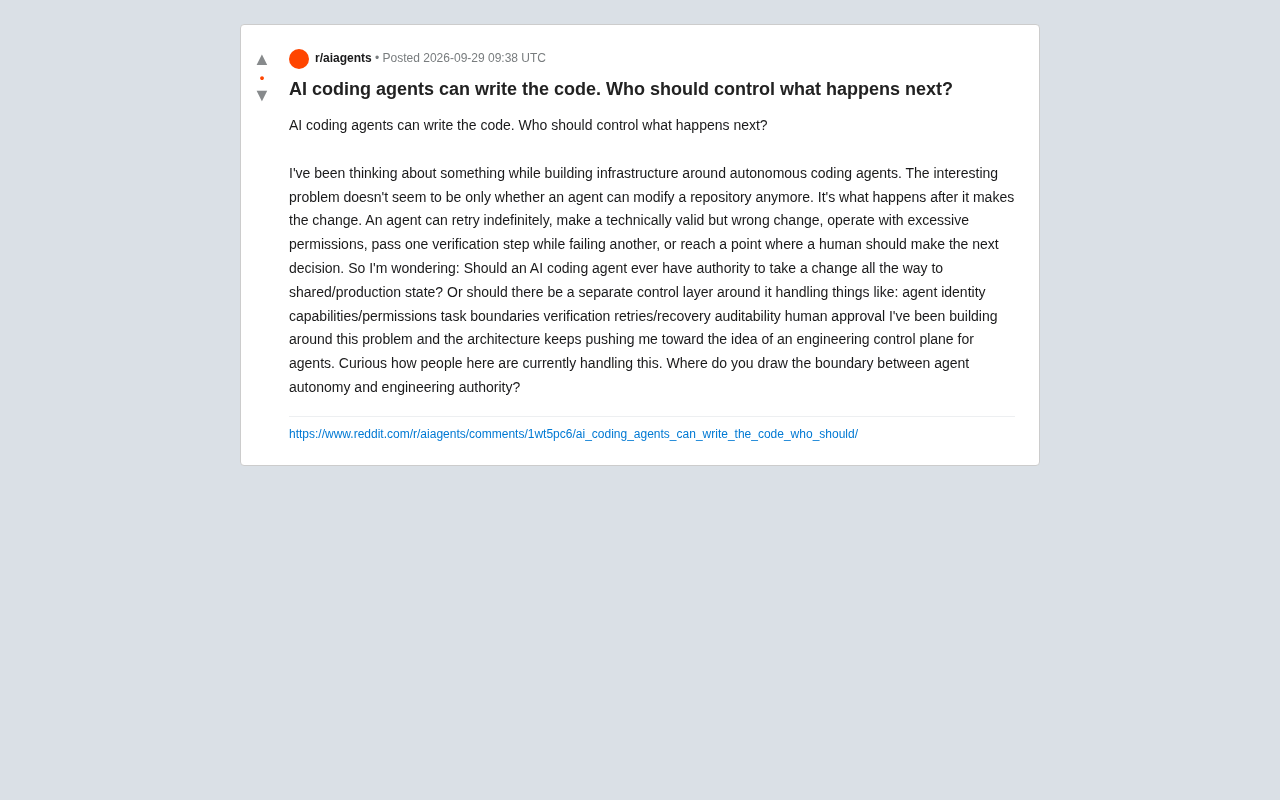
随着AI编程Agent的能力越来越强,很多团队正在从"Agent能不能修改代码仓库"的讨论,转向一个更深层的问题:Agent做出改动之后,究竟应该由谁来控制接下来发生的事情?
一位正在为自主编程Agent构建基础设施的开发者在Reddit上抛出了这个话题。他的核心观察很有意思——今天的技术焦点不再是Agent能否写代码,而是当它已经完成一次代码变更后,整个工程流程该如何应对随之而来的风险与不确定性。
Agent自主性带来的六类失控风险
原帖作者列举了自主Agent在实际运行中可能出现的几种典型问题,这些问题恰恰暴露了纯粹依赖Agent自主性的脆弱之处:
- 无限重试:Agent可能陷入反复尝试的循环,不断消耗资源却无法真正解决问题。
- 技术正确但业务错误的改动:代码在语法和编译层面完全合法,但在业务逻辑上却是错的。
- 权限过度:Agent以超出任务实际所需的权限运行,扩大了潜在破坏面。
- 验证的片面通过:通过了某一步验证,却在另一步失败——单点校验无法保证整体正确。
- 需要人类介入的决策点:某些关键抉择本就应该由人来拍板,而非交给Agent。
这些场景的共同点在于:问题往往不出在"写代码"这一步,而出在代码写完之后的推进过程中。 一个能自主重试、自主提交的Agent,如果缺乏外部约束,很容易把一个看似合理的错误一路推向共享环境甚至生产环境。
Agent应该拥有推向生产环境的权力吗?
这是原帖提出的最尖锐的问题:AI编程Agent是否应该拥有把一次变更一路带到共享/生产状态的权限?
从工程治理的角度看,答案倾向于否定。生产环境的变更牵涉稳定性、安全性和责任归属,把最终的"发布权"完全交给一个可能犯下技术正确但业务错误的自动化系统,风险显然过高。这也解释了为什么越来越多的实践者开始思考:Agent的"能力"和"权力"应当分离——它可以生成、修改、验证代码,但推向生产的授权应该被独立管控。
"技术正确但业务错误"是AI编程Agent最难被自动检测的失效模式之一。传统的CI/CD流水线中,自动化验证主要覆盖语法合规、单元测试通过、代码风格等可形式化的规则,而业务逻辑的正确性往往依赖上下文理解和领域知识,难以被测试用例完整覆盖。例如,一个Agent可能将某个计费模块的精度从浮点数改为整数以消除编译警告,代码完全合法,所有现有测试通过,但实际上破坏了金融计算的精度要求。这类问题在人工代码审查中通常会被有经验的工程师捕捉,但在Agent自主提交的场景下,若缺乏强制的人工审批节点,此类变更可能在无人察觉的情况下进入生产环境。这也是为什么"技术验证"和"业务验证"需要被视为两个独立的门控(gate)来设计。
为Agent设计一个"工程控制平面"
原帖作者提到,他在构建过程中,架构不断把他推向一个方向:为Agent引入一个工程控制平面(engineering control plane)。这个独立的控制层不负责写代码,而是专门管理Agent行为的边界与治理,具体包括:
身份与权限
为每个Agent建立明确的**身份(identity)和能力/权限(capabilities/permissions)**边界,确保它只能访问和操作任务真正需要的资源,避免权限过度。
任务边界与验证
通过**任务边界(task boundaries)限定Agent的作用范围,并用完整的验证(verification)**机制取代单点校验,防止"通过一步却失败另一步"的问题。
恢复与重试控制
对**重试与恢复(retries/recovery)**进行统一管理,避免Agent陷入无限循环,在失败时能够安全回退。
可审计性与人工审批
所有Agent行为都应具备可审计性(auditability),关键节点则插入**人工审批(human approval)**环节,把最终决策权交还给工程师。
这套控制平面的本质,是在Agent的自主执行能力之外,叠加一层工程权威(engineering authority)——Agent负责"做",控制平面负责"允许做到什么程度"。
"控制平面"(Control Plane)这一概念源自网络工程与云计算领域——在软件定义网络(SDN)中,控制平面负责制定路由决策和策略,而数据平面负责实际的数据包转发。两者分离的设计哲学在于:让执行层保持高效,让治理层保持权威。Kubernetes等现代容器编排系统同样采用这一架构,其控制平面(API Server、Scheduler、Controller Manager)负责管理集群状态和调度决策,而工作节点只负责运行容器。将这一模式引入AI Agent治理,意味着Agent的"执行能力"与"行为授权"被显式解耦:Agent可以拥有强大的代码生成与修改能力,但每一个影响共享状态的行动,都必须经过控制平面的策略校验与授权确认。这种设计在赋予Agent自主性的同时,为工程团队保留了可观测性和可干预性。
自主性与工程权威的边界在哪里
原帖最后向社区抛出的问题极具代表性:你在Agent的自主性和工程权威之间,把边界划在哪里?
这其实是当前AI辅助软件工程领域尚无统一答案的开放议题。一种务实的思路是按"影响范围"分层授权:在个人分支、沙箱环境中给予Agent较高的自主度,让它自由试错;而越接近共享代码库和生产环境,人工审批和验证的门槛就应该越高。
值得关注的是,这个讨论标志着行业心态的转变——从追问"Agent能力有多强",转向思考"如何安全地驾驭这种能力"。当代码生成本身逐渐成为解决方案,真正稀缺的能力,或许是围绕Agent构建的那套治理、约束与问责体系。
结语
AI编程Agent已经能够胜任写代码的工作,但让它们安全地融入真实的工程流程,需要的远不止更强的模型。身份、权限、任务边界、验证、恢复、审计、人工审批——这些看似传统的工程治理要素,正在自主Agent时代被重新赋予关键意义。谁来掌控代码写完之后的命运,将成为决定AI能否真正规模化落地软件工程的核心命题。
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。