AI编程Agent排名:Claude Code、Codex、Cursor谁更强?
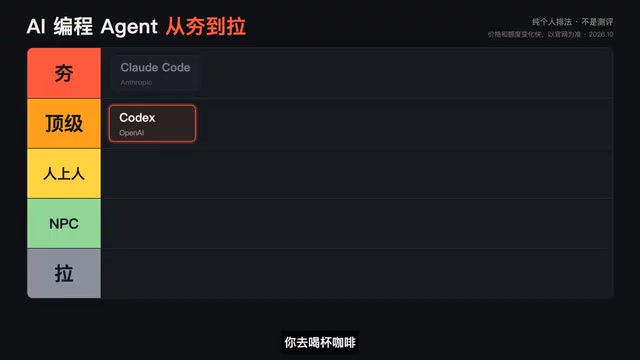
B站UP主实测十款AI编程Agent排名,按能力与成本分档给出选型建议。
文章整理B站UP主「从夯到拉」对十款热门AI编程Agent的个人向排名。Claude Code因能稳定跑完几十步长任务居首,UP主用它跑通完整视频字幕流水线;Codex凭云端并行多任务位列顶级,且ChatGPT订阅自带。第二梯队是编辑器手感的Cursor与生态绑定的GitHub Copilot,后者6月起改为按用量扣额度,重度Agent场景成本优势削弱。第三梯队包括开源自选API的OpenCode与Client、免费但限额的Google AntiGravity、文档先行的亚马逊Kiro,以及改名的Devindex。Gemini CLI因Google对个人用户停服而垫底。结论是按场景选型,并先用真实任务做成本测试。
AI编程Agent的混战已经进入白热化阶段。B站UP主「从夯到拉」发布了一份个人向排名,把当下最热的十款工具掰开揉碎排了个座次。这不是一份严谨的评测报告,而是一个重度用户用实际项目跑出来的体感总结。对于正在选型的人来说,这种一手经验往往比参数表更有参考价值。
第一梯队:能扛长活的「夯」
Claude Code:长任务之王
UP主把Claude Code排在首位,核心理由只有一个:能扛长活。给一个需要跑几十步的任务,它能一路干完,中间出错还会自己回头修。终端、桌面、网页三端通用,代价是需要购买Claude付费套餐。
最有力的证据来自实际生产场景:UP主用它跑通了一整条视频字幕流水线,从下载、转写、翻译到压字幕全部由它完成。这种多步骤串联任务的稳定性,是衡量Agent能力的关键指标。
AI编程Agent与传统的代码补全工具(如早期Copilot)有本质区别:补全工具只在你敲代码时提供下一行建议,而Agent能自主规划、调用工具(读写文件、执行命令、搜索网页),并根据执行结果调整下一步动作。所谓「长任务」,通常指需要数十次工具调用、跨多个文件甚至多个系统的任务链,比如「下载视频→语音转写→机器翻译→生成字幕文件→压制到视频里」。这类任务对Agent的容错能力要求极高:中间任何一步失败,它必须能识别错误、回退并换一种方式重试,而不是把错误状态继续传递下去。因此评估Agent时,「单步代码质量」远不如「多步流程的完成率与自愈能力」重要。
Codex:云端并行的高手
OpenAI的Codex被放在顶级档位,差异化优势在于云端同时开多个任务并航跑。据UP主描述,「你去喝杯咖啡回来收结果就行」,并且ChatGPT订阅就自带这项能力。对于需要批量处理小任务的场景,这种并行模式能显著压缩等待时间。
云端Agent与本地IDE内Agent的运行模式差异,决定了它们适合的任务类型。本地Agent运行在你自己的机器上,能直接访问本地文件和开发环境,但同一时间基本只能处理一个任务,且会占用你的终端或编辑器。云端Agent则把任务放到远程沙箱容器中执行,每个任务独立隔离,因此可以同时开多个并航跑,互不干扰,完成后把改动以分支或PR的形式交回。这种模式特别适合「批量小任务」——比如同时给十个模块补测试、批量升级依赖版本、并行修复多个lint告警。代价是云端环境与你本地环境的差异可能带来额外调试成本,涉及私有依赖或本地数据的任务也不适合放上去。
第二梯队:手感与生态的「人上人」
Cursor:编辑器里的顺手之选
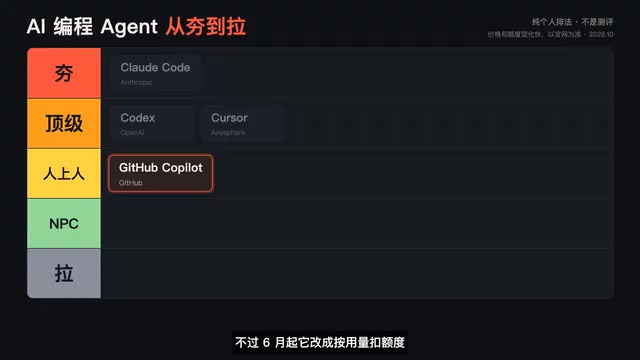
Cursor是基于VS Code改造的AI编辑器,UP主给它的评价是「写代码时的手感最顺」,并且支持Claude、GPT、Gemini等模型随意切换。对于习惯在IDE里工作的开发者,Cursor的迁移成本最低,日常编码体验也最流畅。
GitHub Copilot:老牌选手的变数
GitHub Copilot的优势在于入门价最便宜,且与GitHub生态绑定最紧——在PR里直接让它改代码、做Review都很方便。但UP主指出了一个重要变化:6月起它改成按用量扣额度,用Agent模式跑大任务时额度掉得挺快。这意味着轻度使用依然划算,重度Agent场景的成本优势正在削弱。
第三梯队:自由与代价并存的「人上人」
开源自选:OpenCode与Client
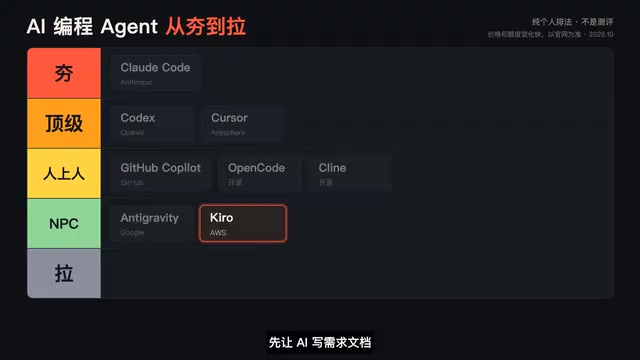
OpenCode是终端里的Agent,Client是VS Code插件,两者本身免费,用户自己接模型API,用多少付多少。好处是自由,坏处是「钱包得自己盯着」——UP主提醒,跑一个大任务可能比订阅还贵。
自带API Key(BYOK) 模式是开源Agent工具的典型形态:工具本身不收费,用户填入自己的模型API Key,按token用量向模型厂商付费。这种模式的优势是模型可自由选择、数据不经第三方中转、没有订阅额度上限;劣势是成本完全暴露且波动大——Agent跑长任务时会反复读取上下文、多次调用工具,一次任务消耗几十万甚至上百万token并不罕见,遇到模型涨价或反复重试,账单可能远超固定订阅费。此外,BYOK还意味着你要自己承担限流、密钥管理和可用性问题的责任。对个人开发者,建议先用小任务测出单次任务的token成本,再估算月度预算是否真的低于订阅制。
Google AntiGravity:免费但有限制
AntiGravity免费就能用,上手也简单,但额度限制经常让人用到一半被卡住。免费策略拉低了门槛,却难以支撑持续的重度使用。
亚马逊Kiro:文档先行的思路
Kiro的思路值得单独一说:先让AI写需求文档,再按文档写代码,适合认真做项目的团队。但它按积分收费,一个功能做下来积分掉得不少,成本需要提前算账。
规格驱动开发(Spec-driven Development) 是Kiro背后的核心方法论:不让AI直接根据一句模糊需求开始写代码,而是先生成结构化的需求文档、技术设计文档和任务清单,经人确认后再逐项实现。这与「 vibe coding」式的即兴生成形成对照,目的是解决AI生成代码时常见的需求漂移、架构混乱和难以维护问题。代价是前期需要更多人工评审与确认环节,流程更重,不适合一次性的脚本或原型。按积分(credit)计费的模式则意味着成本与流程步骤强相关——文档、设计、实现每个阶段都消耗积分,功能越复杂、返工越多,积分消耗越快,因此选型时需要把流程开销一并计入预算。
Devindex:改名带来的认知混乱
Devindex就是以前的WinSurf,今年6月改名,连带的Agent也换掉了。UP主提到,很多老用户到现在还没认出来。品牌更迭对用户认知的伤害,在这个案例里体现得很明显。
垫底:被停服拖累的Gemini CLI
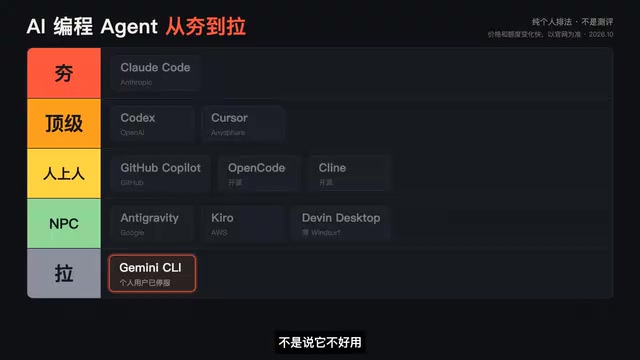
Gemini CLI排在最末,原因不是不好用,而是从今年6月18号起Google对个人用户直接停服,免费用户和Google AI订阅用户都得搬到AntiGravity CLI。工具本身的能力再强,用不了就只能垫底。
选型建议:按场景对号入座
UP主给出的总结很直接:想让AI自己扛长任务,选Claude Code;想并行跑一堆小任务,选Codex;想在编辑器里顺手写,选Cursor;预算敏感,从Copilot或开源的OpenCode、Client开始。
这份排名的价值不在于绝对正确,而在于它把「能力」和「成本」放在一起权衡。Agent工具的竞争已经从「能不能写代码」进入「能不能稳定跑完长流程」和「跑完要花多少钱」的阶段。对于团队选型,建议先用真实任务跑一轮成本测试,再决定押注哪个工具。
你正在用哪个?又会把它排在哪一档?
相关推荐

用十几个Agent搭建黑灯工厂:Lauren Tan的信任阶梯与米其林厨房
Lauren Tan分享用十几个协调Agent每月合并超2500个PR的实战经验:从信任阶梯、米其林厨房隐喻到验证技能与内外循环连接,揭示黑灯工厂背后的环境工程哲学。

GPT-6.1 Terra深度解读:中端模型的视觉与电脑使用定位
OpenAI发布GPT-6.1 Terra,主打视觉推理与电脑操作,定价介于旗舰Sol与轻量Luna之间。本文解读其中端定位、定价策略、适用场景及推理等级实测表现。

OntoGr:为Agent记忆加上引用溯源与双时间轴
OntoGr Agent Memory 是一个开源 Python 库,为 AI Agent 记忆中的每条事实保留逐字引用、来源与双时间轴,支持可逆实体消解、冲突裁决与四路召回检索,解决 Agent 记忆的信任与可追溯问题。