AI编程工具20强大横评:Copilot/Cursor/Claude谁在裸泳?

B站UP主用七维加权矩阵为20款AI编程工具排出T0到T4梯队,强调场景匹配优于绝对排名。
文章基于B站UP主的评分矩阵,将20款主流AI编程工具分为T0到T4五个梯队:Claude Code与Codex以8.4分并列T0,Cursor(7.8)和Gemini(7.5)居T1,Kimi、Copilot、通义灵码等位于T2,Continue、Zed、百度Comet等列T3,T4仅两款未点名。评分采用七维加权:能力30%、常任务可靠性20%、耐操性15%、耐久性10%、成本可控10%、国内可用10%、模型体验5%。各维度尖子生不同:Claude Code和Codex能力与常任领先,Cursor粘性最高,Copilot耐久性最强,国产工具国内可用性突出。文章结论是榜单价值在于提供可复用评估框架,开发者应据大仓库重构、弱网、合规、预算等核心场景选型,而非追逐排名。
AI编程工具已经多到让人眼花缭乱,但到底哪些是生产力,哪些是“生产力幻觉”?一位B站UP主用一张评分矩阵表,对市面上20款主流AI编程工具做了从“夯”到“拉”的排序,并给出了详细的评分维度和权重。本文基于该视频内容,结合多源社区共识,为你拆解这份榜单背后的逻辑。
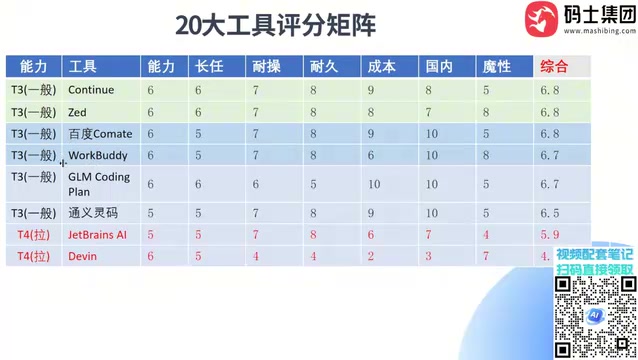
榜单速览:T0只有两款,T4仅两个
UP主将20款工具分为五个梯队:T0“夯”(顶配)、T1“准顶”(一线)、T2“主力”(日常可用)、T3“一般”(特定场景)、T4“拉”(不推荐)。
- T0(夯):Claude Code、Codex,综合评分均为8.4,未分高下。
- T1(准顶):Cursor(7.8)、Gemini(7.5)。
- T2(主力):Kimi、Kilo、通义灵码(原视频称“签问”)、Open Cloud Train、Copilot(原视频称“Couple Lauter”)、Adder、DeepSeek广告 Harness等,评分大多在7分左右。
- T3(一般):Continue、Zed、百度Comet、Workbody、GLM(原视频称“同义零码”)等。
- T4(拉):仅列入两款,未具体点名。
你可能没注意到,Workbody虽然近期热度很高,但由于其定位偏向AI办公文档与协同,而非纯编程,因此在编程维度得分不高。UP主也强调,若扩展到30款甚至40款,T4名单会更长。
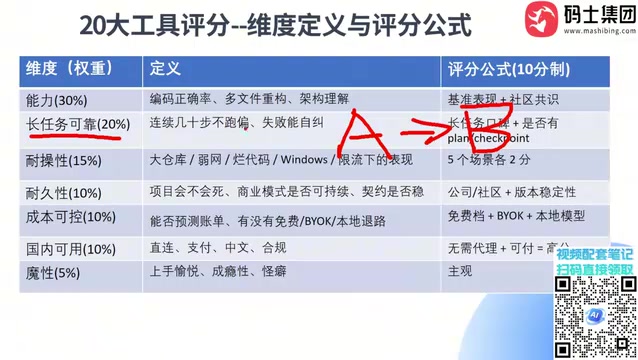
评分维度与权重:能力占三成,模型只占5%
这份榜单并非拍脑袋,而是基于七个维度的加权评分:
| 维度 | 权重 | 定义 |
|---|---|---|
| 能力 | 30% | 编码正确率、多文件重构、架构理解 |
| 常任(常任务可靠性) | 20% | 连续几十步任务不跑偏,出错能自我纠正 |
| 耐操性 | 15% | 大仓库、弱网、烂代码、Windows、限流下的表现 |
| 耐久性 | 10% | 工具背后公司/社区的存续能力与版本稳定性 |
| 成本可控 | 10% | 免费额度、BYOK、本地模型支持 |
| 国内可用 | 10% | 代理需求、支付便利、中文场景、企业合规 |
| 模型 | 5% | 主观体验:上手愉悦度、粘性、怪癖 |
能力:硬实力看基准+社区共识
能力维度占30%,核心是代码写得对不对、能否跨模块重构而不乱。评分依据公开基准测试成绩,同时参考AI社区和程序员社区的共识。没有公开成绩的工具很难在这一项拿高分。
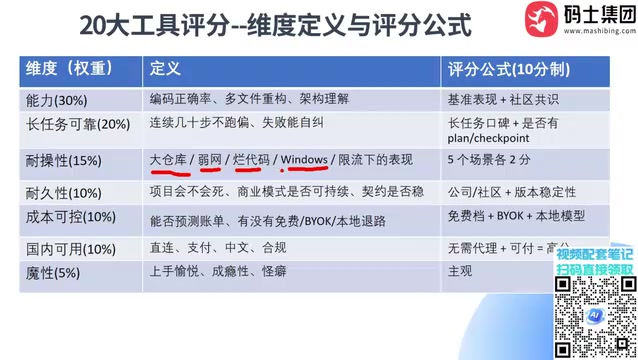
常任:长任务不跑偏才是真本事
“常任”指常任务可靠性,权重20%。典型场景是把老代码从A框架迁移到B框架,并跑通所有测试——连续几十步操作,工具会不会“跑偏”?出错后能否自我发现并纠正?由于缺乏基准测试,UP主主要看社区口碑,以及工具源码/架构中是否有计划检查(plan/checkpoint)机制。
plan/checkpoint 机制 是衡量长任务可靠性的关键工程手段。plan 指工具在执行多步任务前先生成显式计划,把大目标拆成可验证的子步骤;checkpoint 指在关键节点保存状态,一旦后续步骤失败或偏离,可以回滚到最近检查点重试。具备这类机制的工具在迁移、重构等连续几十步的场景中更不容易“跑偏”,出错后也能自我发现并纠正。原文把源码/架构中是否存在该机制作为“常任”维度的评分依据之一,原因就在于此。
耐操性:五个场景取两个最高分
耐操性权重15%,考察五个场景:十万行以上大仓库中定位修改点、弱网/断网/需代理环境、历史遗留烂代码、Windows路径与终端兼容性、API限流下的报错与恢复能力。由于没有工具能全能,评分时取两个最高分场景。
API 限流 指模型服务商对单位时间内的请求次数或 token 用量设上限,超限后返回 429 等错误。在 AI 编程工具中,限流会直接打断长任务:工具若不能识别限流信号、退避重试或降级到备用模型,就会表现为卡死或任务中断。榜单把“API 限流下的报错与恢复能力”列为耐操性的五个场景之一,考察的正是工具在额度受限时的容错设计,这对使用免费额度或共享团队 Key 的开发者尤为实际。
耐久性:公司会不会倒,版本稳不稳
耐久性权重10%,看工具背后的公司或开源团队。大厂(微软、Google)和大型AI公司得分更高;刚发布的预览版(如DeepSeek Harness)因接口未稳定会拉低评分,但公司实力可部分抵消。
成本可控:免费、BYOK、本地模型
成本可控权重10%,评估是否有免费额度、是否支持BYOK(自带模型Key)、能否回退到本地私有化模型。本地模型可让边际成本趋近于零。
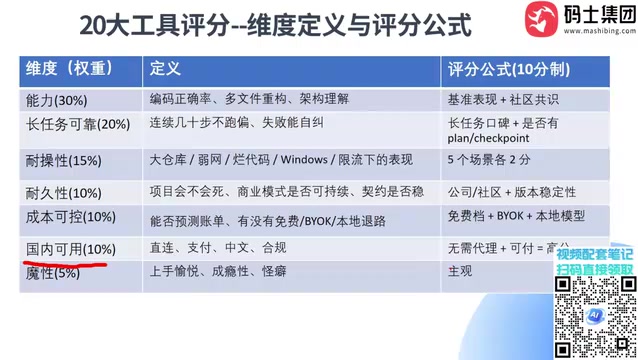
国内可用:代理、支付、中文、合规
国内可用权重10%,四个判断点:是否需要代理(代理有费用)、能否方便付款、中文场景表现、企业合规(代码是否上传境外服务器)。对国内开发者而言,这往往是决定性因素。
模型:主观但共鸣
模型权重仅5%,是非常主观的体验分:上手是否舒服、用起来是否“上瘾”、有没有怪癖。这一项容易引起共鸣,但对综合排名影响有限。
BYOK 是 Bring Your Own Key 的缩写,指用户自带大模型 API Key 接入编程工具。在此模式下,工具本身不转售模型调用额度,而是让用户直接向 OpenAI、Anthropic 或本地模型服务商付费。对开发者而言,BYOK 的意义在于成本透明、可切换模型、避免被单一工具绑定;对企业而言,则便于统一采购和审计。榜单把 BYOK 与免费额度、本地模型支持并列归入“成本可控”维度,正是因为这三者共同决定了长期使用的边际开销。
各维度尖子生:谁强在哪
- 能力与常任:Claude Code和Codex接近满分(部分单项接近10)。
- 用户粘性(模型):Cursor得分最高。
- 耐久性:Copilot(微软背书)最高。
- 国内可用:DeepSeek Harness、通义灵码等国产工具得分突出。
- T4“拉”:各项均无突出表现。
公开基准测试 在此处主要指评估代码生成能力的标准化数据集,如 HumanEval、MBPP、SWE-bench 等。它们用统一题目和自动判定给出可比较的分数,是“能力”维度 30% 权重的重要依据。但基准成绩存在局限:题目多为单文件或短上下文,难以覆盖十万行仓库重构、弱网、限流等真实场景,因此原文同时引入 AI 社区和程序员社区的共识,并对没有公开成绩的工具压低该项得分。理解这一点,才能明白为何榜单不把基准分数当作唯一标尺。
结论:没有完美工具,只有匹配场景
这份榜单的价值不在于争出第一,而在于提供一套可复用的评估框架。Claude Code和Codex在能力和长任务可靠性上领先,适合对代码质量要求高的生产环境;Cursor胜在体验和粘性;国产工具在国内可用性上占优;而定位办公协同的Workbody在编程维度得分低,并非工具本身差,而是场景错配。
UP主表示后续会逐个详细讲解每款工具的评分理由。对于开发者而言,与其追逐榜单,不如对照自己的核心场景(大仓库重构、弱网环境、合规要求、预算限制)去选择最匹配的工具。
(本文基于B站UP主视频内容整理,评分与观点归原作者所有。)
相关推荐

Agent Harness 已死?Cursor 早期工程师拆解 AI 编程代理真实架构
Cursor 早期工程师 Jediah 拆解 agent harness 的真实架构:为何「harness 已死」只对了一半,数据飞轮如何让 harness 自我淘汰,以及 Grokbot、软件工厂和原语设计如何打开 agent 的新前沿。

Python访问者模式与更优替代方案详解
深入解析Python访问者模式及四种替代方案:方法模式、模式匹配、字典映射与functools.singledispatch单分派。从节点与操作的双轴矩阵出发,帮你根据变化频率选择最合适的解耦设计。

357天深度体验:Omarchy为何让我告别发行版跳槽
连续使用 Omarchy 357 天的深度体验:59 秒安装、开箱即用的音频与 GPU 支持、Quattro 版本 QuickShell 重写带来的配置迁移阵痛,以及它为何值得 Arch 用户尝试。