AI编程工具Credits消耗过快?Astra6用户5分钟烧光2500点数引热议
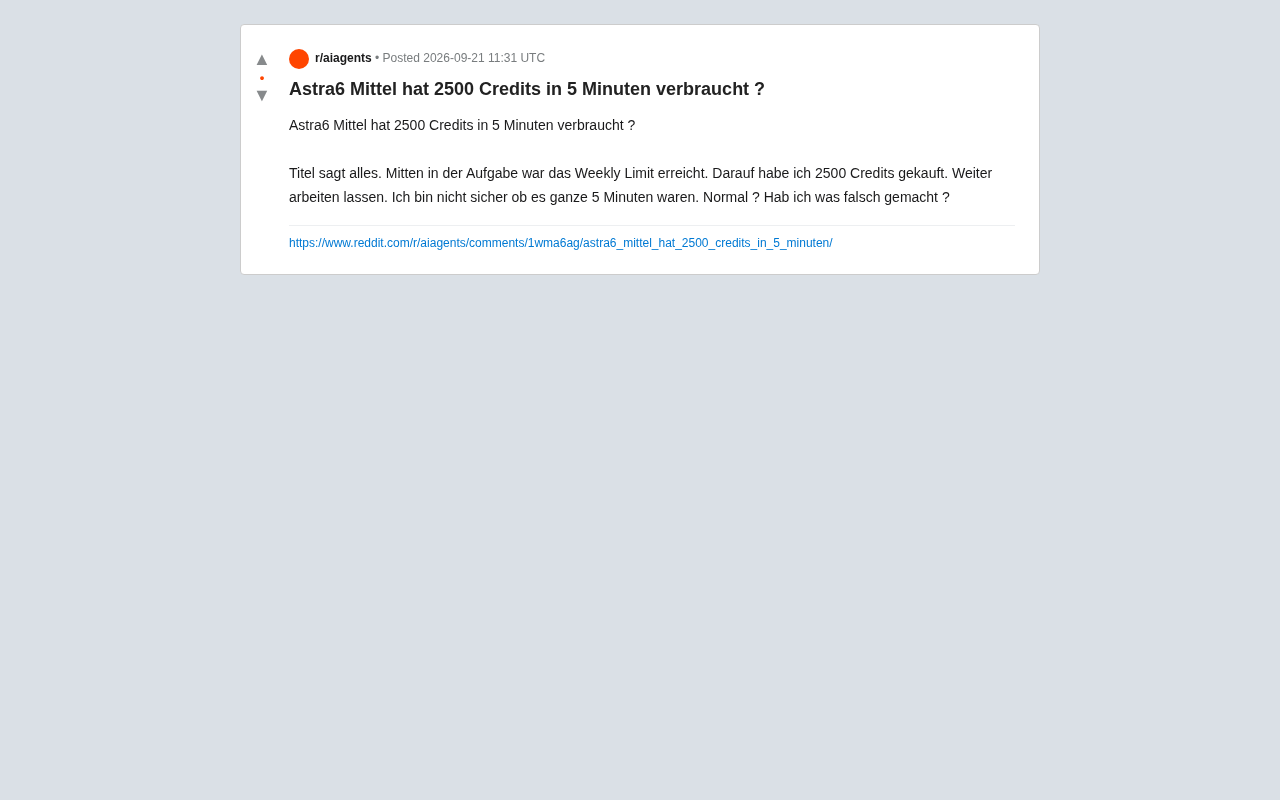
AI编程Agent自主执行任务时会触发海量模型调用,导致Credits在数分钟内耗尽,折射出行业计费透明度不足的痛点。
一位Reddit用户在使用AI编程工具Astra6时,购买的2500个Credits在约5分钟内全部耗尽,引发对计费机制是否合理的质疑。文章指出,这一现象的根源在于Agent自主执行模式:每完成一个子步骤都会独立调用模型,叠加高级模型的高单价与长上下文窗口带来的巨量token输入,短时间内产生数百次API调用完全可能。Credits弹性计费本身缺乏足够的实时透明度,用户在授权Agent"继续跑"时往往无从预判实际消耗。文章建议用户事先了解模型计费标准、设置消耗上限、分段处理复杂任务,同时呼吁厂商提供消费预警与实时用量看板,以重建用户信任。
一则来自Reddit的用户困惑
一位Reddit用户近日发帖描述了自己在使用AI编程助手Astra6时遇到的情况:任务进行到一半时触及了每周使用限额(Weekly Limit),于是他购买了2500个Credits继续工作,结果这些点数在大约5分钟内就被消耗殆尽。这位用户在帖子里发出了几乎每个AI工具重度用户都可能问出的疑问:"这正常吗?我是不是哪里操作错了?"
这条看似简单的求助帖,实际上折射出当前AI编程工具在计费模式上的一个普遍痛点:基于Credits(点数/额度)的消费机制,往往让用户难以直观感知自己的实际用量,从而在不知不觉中快速耗尽预算。
Credits机制为何让人"猝不及防"
目前主流的AI编程与Agent类工具,大多采用两种计费思路:一种是固定订阅制(每月固定费用,附带一定额度),另一种就是按Credits消费的弹性模式。后者的优势在于灵活,但劣势也同样明显——用户很难在操作前预估一次任务究竟会花掉多少点数。
对于像Astra6这类可能涉及自动化代理(Agent)执行的工具来说,一次"让它继续工作"的指令背后,可能触发大量的模型调用:反复读取上下文、多轮推理、调用外部工具、生成并修正代码等。每一步都在消耗Credits,而这些步骤对用户是相对不透明的。这正是2500点数能在5分钟内蒸发的技术根源。
高级模型 + 长上下文 = 高消耗
如果用户选择的是能力更强的"中档"或"高级"模型(原帖标题中的"Mittel"即德语"中等"之意),单次调用的成本本就更高。再叠加长上下文窗口、复杂任务的多步执行,Credits的消耗速度会呈现指数级放大。这也是为什么同样是5分钟,简单问答可能只花几个点数,而一个自主运行的编程任务却能烧掉数千点。
从底层原理来看,大语言模型的API定价通常以"token"为计量单位——token是模型处理文本的最小单元,大致对应中文半个词或英文约四分之三个单词。一次对话的总token数包括输入(上下文、指令、历史记录)与输出(模型生成的回复)两部分之和。当一个Agent执行编程任务时,每一轮调用都需要把完整的任务背景、已生成的代码、工具返回结果等全部打包送入模型,随着任务推进,输入token数会持续膨胀。主流长上下文模型的窗口已达10万至100万token,单次输入成本因此可以非常可观。Credits本质上是对token消耗量与模型档位的综合折算,高级模型每个token的折算比率往往比基础模型高出5到20倍,这正是复杂任务在短时间内耗尽大量点数的数学根源。
AI Agent(智能代理)是指被赋予一定自主决策能力的AI系统,它可以在无需用户逐步确认的情况下,自行规划子任务、调用外部工具(如代码执行器、搜索引擎、数据库接口)并根据结果调整下一步行动。与普通的"一问一答"对话不同,Agent的执行流程是循环迭代的:观察环境→思考下一步→执行动作→再观察,每个循环都会产生独立的模型调用。一次看似简单的"帮我修复这个Bug"指令,在Agent模式下可能演变为:读取代码库→定位错误→生成修复方案→执行测试→分析报错→再次修复……数十轮迭代全部独立计费。这种架构设计极大地提升了任务完成质量,但也使得成本预估变得极为困难,是Credits快速消耗的直接机制。
用户可能忽略的几个关键点
从这位用户的描述来看,有几个环节值得所有AI工具使用者引以为戒。
他在触及每周限额后立即购买了新的Credits包并让任务"继续跑",却没有先确认剩余任务的复杂度和预期消耗。当一个Agent被授权自主执行时,它不会主动为你"省钱"——它会尽可能完整地完成目标,哪怕这意味着大量的模型调用。
另外,"我不确定是否真的有5分钟"这句话也很关键。在自动化任务中,时间并不是衡量消耗的可靠指标,真正决定成本的是调用次数与token总量。短短几分钟内,一个高频运行的Agent完全可能完成上百次API调用。
这是否"正常"?
从技术角度看,这种消耗速度在特定场景下是可能出现的,未必是Bug或操作失误。但"技术上可能"不等于"计费设计合理"。用户之所以感到震惊,恰恰说明工具缺乏足够的用量提示与消费预警机制。一个成熟的产品,应当在大额消耗发生前给出明确提示,或提供实时的Credits消耗看板。
给AI工具用户的实用建议
结合这个案例,几条经验值得记住:
- 动手前先看计费说明:了解所用模型的单次调用大致成本,尤其是高级模型。
- 谨慎授权自主执行:Agent自动跑任务时,先设置消耗上限或分步确认,避免"一口气跑到底"。
- 关注用量面板:定期查看Credits余额与历史消耗,建立对自己用量的直觉。
- 对复杂任务分段处理:把大任务拆成小步骤,既能控制成本,也便于随时叫停。
结语:透明计费是AI工具的必修课
这位Reddit用户的遭遇并非个例,而是整个AI工具行业在商业化过程中普遍面临的信任问题。当计费机制对用户不够透明时,即便消耗"技术上正常",也会损害用户体验和信任感。
对厂商而言,提供清晰的消耗预警、实时用量展示和合理的默认保护,是降低这类困惑的关键。对用户而言,在拥抱AI自动化带来便利的同时,保持对成本的敏感和控制意识,同样必不可少。这场关于2500个Credits的讨论,或许能提醒更多人重新审视自己与AI工具之间的"消费关系"。
相关推荐
Jev:为软件自动化而生的结构化AI决策引擎
TypeSafe AI推出的Jev是一款专注软件自动化的结构化AI决策模型,直接输出类型化概率决策而非文本,响应速度70-500ms,宣称比传统LLM工作流快20-200倍、便宜40-400倍,现已无门槛开放。
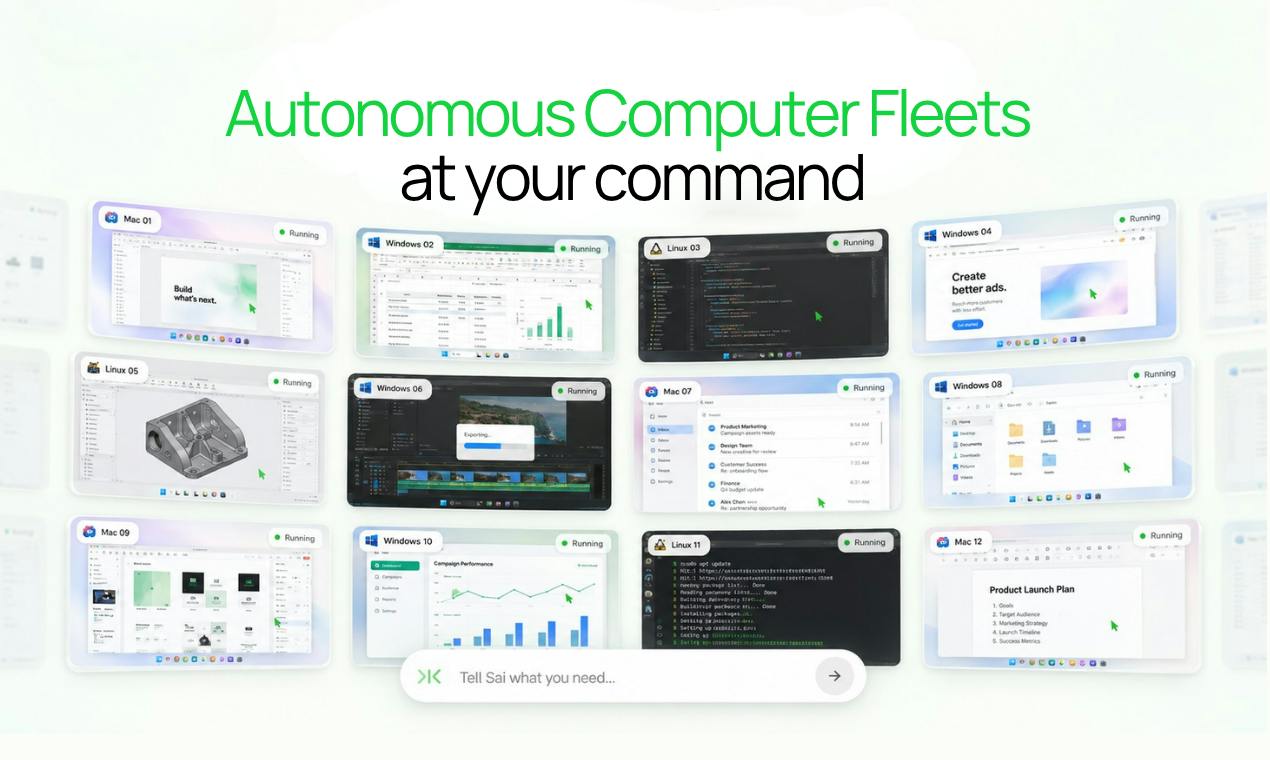
Sai:会像人一样操作电脑的自主智能体军团
Sai是Product Hunt上主打的自主电脑操作智能体,通过读屏、点击、输入等方式像真人一样操作软件,无需API即可自动化遗留系统与内部门户,支持Windows/macOS/Linux,OSWorld基准达73%。
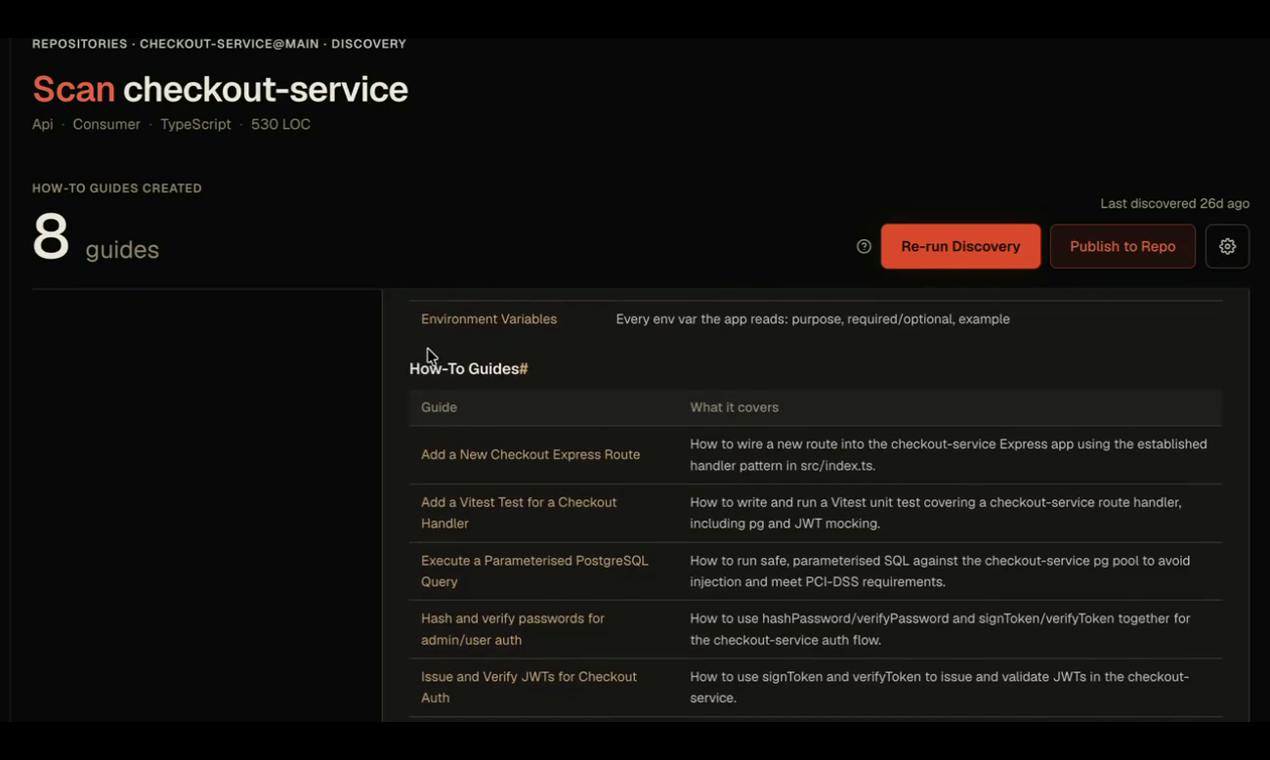
Hyrax AI:面向整个代码库的AI架构师
Hyrax AI 定位为面向整个代码库的AI架构师,它主动发现改进点、编写修复代码、用测试验证并自动提交GitHub PR。本文解析其工作流程、目标痛点与实际应用中的关注点。