AI编程进入团队协作时代:Meta、GitHub、Mistral三大动向解读

Meta收购Conductor、GitHub推Fusion、Mistral开放权重,AI编程转向组织流程。
文章梳理了AI编程工具的三条同步动向:Meta收购多智能体编排工具Conductor,信号是竞争从代码生成延伸到任务编排层,Conductor Cloud将于11月13日变更为只读、20日关闭并删除数据,本地版支持至2027年初;GitHub Copilot Fusion正式可用,提供模型路由与多模型协作,但按实际使用模型计费,衡量效果应看成功率、总成本和人工审查时间;Mistral开放Large 4权重,为需要部署控制的团队提供选项,但算力与维护成本需自行承担。三者共同指向一个趋势:AI编程正从生成代码走向组织整个开发流程,任务拆分、验收标准与成本控制成为关键能力。
AI编程工具正在经历一场关键转向:从「单点生成代码」走向「组织整个开发流程」。Meta 收购多智能体编排工具 Conductor、GitHub 将 Copilot Fusion 正式推向可用、Mistral 开放 Large 4 模型权重——三件事指向同一个问题:当 AI 生成的代码越来越多,谁来组织任务、谁来检查结果、又由谁控制运行成本?
Meta 收编 Conductor:多智能体编排成为新战场
Conductor 官方宣布加入 Meta。这款工具的核心能力是管理多个编程智能体,让它们协同完成开发任务。公告提到团队希望在明年初带来新产品,而现有用户眼下更需要关注的是云端服务的调整:Conductor Cloud 将在 11 月 13 日变更为只读,20 日关闭并开始删除云端用户数据,官方提供了转移到本地和导出数据的办法。本地版本仍会获得新模型和关键修复,持续到 2027 年初。
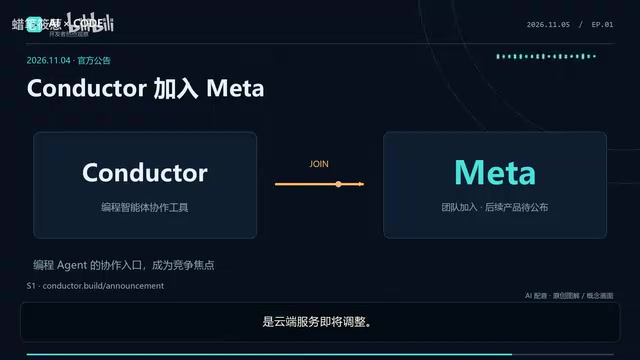
这条新闻容易被当成一次普通的团队收购,但它真正的信号在于:编程工具的竞争正在向任务编排层延伸。类比分布式系统就能理解——多开几个节点并不会自动解决一致性问题,让多个 agent 并行干活,同样需要任务编排、修改边界定义、修改隔离与合并审查,最后仍然要验证结果。Meta 把 Conductor 团队收入麾下,等于在押注「组织层」会成为 AI 编程的下一个价值高地。
对开发者而言,短期动作很明确:如果依赖 Conductor Cloud,需要在 11 月 13 日前完成数据迁移或导出,避免云端关闭后丢失工作成果。
多智能体编排(Multi-Agent Orchestration) 指的是用一个调度层来协调多个具备独立能力的 AI 智能体,使它们分工、通信、合并结果。类比分布式系统中的协调者角色:单个 agent 可以独立完成任务,但一旦任务需要并行、需要互相审查,就必须定义谁负责哪一段、修改边界在哪里、冲突如何合并。Conductor 做的正是这件事——它不生产模型,而是管理多个编程 agent 的协作过程。这类工具的价值不在「多」,而在「有序」:没有编排层,多个 agent 并行只会放大冲突和重复劳动。
GitHub Copilot Fusion:模型路由与协作正式可用
GitHub 宣布 Copilot Fusion 正式可用。它是一套模型路由和协作系统,会按任务决定使用哪些模型,必要时安排多个模型配合,而不是每一步都由你手动切换。官方介绍了三种协作方式:一个模型直接完成;先由高效模型尝试,质量检查后再决定是否升级;或者一个模型起草、另一个审查、再回去修改。
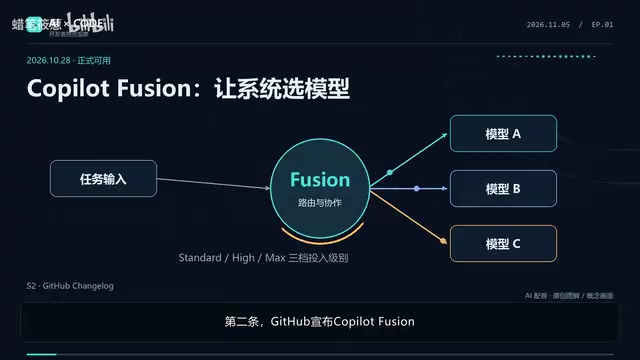
对开发者来说,关键不在于模型数量,而在于把任务要求和通过标准说清楚。同时要注意 Fusion 按实际使用的模型计费,多模型协作并不代表免费。比较务实的做法是拿同一组真实任务去衡量三个指标:成功率、总成本和人工审查时间。代码生成得快,和功能交付得快之间,隔着测试与返工的距离。
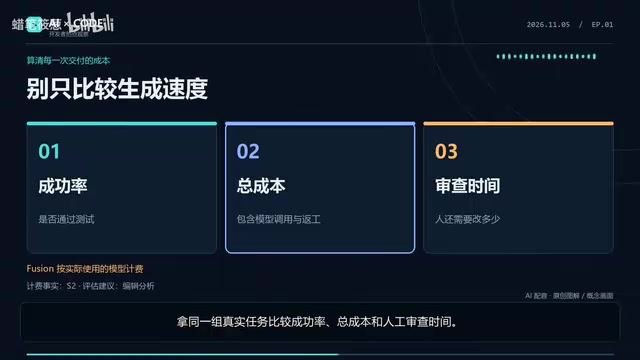
模型路由(Model Routing) 是指系统根据任务特征自动选择最合适的模型,而非固定使用某一个。典型策略包括:简单任务交给便宜快速的模型,复杂或高风险任务升级到更强的模型。这与人工逐个切换模型不同,路由层会读取任务描述、上下文规模、历史成功率等信号来做决策。它的工程意义在于把「用哪个模型」从使用者的心智负担中剥离出来,但代价是成本更不可预测——因此按实际调用计费时,团队必须自己建立成功率与总成本的对照表。
Mistral 开放 Large 4 权重:部署控制多了一种选择
Mistral 已经发布 Large 4 的模型权重,开发团队可以下载、定制并在自己的基础设施上部署。对于关注部署控制和工程集成的团队,这意味着多了一种选项。但开放权重不等于零成本落地,算力、服务稳定性和维护都要算进去。官方强调了编码能力与推理效率的提升,这类基准成绩可以作为参考,是否适合你的项目仍要放到自己的代码库里验证。
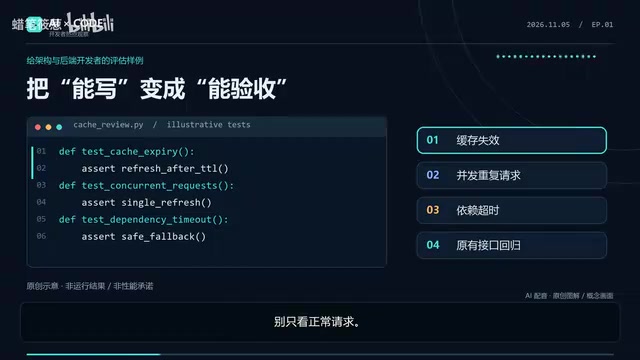
验证方式值得具体化。与其让模型写一个漂亮的小例子,不如让它改一段缓存逻辑,并且只盯着正常请求是不够的——把缓存失效、并发重复请求、依赖超时都写进验收条件,再检查它有没有改坏原有接口。这样的任务更接近真实开发,也更能暴露模型在工程上下文中的实际水平。
开放权重(Open Weights) 与「开源」并不完全等同:它指模型参数可以下载,允许自行部署和微调,但训练数据、训练代码未必公开。对团队而言,开放权重的核心价值是部署控制——数据不出内网、可以针对私有代码库做定制、不受 API 供应商停服影响。但落地成本容易被低估:推理算力、服务稳定性、版本升级和运维都需要自己承担,通常只有在调用量大或合规要求强时,自部署才比调用 API 划算。
三条动向的共同指向:从生成代码到组织流程
把三条新闻放在一起看,趋势就很清楚:AI 编程正从「生成代码」走向「组织整个开发流程」。工具之间怎么协作、模型之间怎么分工、结果怎么验收,会越来越影响开发效率。对架构、分布式和 Python 方向的开发者来说,真正需要建立的能力或许不是写更巧的提示词,而是设计任务拆分、定义验收标准、控制运行成本——这些正是多智能体系统里最像分布式工程的部分。
你更关注哪条路线:多 agent 协作、模型互审,还是开放权重的本地部署?这些选择最终都会落回你自己的开发流程里。
相关推荐

Hermes Agent零基础教程:自进化AI智能体实战
Hermes Agent零基础教程:详解这个GitHub两月获41.7K星的开源自进化AI智能体,从Harness Engineering核心理念、学习循环、三层记忆系统到WSL安装与实战配置,小白也能轻松上手。

AI Agent落地实战:用WorkBuddy打造智能办公助理
本文通过实战案例演示如何用腾讯WorkBuddy完成文件批量转换与归档,对比聊天大模型与AI Agent的能力差异,分析WorkBuddy的积分体系、适用场景与产品定位,为办公自动化选型提供参考。

从单卡瓶颈到千亿参数:大模型分布式并行6大关键问题
基于B站教程梳理大模型分布式并行核心知识:从decoder-only架构的逐token生成与X乘W计算本质出发,解析单卡瓶颈下数据并行、张量并行、流水线并行等6个关键问题,适合私有化部署与模型训练场景的学习者建立系统认知。