AI编程如何真正写好代码:Matt Pocock的战术与战略框架

Matt Pocock 拆解 AI 编程方法论:AI 擅长战术,战略仍靠人。
Matt Pocock 借用《A Philosophy of Software Design》的战术与战略框架,指出 AI 在写函数、修 bug 等战术层面极强,却缺乏战略能力,纯 vibe coding 会让作为 agent 运行环境的代码库持续恶化。他提出以 grill 流程和共享领域语言缩小人机沟通差距,用约 150K token 的「智能区/愚蠢区」阈值管理上下文,并坚持日常使用 medium effort。工作流覆盖 grill、spec 与 tickets、code review、human review、retro 五个阶段,核心是借助强类型、测试与 linter 等确定性检查让 agent 自我验证。信任阶梯决定并行 agent 的数量,改善环境比等待更强模型更有效;编程因高度可验证而比多数知识工作更易被 AI 改造。
AI写代码已经不再是新鲜事,但写得好与写得糟之间的差距正在拉大。TypeScript社区知名教育者Matt Pocock在一次深度访谈中,系统地拆解了他用AI编程的完整方法论——核心观点可以用一句话概括:AI擅长战术编程,但战略编程仍然依赖人。
战术与战略:AI编程的核心矛盾
Matt Pocock借用John Ousterhout在《A Philosophy of Software Design》中的框架来理解AI编程:战术编程是班排长打赢今天的战斗,战略编程是将军打赢整场战争。AI在战术层面极其强大——你让它写一个函数、修一个bug、实现一个组件,它可以不知疲倦地产出。
问题在于,AI几乎不具备战略能力。Pocock的解释很直接:模型在基准测试中被训练成完成特定任务并接受评分,它的注意力100%集中在战术层面。你无法通过「思考长期影响」在基准测试上获得更高分数,而且战略失误往往要等到几个月后才显现,根本无法有效评分。
这导致一个现实后果:纯vibe coding(不看代码、不思考代码的编程方式)如果作为唯一手段,代码库会逐渐恶化。而代码库正是agent运行的环境——环境变差,agent表现也跟着变差。Pocock用了一个生动的比喻:就像那只坐在着火的房子里说「没事」的狗,agent在逐渐崩塌的环境中继续干活,却没有人来维护这座房子。
《A Philosophy of Software Design》是斯坦福教授 John Ousterhout 于 2018 年出版的软件设计经典。书中提出「战术编程」(tactical programming)与「战略编程」(strategic programming)的对立:前者以最快速度让代码跑起来,后者则要求开发者持续投入约 10%–20% 的时间用于改善设计、控制复杂度。Ousterhout 的核心论点是「复杂度是软件最大的敌人」,而战术编程恰恰会不断累积复杂度债,最终让系统难以维护。该书还提出了「深模块」(deep module)等概念,主张用简单接口封装复杂实现。Pocock 正是借用这套框架来解释 AI 的行为倾向:模型在训练与基准测试中被奖励「把当前任务做对」,天然偏向战术层面。
沟通差距:你和agent之间最大的鸿沟
Pocock认为大多数人低估了与agent之间的沟通差距。他把agent比作一个被雇来的开发者,但这个人像《记忆碎片》的主角一样,没有任何记忆,被空投到一个陌生世界中。
他的解决方案是一套被称为「grill」的流程。核心skill叫grill with docs,在你提出模糊需求后,agent会先探索代码库,然后反过来向你提问——不是直接动手,而是通过一系列问题逐步对齐需求。另一个更基础的版本grill me是这个流程的简化版。
这里的关键设计是领域驱动设计(Domain-Driven Design)中的共享语言。Pocock在项目中维护一个glossary,定义应用中所有实体的名称和关系:course、section、lesson、draft version……所有skill都被要求引用这个glossary。代码库、数据库、前端界面使用同一套语言,agent也因此能「像在你的脑子里一样」工作。
他提到一个普遍现象:很多代码库里前端管某个操作叫reversal,邮件系统叫pending charge back,数据库叫refund——同一个东西三个名字,人和agent都难以理解。共享语言解决的不只是命名问题,而是整个协作效率。
领域驱动设计(Domain-Driven Design,DDD)由 Eric Evans 在 2003 年的同名著作中提出,核心是让软件模型与业务领域保持一致。其中一个关键实践是「统一语言」(Ubiquitous Language):开发、业务与代码使用同一套术语,避免同一个概念在不同层出现不同叫法。Pocock 维护的 glossary 正是这一思想在 AI 编程场景下的延伸——当代码库、数据库、前端和 agent 共享同一套实体命名时,agent 在阅读代码和生成实现时歧义更少,也更容易「像在你脑子里」一样理解需求。统一语言的价值不只在于可读性,更在于它降低了人与模型之间传递意图时的信息损耗。
上下文管理:智能区与愚蠢区
Pocock对context window有一个被广泛引用的划分:每个上下文窗口内部都存在「智能区」和「愚蠢区」。随着token数量增加,模型做出的决策会越来越蠢,因为token之间的关系数量呈二次增长,注意力被稀释。
他的经验阈值是大约150K token就开始警惕。这不是因为模型窗口不够大,而是他想要模型始终处于最佳决策状态——延迟更低、成本更可控、追问题时不用为几十万token重复付费。
这个原则直接决定了工作流的分叉:如果任务能在同一个上下文窗口内完成grilling和实现,就直接用implement skill;如果预计会超过阈值,就先转成spec(规格文档),再拆成tickets,每个ticket作为独立会话实现。
一个反直觉的建议是:不要用太高的effort等级。Pocock日常几乎只用Opus 5.5 medium,甚至考虑降到low。他的逻辑是,探索代码库这类任务并不需要更高effort——它只需要读对的文件、找到正确的信息。「人们用最高effort来探索代码库,结果更早进入愚蠢区,性能反而更差。」只有在验证自己的工作时(跑测试、性能追踪、点击真实应用),才值得用高effort。
自动化检查:给agent穿上紧身衣
Pocock反复强调一个词:care(关心)。战略编程很大程度上就是「比旁边那个人多关心一点」。具体到工程实践,就是你愿不愿意投入精力搭建反馈回路,让agent能够自我验证。
他列出了几类核心自动化检查:
- 强类型:使用TypeScript而非JavaScript,类型系统能第一时间告诉agent犯了错
- 运行时测试:真正验证行为是否符合预期
- Linter:检查代码模式、导入来源、已知的坏实践
他的coding standards里有一条:禁止使用TypeScript的any类型,因为那是在作弊绕过类型系统。
更关键的是测试的结构。Pocock引用Michael Feathers和John Ousterhout的「深模块」概念:好的测试应该针对一个大模块的窄接口,模块内部对测试隐藏。这样模块内部可以随意重构而不影响测试;反之,如果每行代码都绑定一个测试,任何改动都会引发无尽的测试修改。
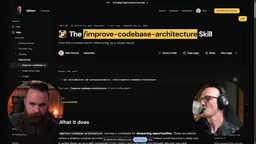
他有一个叫improve code base architecture的skill,可以对任意repo生成可视化报告,找出「浅模块」和重复代码,建议合并为深模块。Pocock自己有一个cron job每天跑一次,自动生成改进PR。
「深模块」(deep module)是 Ousterhout 在《A Philosophy of Software Design》中提出的设计原则:模块应拥有简单窄小的接口,而内部封装大量复杂功能。与之相对的是「浅模块」(shallow module)——接口复杂、内部实现却很少,本质上是把复杂度暴露给了调用方。深模块对测试的意义在于:测试只需针对窄接口编写,模块内部可以自由重构而不破坏测试,从而降低测试维护成本。反之,若测试与实现细节强耦合(例如每行代码都对应一个测试),任何重构都会引发大量测试修改,测试反而成为改进设计的阻力。Pocock 的 improve code base architecture skill 正是用这一原则识别浅模块与重复代码并建议合并。
完整工作流:从grill到retro
Pocock的日常循环可以拆成几个阶段:
Grill——用grill with docs对齐需求,agent提问、你回答,逐步明确边界。
Spec与Tickets——大任务先转成规格文档,存在Markdown或GitHub issue中,再拆成tickets。每个ticket约150K token的体量,由并行sub-agent在worktree中实现,最终合并为一个PR。
Code Review——implement spec会自动调用code review,做两个维度的审查:spec review检查是否做了该做的事、有没有超范围;standards review对照仓库中的coding standards文件。
Human Review与PR skill——PR skill会生成可视化摘要、执行证据(截图或运行记录),以及最重要的「merge danger」评估:这是一扇单向门还是双向门?爆炸半径多大?单向门加高爆炸半径才需要仔细人工审查,双向门小改动可以直接上线。
Retro——回看整个session和PR,把review中发现的问题转化成下次的自动化检查或标准更新。Pocock特别强调:永远优先选择确定性方案。能在linter里加的规则就不要靠agent自觉,CI/CD能做的事就不要让agent每次重新执行。
Git worktree 是 Git 自 2.5 版本起提供的一项功能,允许在同一个仓库上同时检出多个工作目录,每个 worktree 指向不同的分支,共享同一份 Git 对象库。与「克隆多份仓库」相比,worktree 更轻量,也避免了多个副本之间同步的麻烦。在 AI 编程场景中,worktree 让多个 sub-agent 可以并行地在各自独立的分支和目录中实现不同的 ticket,互不干扰,最后再分别合并为 PR。Pocock 提到的「每个 ticket 约 150K token、由并行 sub-agent 在 worktree 中实现」正是利用这一机制,把大任务拆成可并行的独立单元,同时控制单个会话的上下文规模。
信任阶梯:从审查每个PR到并行上百个agent
Pocock引用了Lauren Tan(社区称Potato)的信任阶梯概念:你对agent的信任程度决定了能同时运行多少agent。如果每个PR都要逐行审查,最多管四个agent;如果能信任双向门PR自动合并,才有可能扩展到上百个并行任务。
建立信任的路径不是换更强的模型,而是改善agent的运行环境。Pocock的观点很鲜明:与其等下一代模型解决所有问题,不如现在就解决你环境里的低垂果实。固定模型、修好环境,往往比升级模型效果更明显。
他也不回避局限:自己做的都是个人软件,所以敢让agent自动合并;如果在银行或医疗领域,他会对单向门极度谨慎,在安全验证上投入大量token。
初学者需要知道的事
对于没有软件背景的人,Pocock的建议可以归纳为几条:
不需要先学一门编程语言。语言是战术层面的东西,agent可以教你。真正需要学的是能读懂模块边界、理解架构概念。
读经典书。他推荐的书单包括:John Ousterhout的《A Philosophy of Software Design》、Michael Feathers的《Working Effectively with Legacy Code》、Martin Fowler的《Refactoring》、Kent Beck的《Extreme Programming》以及《The Pragmatic Programmer》。他的improve code base architecture skill正是从这些书中提炼出来的。
用teach skill学习。Pocock自己写了一个teach skill,可以拿任一份你看不懂的报告或概念,让它生成HTML课程、跟踪你的学习进度并出题测验。他自己用这个skill学会了还原魔方。
部署没那么可怕。DevOps在过去十几年已经被serverless平台大幅简化。Pocock的建议是:不确定就用Postgres数据库(Supabase、PlanetScale等托管服务),部署用Vercel或Netlify这类平台,push到GitHub就自动部署。CI/CD是确定性的,不消耗token,永远优先用它而不是让agent手动部署。
用项目证明自己。对于想进入行业的学生,Pocock认为关键是展示你关心战略层面——用对术语、思考长期改进、把项目做得尽可能精致并部署到别人能点击体验的地方。
知识工作的困境
访谈最后有一个耐人寻味的转折。Pocock认为编程反而比大多数知识工作更容易被AI改造,因为编程高度可验证——有测试、有类型、有CI,对错清晰。而课程设计、内容创作、日程规划这类知识工作几乎没有可靠的验证手段,你不知道今天的课程比两个月前的好在哪里。
他自己在课程规划阶段会关掉AI,把学习目标打印在卡片上,用物理空间排列来寻找课程结构。「这需要几个小时,完全离开电脑,离开AI。」他的解释是,agent响应太快、输出太密集,反而让人丢失上下文;手写和卡片把人拉回人类节奏,让思考按正确速度展开。
这或许是整个访谈最诚实的部分:AI编程的工具链已经相对成熟,但在更广泛的知识工作领域,如何验证质量、如何保持人的判断节奏,仍然是未解的问题。
Matt Pocock的skills和资源可以在aihero.dev找到,他的核心主张可以浓缩成一句话:你不需要成为AI专家,你需要成为一个比昨天更关心代码质量的人。
相关推荐

桑德斯对话AI:富豪税、超级智能禁令与民主危机
伯尼·桑德斯在访谈中讨论民主危机、亿万富翁5%年税、Medicare医疗改革,并表态支持禁止开发超级智能,同时回应是否再次竞选总统。

超热岩地热能:数据中心能源困局的新解法
超热岩地热初创公司瞄准数据中心用电需求,宣称可在几乎任何地方交付太瓦级电力。本文分析其技术路线、与数据中心的匹配逻辑,以及钻井成本与监管等现实挑战。
Replit Agent接入Microsoft Teams:对话即开发
Replit Agent接入Microsoft Teams:对话即开发
Replit Agent正式接入Microsoft Teams,用户可在团队对话中直接处理项目、提问并将讨论转化为行动。本文分析这一集成对开发工作流、团队协作和AI编程工具竞争格局的影响。