AI编程真相:代码产量激增,为何交付仍难提速?

AI让代码产量激增,但交付瓶颈转向评审、合规与基础设施,企业进入成本问责阶段。
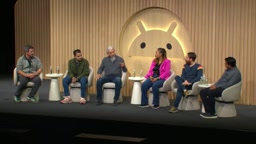
一场由Android DevRel主办的圆桌讨论中,Databricks、Google Maps、Ford、Uber和Instacart的工程负责人达成共识:AI编程工具带来代码产量的巨大加速,但是否转化为业务价值仍待验证。编码提速后,瓶颈转移到代码评审、合规、发布以及CI/CD基础设施,Uber甚至形容“CI每天晚上都在哭泣”。与会者争论代码评审是否可由智能体验证替代,但一致认为需要功能开关、可观测性等安全网支撑。成本方面,Ford、Uber、Databricks已通过token限额、审批和模型路由进入精细化治理。对遗留系统,嘉宾建议像经营技术债一样持续投入提示词与上下文优化。
代码产量激增,但“交付”的定义被重新审视
在近期一场由Android DevRel主办的圆桌讨论中,来自Databricks、Google Maps、Ford、Uber和Instacart的工程负责人罕见地达成共识:AI编程工具确实让代码产量出现了“巨大加速”,但这是否等同于业务价值的加速交付,整个行业仍在摸索。
据Databricks的Vinay Kumar观察,PR数量和代码行数出现了“massive acceleration(大规模加速)”,甚至给代码存储等基础设施带来了扩容压力。他透露,团队在过去六个月里交付的代码量比之前很长一段时间都多。然而,他随即泼了一盆冷水:“不明显的是,这对业务结果究竟有什么影响。”
这种困惑并非个例。Google Maps的Luis Artol指出,关键问题在于“我们是在更快地交付功能,还是只是在更快地交付代码?”早期信号表明前者正在发生,但衡量方式与单纯统计PR数量截然不同。
瓶颈转移:从写代码到评审、合规与发布
当编码环节被AI大幅提速后,一个反直觉的现象出现了:整个交付链条并没有等比例变快,因为瓶颈转移到了下游。
Ford的Anise Davis用一个形象的比喻描述了这种体验:“就像你在大都市的高速公路上,遇到了一个堵点。然后你开始加速,心想太好了,我开得真快。但马上又撞上了下一个堵点。”她指出,AI让这些摩擦点变得更加清晰,而其中不少与代码或技术无关,而是流程和人的问题。
Uber的Ty Smith则从开发者基础设施的角度印证了这一点。他半开玩笑地说:“我的CI每天晚上都在哭泣。”随着代码量激增,构建、测试和部署系统承受着巨大的扩容与效率压力,团队正在通过远程构建执行、缓存优化等手段追赶增长。
Instacart的Kaushik Gopal提出了一个更尖锐的判断:“工程从来就不是瓶颈。”他认为,过去真正的瓶颈在于业务需求模糊、产品与设计反复推敲,而AI带来的最大提速其实发生在合规性工作和遗留系统升级上,而非新功能交付。
CI/CD(持续集成/持续交付) 是现代软件工程的核心实践:开发者每次提交代码后,系统会自动触发构建、运行测试、执行静态检查,并通过流水线将变更部署到各环境。它把过去需要数天的手动集成与发布工作压缩到分钟级,因此对代码量高度敏感——当AI让日提交量成倍增长时,构建机队列、测试用例执行时长、环境部署频率都会成比例膨胀。Ty Smith所说的“CI每天晚上都在哭泣”,正是流水线容量被代码洪流击穿的直观写照。业界常见的应对手段包括远程构建执行(把编译任务分发到弹性算力池)、构建缓存与增量编译(只重建发生变化的模块),以及测试分片与并行化。这也解释了为何编码提速之后,瓶颈会系统性地向下游基础设施转移。
代码评审的未来:从“人人LGTM”到智能验证
圆桌讨论中最具争议的话题之一是代码评审。当AI能生成海量PR时,传统的人工逐行评审是否还可持续?
Kaushik直言不讳:“如果我们对自己诚实一点,我看过的PR里大概70%都是‘looks good to me’。如果搜索全世界代码库里的PR评论,到处都是LGTM。”他的观点是,既然人类评审常常流于形式,不如让智能体来做同样的事,甚至做得更好。
Vinay则将代码评审视为一个“验证问题”:“在一个我对自己的验证能力有充分信心的世界里,我还会100%评审我的PR吗?大概不会。”他指出,代码评审承担着验证和教育两个功能,而其中很大一部分工作可以被加速甚至自动化。
但Luis提出了“好摩擦”与“坏摩擦”的区分。他认为评审仍属于“好摩擦”的范畴,关键在于降低其负担,而不是取消它。更好的路径是用AI提升上游输入的质量——更清晰的架构理解、更扎实的规格说明——从而让产出的代码质量更高,评审自然更顺畅。
Ty补充了一个关键前提:这一切的前提是工程系统具备足够的安全网。“我们已经有功能开关、蓝绿部署、可观测性,只是这些数据散落在不同系统里。”他认为,一旦能把事故追踪、行为监控等数据整合成完整的工程上下文,即使PR直接合入,也能通过流水线中的护栏保障安全。
功能开关(Feature Flag) 是一种把代码部署与功能发布解耦的机制:新代码可以先合入主干并部署到生产环境,但通过配置开关使其对用户不可见,待验证充分后再逐步放量。配合蓝绿部署(维护两套完全相同的生产环境,新版本先在“绿”环境验证,通过后把流量从“蓝”整体切换过去)和可观测性(通过日志、指标、链路追踪持续观测系统真实行为),团队就获得了在代码快速合入后仍能及时发现并回滚问题的能力。这正是Ty Smith论证“即使PR直接合入也安全”的技术基础:安全网的价值不在于阻止变更,而在于让变更的失败代价变得可控、可逆、可观测。缺少这层基础设施时,放宽评审等同于裸奔。
Token经济学:从“随便用”到精细化治理
当讨论转向成本管控时,现场气氛明显务实起来。多位面板嘉宾证实,企业级AI编程已从“实验阶段”进入“问责阶段”。
Anise透露,Ford在经历了一年的大范围实验后,从当年9月开始对开发者实施token限额,并配套了使用量仪表盘,帮助开发者理解什么是“健康的会话”。她将当前阶段类比于云计算早期:“就像AWS刚出来时,我们都随便开实例,结果让公司花了很多钱。现在token也是一样。”
Uber的做法更具弹性:开发者触及限额后,可以一键提交理由,由经理审批。Ty强调,这不仅是控制成本,更是促使工程师思考模型选择的合理性——“你不需要用最前沿的模型来告诉你时间或者切换git分支。”
Databricks则采用了“模型路由+前沿预算”的组合。Vinay解释,平台团队不希望成为决策者,而是通过每日限额作为“绊线”,开发者可自行解锁;对最前沿模型设置月度预算上限,超额需经理审批。最终目标是实现自动模型路由,让开发者完全无需操心成本决策。
Token 是大语言模型处理文本的基本计量单位,大致对应一个词或词的一部分;AI编程工具的每一次补全、对话和智能体执行都会消耗输入与输出的token,并按量计费。模型路由(Model Routing) 则是指平台根据任务复杂度自动把请求分派给不同档位的模型:简单任务(如改时间格式、切换git分支)交给便宜的小模型,复杂推理才调用昂贵的前沿模型。这种分层策略能在不牺牲体验的前提下大幅压低成本,也是Databricks追求“开发者无需操心成本决策”的技术路径。需要注意的是,额度治理不只关乎账单,还会反向塑造开发者行为——当用量可见、限额明确时,工程师会更自觉地评估“这个任务到底需不需要最强模型”。
给开发者的现实建议:把AI当技术债一样经营
面对“如何让大型遗留应用AI就绪”的提问,嘉宾们的回答很现实:几乎没有公司能奢侈地停下三个月做改造。
Kaushik建议像对待技术债一样,拨出固定比例的时间持续优化提示词和上下文。“很多工程师仍然不理解它是怎么工作的,觉得它很神奇、很神秘,因此没有去配置和调优。”
Anise强调学习的连续性:“如果团队花一周学了最新工具,然后一年不再跟进,他们会严重落后。我们是在飞行中造飞机。”
Ty最后给出了一个乐观但紧迫的提醒:AI让所有公司都变得更有野心,但基础设施的扩容必须跟上。“我们需要提前审计,弄清楚下一个会崩溃的系统是什么。只要感觉在掌控之中,大家都开心;一旦出现意外,对所有人都是坏消息。”
相关推荐

零基础用WorkBuddy做AI漫剧:技能包保姆级安装教程
零基础如何用WorkBuddy制作AI漫剧?本文详解WorkBuddy安装、Skill技能包导入与调用全流程,附剧本生成实操演示与人工修改技巧,帮你跑通AI漫剧从剧本到分镜的第一步。

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。

PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。