AI自动补环境实战:沙箱+Prompt搞定爬虫逆向

逆向工程师的「世纪难题」:补环境
做过爬虫逆向的开发者,都对「补环境」这三个字有刻骨铭心的记忆。当你把网站加密算法从混淆的 JavaScript 里抠出来,兴冲冲地丢进 Node.js 里运行,迎接你的往往是连环报错:
- 一会儿提示缺少
document - 一会儿说
window上少了某个方法 - 手动补上
window = {}后,它又检测到了非法的代理对象
这是一场没有尽头的猫鼠游戏。原本一个简单的加密数据获取,可能要熬通宵补几百行原型链,等到心态爆炸才勉强跑通。这也是为什么逆向圈里流传着那句半是自嘲半是无奈的话——最让人破防的四个字,就是「补环境」。
补环境问题的根源,在于 JavaScript 运行时环境的结构性差异。要理解这一分裂,需要追溯 JavaScript 的诞生背景:1995 年 Brendan Eich 在 Netscape 中创造 JavaScript 时,语言本身与宿主环境(浏览器)是深度耦合的。ECMAScript 规范(由 ECMA TC39 委员会维护)只定义语言核心——语法、类型系统、原型链机制——而 window、document、navigator 等对象从未进入语言规范,始终属于「宿主环境责任」。这一架构在历史上是合理的:不同的宿主(浏览器、服务器、嵌入式设备)可以按需实现不同的 API 层,语言内核保持轻量可移植。
值得一提的是,TC39 委员会至今仍保持着这种克制——即便是 2021 年引入的 Temporal API(用于替代饱受诟病的 Date 对象)也明确属于语言核心规范,而非宿主扩展;但 fetch、WebSocket 等网络 API 最初源于浏览器实现,后来才通过 WHATWG 规范逐步标准化,并由 Node.js 18+ 有选择地引入——这种「从宿主扩展反向进入语言生态」的路径,本身就反映了这场历史分裂的持续影响。
这一分裂在 2009 年 Ryan Dahl 创建 Node.js 时成为关键分叉点:Node.js 复用了 Chrome 的 V8 引擎执行 ECMAScript 核心语言规范,但刻意剥离了所有浏览器特有的 Web API 层——这一层由 WHATWG 和 W3C 规范定义,包含数百个接口。浏览器的 Web API 层并非语言规范的一部分,而是由各大浏览器厂商在 W3C/WHATWG 规范框架下独立实现的「宿主环境扩展」。Chrome、Firefox、Safari 各自的实现在细节上存在微妙差异,但都遵循同一套规范骨架。Node.js 在设计之初明确将自身定位为「服务端运行时」而非「浏览器模拟器」,因此刻意不实现这一层——这个决策在 2009 年是合理的工程取舍,却在十余年后的反爬虫博弈中成为了逆向工程师最大的痛点。
两者的差异不仅是 API 数量问题,更涉及对象原型链的完整性:浏览器中 HTMLElement 继承自 Element,Element 继承自 Node,这条原型链上的每个节点都有精确的属性描述符,反爬脚本可以通过 Object.getOwnPropertyDescriptor() 或 instanceof 检查来识别伪造对象。反爬虫工程师正是利用这一差异,在加密脚本中埋入大量环境指纹检测逻辑——检测 navigator.webdriver 标志位、canvas 渲染能力、AudioContext 频谱特征,乃至 WebGL 渲染器信息。这套指纹体系从 2015 年前后随着 TLS 指纹和设备指纹技术的成熟而逐渐普及,到 2020 年代已演变为多层次的环境真实性校验体系,这也是「补环境」工作量如此之大的历史根源。
本文基于 B 站 UP 主分享的一套 AI 逆向实战思路,探讨如何把繁琐的补环境工作交给 AI 自动化完成。
核心思路:把 AI 变成自动化补环境生成器
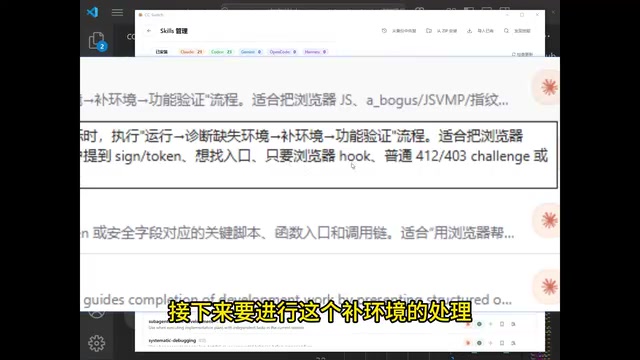
这套方案的核心,是把 AI 从「辅助改错的助手」升级为「自动化补环境生成器」。整个实现依赖一个精心设计的 Skill(封装好的能力模块),本质上是一个 JS 逆向沙箱补环境工具。
Skill 的设计逻辑
UP 主把补环境所需处理的核心对象——浏览器的 BOM(Browser Object Model)和 DOM(Document Object Model)——全部预先编写进 Skill,形成一个类似「沙箱」的结构。
理解为何这两类对象如此关键,需要一点技术背景:BOM 提供了与浏览器窗口交互的接口,包括 window、navigator、location、history 等对象,这些对象在 Node.js 环境中天然缺失;DOM 则是 HTML 文档的树形结构表示,document 对象是其根节点,提供 createElement、querySelector 等操作方法。BOM 最早由 Netscape 在 Navigator 2.0 中引入,并无统一规范,各浏览器厂商各自实现,直到 HTML5 时代才逐渐被 WHATWG 的 Living Standard 部分收录;DOM 则由 W3C 从 1998 年起发布正式规范(DOM Level 1/2/3),是浏览器互操作性的重要基础。这一历史差异意味着:BOM 对象的「正确形态」在不同浏览器之间本就存在细微出入,而反爬脚本往往以 Chrome 的实现为基准进行检测,逆向工程师在补环境时必须精确对齐这一特定实现,而非泛化的规范定义。
值得注意的是,BOM 和 DOM 并非两个独立的孤岛,而是通过原型链深度耦合的对象体系。window 对象既是 BOM 的顶层对象,也是浏览器中 JavaScript 的全局作用域——这意味着在浏览器里,window.document、window.navigator、window.location 这些属性不仅要存在,还必须具备正确的原型链归属。例如,document 的原型链应为 HTMLDocument → Document → Node → EventTarget → Object,任何一个环节缺失或类型不符,都可能触发反爬脚本内置的完整性校验。现代反爬虫脚本正是通过检测这些对象的存在性、属性完整性乃至原型链结构来识别非浏览器环境,从而拒绝执行真实的加密逻辑。这也是「补环境」工作量如此之大的根本原因——补的不只是属性,还要骗过脚本对环境真实性的深层校验。
你只需要提供三样东西:
- 一个混淆过的 JS 文件
- 定位好的加密入口
- 本地 Node.js 的复写目标
剩下的工作,全部交给自动化流程处理。
三步自动化流程
Skill 运行时会自动执行一个闭环流程:
- 第一步:诊断缺失环境。沙箱运行脚本,主动检测当前环境缺少哪些对象和方法,像日志一样打印出所有缺失项。
- 第二步:AI 自动补环境。这是最关键的一步。诊断出缺失项后,AI 根据打印日志自动生成对应补丁——比如脚本需要
createElement,AI 就生成一个完整的 Node 节点对象,全程无需人工干预。 - 第三步:功能自验证。补完之后,AI 自行运行验证,确认加密流程是否跑通。
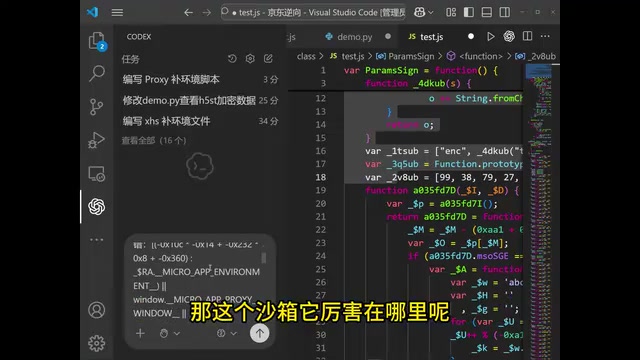
这里的「沙箱」在技术上依赖 JavaScript 的 Proxy 对象机制与 Node.js 的 vm 模块的深度协作。Proxy 是 ES2015 引入的元编程特性,允许开发者拦截并自定义对象的基本操作,共支持 13 种陷阱,包括属性读取(get 陷阱)、属性写入(set 陷阱)和函数调用(apply 陷阱)等。
要理解为何 Proxy 在这里不可或缺,需要回顾其设计初衷。Proxy 本质上是对 JavaScript 对象「基本操作(fundamental operations)」的元层拦截,这些基本操作在 ECMAScript 规范中被称为「内部方法(internal methods)」,包括 [[Get]]、[[Set]]、[[HasProperty]]、[[Call]] 等共 13 种。传统的属性访问拦截方式(如 getter/setter 或 Object.defineProperty)只能针对已知的属性名预先设置,而 Proxy 的 get 陷阱可以拦截对任意属性名的访问——这正是捕获「脚本尝试读取 window.xxxUnknown」这类未知属性访问的唯一方式。需要特别指出的是,Proxy 对象本身也可能成为反爬脚本的检测目标:部分高级反爬脚本会利用 Object.getOwnPropertyDescriptor 或特定的类型判断逻辑来检测 Proxy 的存在,因此沙箱的设计需要进一步处理 Proxy 的「透明性」问题,这也是高质量 Skill 构建中的难点之一。
vm 模块则负责在进程层面隔离执行上下文:vm.createContext() 本质上是在 V8 引擎中创建一个独立的 Isolate 上下文快照,注入的全局对象会成为该上下文的根作用域,这使得沙箱能精确控制脚本能「看到」哪些全局变量,同时防止脚本通过 process、require 等宿主对象逃逸到 Node.js 主进程。值得注意的是,vm 模块本身并非安全沙箱——Node.js 官方文档明确指出它无法防止恶意代码突破隔离,但在爬虫逆向场景中,我们处理的是已知的第三方加密脚本而非恶意代码,vm 的上下文隔离能力已足以满足需求。
两者结合的核心价值在于:将原本会导致脚本崩溃的「属性未定义错误」转化为可结构化处理的「访问记录日志」,从而精确捕获脚本尝试读取 window.xxx 或 document.yyy 时的所有行为,而不会直接抛出报错中断执行。这正是第一步能够系统性输出所有缺失项的技术基础,也是这套方案区别于「报一个补一个」的关键所在。
关键技巧:Prompt 不是让 AI 改错,而是让它分析
这套方案里最值得借鉴的,是提示词的设计哲学。
很多人把报错信息丢给 AI 时,习惯说「帮我修复这个错误」。但 UP 主的做法恰恰相反:
我并没有直接让它帮我去修改错误,我是把犯错的信息粘贴到指定位置,但没有让它直接修改,而是先让它按照我合适的 Skill 去进行分析。
这个差别至关重要。直接让 AI 改错,它只会「头痛医头」,补一个报一个,和人工手动操作陷入同样的死循环。先让 AI 结合沙箱做环境代理检测分析,它才能理解脚本到底在检测什么、缺少什么,从而系统性地生成完整补丁,而不是零敲碎打。
这一设计哲学背后有更深的认知科学根据。当 AI 面对「修复错误」这一指令时,其注意力被锚定在「错误信息本身」——这是一种局部视角,只能看到当前崩溃点,无法感知脚本对环境的整体预期。这在提示词工程(Prompt Engineering)领域被称为「框架效应(framing effect)」:任务描述的方式会根本性地改变模型的推理路径和输出质量。「修复错误」这一框架激活的是模式匹配式的局部修补,而「分析沙箱日志」这一框架激活的是意图推断式的全局建模——两者调用的是截然不同的推理链路。
从提示词工程的实践视角来看,这种区别也对应了「零样本(zero-shot)指令」与「结构化上下文注入」之间的差距。将沙箱日志作为结构化上下文传入,相当于为 AI 提供了一份「脚本对环境的完整需求清单」,大语言模型在此类有明确输入结构的任务上,推理准确率远高于仅凭错误信息进行猜测的场景。这也解释了为何 Skill 的预置沙箱质量直接决定了方案的天花板——沙箱捕获的日志越完整,AI 的「需求清单」就越精确,生成的补丁也就越系统。进一步来说,这一设计契合了提示词工程中「思维链(Chain-of-Thought)」与「任务分解(Task Decomposition)」的最佳实践:将「补环境」这一复杂任务拆解为「诊断 → 分析 → 生成 → 验证」四个结构化子任务,每个子任务都有明确的输入输出边界,大幅降低了模型在单步推理中需要处理的复杂度,从而提升整体输出质量。
而「分析沙箱日志」这一指令将 AI 的处理框架切换为「理解脚本意图」——从日志中归纳出脚本对浏览器环境的全部假设,再一次性生成满足这些假设的完整对象图谱。换句话说:这是「局部修复」与「全局建模」两种认知模式的本质差异,而精心设计的 Prompt 正是在两者之间做出了正确的选择。沙箱负责「暴露问题」(输出检测日志),AI 负责「理解并解决问题」(生成对应对象),两者配合形成自动化闭环。
实战演示:几秒钟拿到电商加密数据
UP 主用一个真实的电商爬虫案例演示了整套流程。
他新建对话,把预设好的提示词和报错信息粘贴进去,调用 env 补环境 Skill 对当前脚本进行处理。AI 迅速分析出脚本中存在一个名为 HOST 的加密数据字段,并生成了最终的 demo.py 文件。
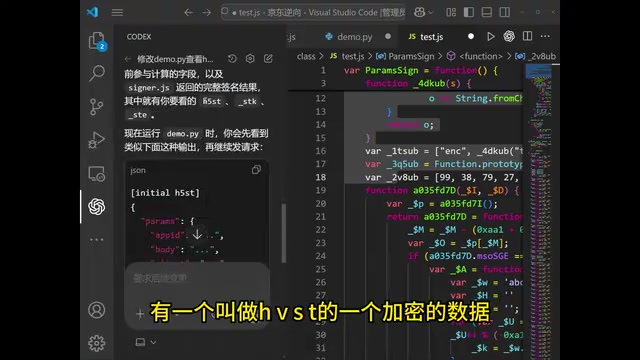
运行生成的文件后,输出结果清晰包含了以下关键参数:
- 时间戳
t的值 - 加密后的
HOST值
拿到正确的 HOST 值后,请求成功返回了真实的电商数据,甚至能看到具体的商品信息。
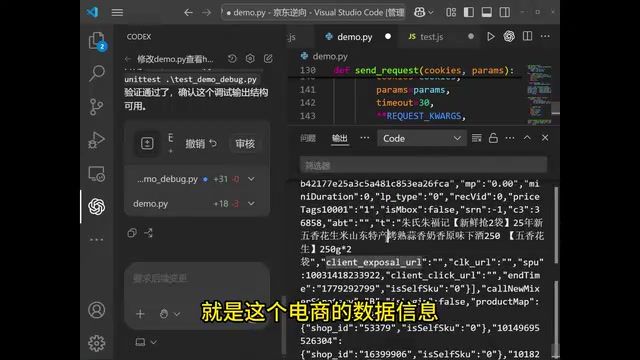
整个过程中,开发者没有手动补任何一行环境代码。原本需要通宵抠原型链的活,AI 借助智能沙箱在几秒钟内自动搞定。
客观看待:AI 逆向的能力边界
这套方案展示了 AI 在逆向工程中的巨大潜力,但也需要理性认识其适用范围。
明显的优势:对于常规的 BOM/DOM 补环境场景,AI + 沙箱的组合能大幅降低门槛,把过去需要资深经验才能完成的工作变成流程化操作,零基础开发者也能借此上手。
同样需要注意边界:
- 沙箱本身的质量决定了上限。Skill 里预置的环境对象越完善、检测日志越精准,AI 补起来才越顺。沙箱本身仍需要专业经验来构建。
- 面对更复杂的反爬手段,单靠补环境未必够用。VMP(Virtual Machine Protection) 和 WebAssembly(WASM) 代表了当前反爬体系的两个技术天花板,但两者的防护逻辑截然不同。
VMP 源于软件版权保护领域(由 VMProtect、Themida 等工具商业化普及),其核心是「指令集私有化」——原始 JavaScript 逻辑被编译为攻击者无法直接阅读的自定义字节码,运行时由内嵌的解释器动态执行。这与经典的「解释器模式」在架构上相似,但目的截然相反:后者是为了可扩展性,前者是为了不可读性。由于每个 VMP 保护的脚本都可能使用不同的「虚拟机架构」(操作码映射、寄存器布局),逆向工程师必须针对特定脚本重新分析其解释器逻辑,工作量呈指数级增长。VMP 的本质防护在于:即便逆向工程师完整获取了脚本源码,看到的也只是「解释器 + 字节码」的组合,真实业务逻辑被隐藏在字节码序列中,需要额外的「虚拟机逆向」工作才能还原。
从攻防演进的视角来看,VMP 技术自 2010 年代初期开始从桌面软件保护领域渗透进 Web 反爬虫场景。相较于桌面 VMP(保护的是原生机器码),Web VMP 保护的是 JavaScript 字节码,但两者的核心防御逻辑一脉相承:通过私有化指令集,将静态分析的成本从「读懂代码」提升至「先逆向虚拟机、再读懂字节码」的双重负担。目前已有专门针对 Web VMP 的半自动化分析工具出现,但每遇到一种新的虚拟机架构,工具链就需要针对性适配,攻防双方的军备竞赛仍在持续。
WASM 则利用「编译隔离」——将加密逻辑用 C/C++/Rust 编写后编译为 .wasm 二进制模块,即使反编译为 WAT(WebAssembly Text Format)文本格式,也是难以理解的低级指令序列,且 WASM 模块通常与 JavaScript 胶水代码深度耦合,难以单独提取执行。WASM 的安全模型还天然带有沙箱特性——模块无法直接访问宿主 JavaScript 的内存空间,双方只能通过严格定义的 import/export 接口交互,这使得动态分析也更加困难。值得补充的是,WASM 的这种「接口契约」特性在反爬虫场景中带来了额外优势:即便逆向工程师通过动态插桩(dynamic instrumentation)手段监控了 JavaScript 与 WASM 模块之间的所有调用,看到的也只是参数值的传递,而无法直接还原 WASM 内部执行的加密算法逻辑——这与 VMP 的防护边界形成互补,是为何高端反爬体系往往将两者结合使用的原因。从攻防演进角度看,WASM 方案的普及得益于 2019 年 WebAssembly 成为 W3C 正式标准后各大浏览器完整支持,使反爬虫厂商得以将其纳入技术栈;而针对 WASM 的逆向工具链(如 wabt、Binaryen)也在持续发展,形成新的攻防循环。
面对这两类技术,AI 辅助补环境只能解决「在哪里调用」的问题,无法解决「调用了什么逻辑」的核心难题,即便结合 AI 辅助,仍需大量专业逆向经验才能突破。
- 逆向工程涉及法律与合规边界,相关技术务必在授权和合法的范围内使用,仅作学习研究用途。
写在最后
这套思路的本质,是把 AI 从「聊天工具」变成「自动化引擎」——通过精心设计的沙箱 Skill 暴露问题,再借助恰当的 Prompt 引导 AI 系统性地解决问题。
它给我们的启发不止于爬虫逆向:很多看似繁琐、依赖经验硬啃的技术活,都可以通过「专业工具封装 + AI 智能填充」的模式实现自动化。据 UP 主预告,下一步还将尝试用 AI 编写 AST(抽象语法树)插件,把几万行混淆代码自动还原成可读的源码。
AST 是源代码的树形结构中间表示,每个节点代表一种语法结构(如函数声明、变量赋值、二元运算等)。AST 并非 JavaScript 独有的概念——它是所有编译型和解释型语言工具链的核心数据结构,从 GCC 的 GIMPLE 表示到 Python 的 ast 模块,AST 都是「源码理解」与「代码变换」的通用中间层。在 JavaScript 生态中,ESTree 规范定义了统一的 AST 节点格式,Babel、ESLint、Prettier 等主流工具均基于此规范构建,这使得 AST 工具在 JavaScript 混淆逆向领域有天然的生态优势。
要理解 AST 在逆向中的地位,需要先理解「混淆」的本质:混淆工具(如 obfuscator.io)并不修改代码的执行语义,而是在保持语义等价的前提下,对 AST 施加一系列「语义保持变换(semantics-preserving transformations)」。这意味着这些变换从原理上是可逆的——只要能识别出变换的模式,就能写出反向的 AST 转换规则将其还原。
JavaScript 混淆与 AST 还原之间的博弈,本质上是「信息熵压缩」与「模式识别」的对抗——现代混淆工具施加的变换通常有几类:控制流平坦化将线性代码重写为以状态机驱动的 switch-case 结构,但状态转移逻辑本身是静态可分析的;字符串加密将字面量替换为解密函数调用,但解密函数在编译期是常量可折叠的;变量名重命名(替换为无意义的 Unicode 字符序列)以及死代码注入则增加了阅读噪音,但不影响逻辑结构的还原。Babel 生态提供了完整的 AST 操作工具链:@babel/parser 基于 ESTree 规范将源码解析为语法树,@babel/traverse 实现深度优先遍历并支持节点替换,@babel/types 提供类型安全的节点构造 API,@babel/generator 则将修改后的语法树重新生成可读代码。值得注意的是,不同混淆工具在 AST 层面留下的「指纹」往往是可识别的——例如 obfuscator.io 生成的控制流平坦化结构与 jsfuck 编码的字符展开模式在 AST 形态上有显著差异,这为 AI 基于模式识别生成针对性还原插件提供了可能性。
值得注意的是,AST 还原与补环境面临的挑战在性质上截然不同:补环境是「运行时缺失补全」问题,输入是日志、输出是对象定义,AI 可以直接生成可执行代码;而 AST 还原是「静态语义模式识别」问题,需要 AI 理解混淆变换的结构规律,并生成对应的 Babel 插件逻辑。后者对 AI 推理能力的要求更高,但也意味着一旦 AI 能成功抽象出混淆模式,生成的还原插件可以批量复用于使用相同混淆工具的所有目标——这是补环境方案难以实现的规模化效益。
AI 介入这一流程的核心价值在于:将「识别混淆模式并编写对应转换规则」这一依赖大量人工经验的步骤,转化为可通过自然语言描述驱动的代码生成任务——不同混淆工具产生的 AST 模式差异显著,而 AI 生成 AST 转换逻辑的价值正在于将模式分析的经验判断转化为可自动化的代码生成过程。这将是补环境之后,AI 辅助逆向的下一个重要战场。
与其抱怨大厂的加密手段越来越狠,不如学会用 AI 把这些难题变成可自动化的流程。工具的演进,正在重新定义「技术门槛」的含义。
核心要点
核心要点
相关推荐

顶尖企业用好AI的秘诀:从实验走向成熟管理层
基于KPMG第三季度AI Pulse调查,解析用好AI的顶尖企业与实验阶段企业的关键差距:模型路由、数据主权、AI管理层、成本与价值管理,以及从效率到机会的用途转变。

付费用户因"网络滥用"遭ChatGPT封号:1分钟秒拒的申诉机制引众怒
一名付费ChatGPT用户因"网络滥用"被无预警封号,三次申诉均在一分钟内被机器人驳回,全程无人工审核。本文梳理事件经过、可能的误判原因,并剖析AI平台自动化治理的申诉困境与开发者应对建议。

OpenSOP:用Git管理多语音Agent提示词的开源方案
OpenSOP 是一个开源工具,用 Git、YAML 和 Markdown 管理多个AI语音Agent的提示词,解决提示词重复、漂移和手动同步难题,支持改动影响预览和一键回滚。