AI参与度声明为何需要更精确的规范:开源社区治理新挑战

一条Reddit帖子引发的社区治理思考
随着AI编程工具和大语言模型(LLM)在开源社区的普及,一个新的治理难题正在浮现:当开发者提交代码或发布内容时,应该如何声明其中AI的参与程度?近期一位Reddit用户提出的建议,直指当前社区管理机制的模糊地带——现有的"AI参与度"提醒机制过于笼统,导致回复流于形式,无法提供社区真正需要的信息。
值得注意的是,这一矛盾有其深刻的时代背景。大语言模型是基于Transformer架构训练的超大规模神经网络,以GPT-4、Claude、Gemini为代表,能够生成高质量代码、文档和技术说明,已深度渗透进日常开发流程。GitHub Copilot、Cursor、Codeium等AI编程助手的月活用户已达数百万,Stack Overflow 2023年开发者调查显示超过70%的受访者正在使用或计划使用AI编程工具。这种普及速度远超社区治理机制的迭代速度,造成规则滞后于现实的结构性矛盾,也正是这条帖子能引发广泛共鸣的根本原因。
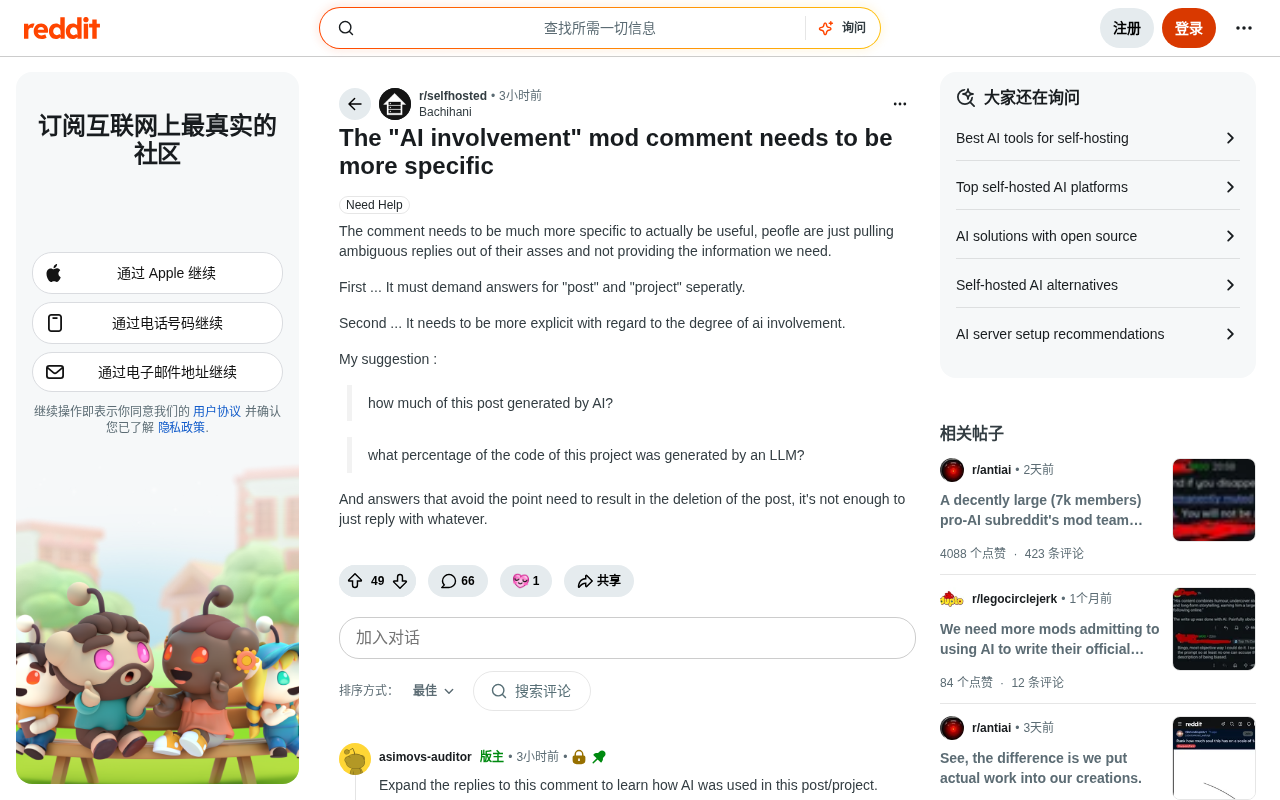
这位用户的核心观点非常直接:目前很多人只是"随口给出模糊的回复",而没有真正披露关键信息。这种现象在AI辅助开发日益普及的今天,正在成为社区信任体系中的一个薄弱环节。
模糊声明等于没有声明
当前许多社区在处理AI相关内容时,往往只要求发布者做一个笼统的确认——比如勾选"本内容使用了AI"或简单回复一句"部分内容由AI生成"。这种做法看似解决了透明度问题,实际上却制造了新的信息盲区。
发帖者认为,模糊的回复本质上等同于没有回复。当一个开发者说"我用了一点AI"时,读者根本无法判断这究竟意味着什么:是用AI润色了文档?还是整个项目的核心逻辑都由LLM生成?这两种情况在代码质量、可维护性和责任归属上有着天壤之别。
开源社区对"透明度基础设施"其实并不陌生,这一问题有其历史参照系。从1980年代GNU通用公共许可证(GPL)到后来的Apache、MIT等许可证体系,开源界建立了一套成熟的代码权属声明规范。学术界的利益冲突声明、ORCID作者身份认证体系,以及软件供应链安全领域的SBOM(软件物料清单)标准,都是"谁产出了什么"这一问题在不同场景下的制度化回答。AI参与度声明本质上是这条演化脉络的自然延伸——只是这一次,社区规范的建立速度远落后于技术的扩散速度。
模糊声明带来的实际危害
对于开源社区而言,AI参与度的透明化不仅是伦理问题,更是切实的工程问题。"幻觉"(Hallucination)是LLM的固有缺陷,指模型以高置信度生成事实错误或逻辑矛盾的内容。在代码生成场景中,这可能表现为引用不存在的API、生成功能上看似合理但存在安全漏洞的函数,或错误实现加密算法。2023年斯坦福大学研究发现,GitHub Copilot生成的代码中约40%包含潜在安全缺陷。若审阅者不知晓代码的AI来源比例,便可能降低审查强度,从而让这类风险静默进入生产环境。
此外,AI代码生成还引发了尚未完全解决的版权与许可证难题。训练数据中包含大量采用GPL等Copyleft许可证的代码,LLM有时会在生成内容中复现这些片段,可能在无意间引入许可证污染。2022年GitHub Copilot被指控在用户不知情的情况下生成与训练数据高度相似的代码片段,由此引发集体诉讼。如果项目贡献者不主动披露高比例的AI生成代码,项目维护者将无法评估潜在的合规风险,这在企业级开源项目中可能造成严重的法律后果。
笼统的AI参与度声明剥夺了社区做出明智判断的能力,最终损害的是整个协作生态的信任基础。
建议一:区分"帖子"与"项目"
发帖者提出的第一个具体建议是:AI披露机制必须将"post(帖子内容)"和"project(项目代码)"分开处理。
这是一个颇具洞察力的区分。帖子本身的文字表述(可能由AI撰写)与其所推广的技术项目(代码可能由人工编写)是两个完全独立的维度。反之亦然——一个人工撰写的帖子,可能推广的是一个几乎全由AI生成的项目。
如果把这两者混为一谈,声明就失去了指导意义。将它们拆分,能让读者分别评估:
- 帖子文本:这段介绍、说明是否由AI生成?这关系到内容的原创性和真实性。
- 项目代码:核心功能是人类主导还是AI主导?这直接关系到技术可信度。
建议二:量化AI参与的程度
第二个建议更具操作性:不要停留在"是否使用了AI"的二元选择,而要明确"使用了多少"。这正是当前AI透明度规范中最关键的缺口。
发帖者给出了两个具体的量化提问模板:
- 这篇帖子有多少内容是由AI生成的?
- 这个项目的代码中,有百分之多少是由LLM生成的?
这种百分比式的披露方式,把模糊的定性描述转化为可比较的定量指标。虽然精确到具体数字在现实中很难做到,但即使是粗略的区间估计——比如"约20%"、"超过80%"——也远比一句"用了AI"更有实际参考价值。
量化披露面临的落地挑战
这一建议也面临真实的落地难题。开发者的自我评估可能不够准确,甚至存在有意低报的动机。此外,"AI生成"与"AI辅助修改"之间的界限本身就很模糊——如果开发者写了一个函数,再让Copilot补全并调整,这究竟算AI生成还是人工编写?
在技术可行性层面,目前学界和工业界提出了几种路径:一是基于代码溯源工具追踪代码片段的历史来源;二是借助AI生成内容检测模型(如GPTZero、Originality.ai)进行概率估计,但这类工具对代码的误判率较高;三是依赖IDE插件在开发过程中自动记录AI补全的代码行数占比,Cursor等工具已具备此类原始数据。最务实的近期方案仍是发布者自我报告区间估计,配合清晰的定义标准,以降低认知负担并提高遵从率。这些边界问题说明,量化机制需要配套清晰的定义和标准,否则量化数字本身也可能沦为新一轮的模糊表述。
建议三:对敷衍回避者采取删除措施
发帖者的第三个建议最为强硬:那些回避实质问题、随便应付的AI参与度声明,应导致帖子被直接删除。
他明确表示,"仅仅回复些什么是不够的"。这一提议触及了社区治理的执行力核心——任何披露规则如果没有配套的强制机制,都容易被架空。当敷衍不需要付出代价时,人们自然会选择敷衍。
通过将删除作为不合规的后果,社区实际上是在提高透明度违规的"成本",从而倒逼发布者认真对待AI披露义务。
强制执行的双刃剑
然而,这种强硬措施也需要谨慎权衡。过于严苛的删除政策可能误伤那些真诚但表述不够规范的用户,也可能给版主带来主观判断的负担——如何界定一个回复是"敷衍"还是"真诚但不精确"?
这一压力在平台规模上尤为突出。Reddit的内容管理高度依赖志愿版主,全平台约有50万活跃版主管理数百万个子版块。要求版主判断AI参与度声明是否"敷衍",本质上是将复杂的认知劳动转移到无偿志愿者身上,在大型技术社区(如r/programming、r/MachineLearning等订阅人数超百万的版块)几乎不可持续。更可扩展的方向可能是:平台层提供结构化的AI披露表单(强制选择而非自由文本)、引入社区投票举报机制,或效仿Wikipedia的标记系统,将初步核查分散至普通用户。这需要清晰的评判标准和公正的执行,否则容易引发社区新的争议。
更深层的启示:AI时代的信息透明度基础设施
这条看似只是关于版规细节的建议,实际上折射出整个技术社区正在经历的深刻转型。当AI能够生成越来越难以辨别的内容和代码时,"AI参与度声明"正从一个可选的礼貌行为,演变为维护开源社区信任的基础设施。
未来我们可能会看到更多平台建立标准化的AI披露框架,就像学术界要求声明利益冲突、软件界要求标注开源许可证一样。这位Reddit用户的建议,可以看作这一趋势在草根社区的自发萌芽。
有效的AI参与度声明规范需要三个核心原则协同发力:分类明确(区分帖子内容与项目代码)、程度可量化(超越是非二元判断)、执行有力(配套实质性惩戒机制)。只有三者结合,AI透明度声明才能从形式主义走向真正有价值的信任工具。
核心要点
相关推荐
Vibe Coding是什么?程序员必须掌握的AI编程能力
Vibe Coding(AI编程)到底是什么?本文解析AI编程如何重塑研发流程、为何传统程序员面临淘汰、Cursor与Claude Code两大工具,以及程序员、PM、运营等岗位为何都该掌握这项能力。
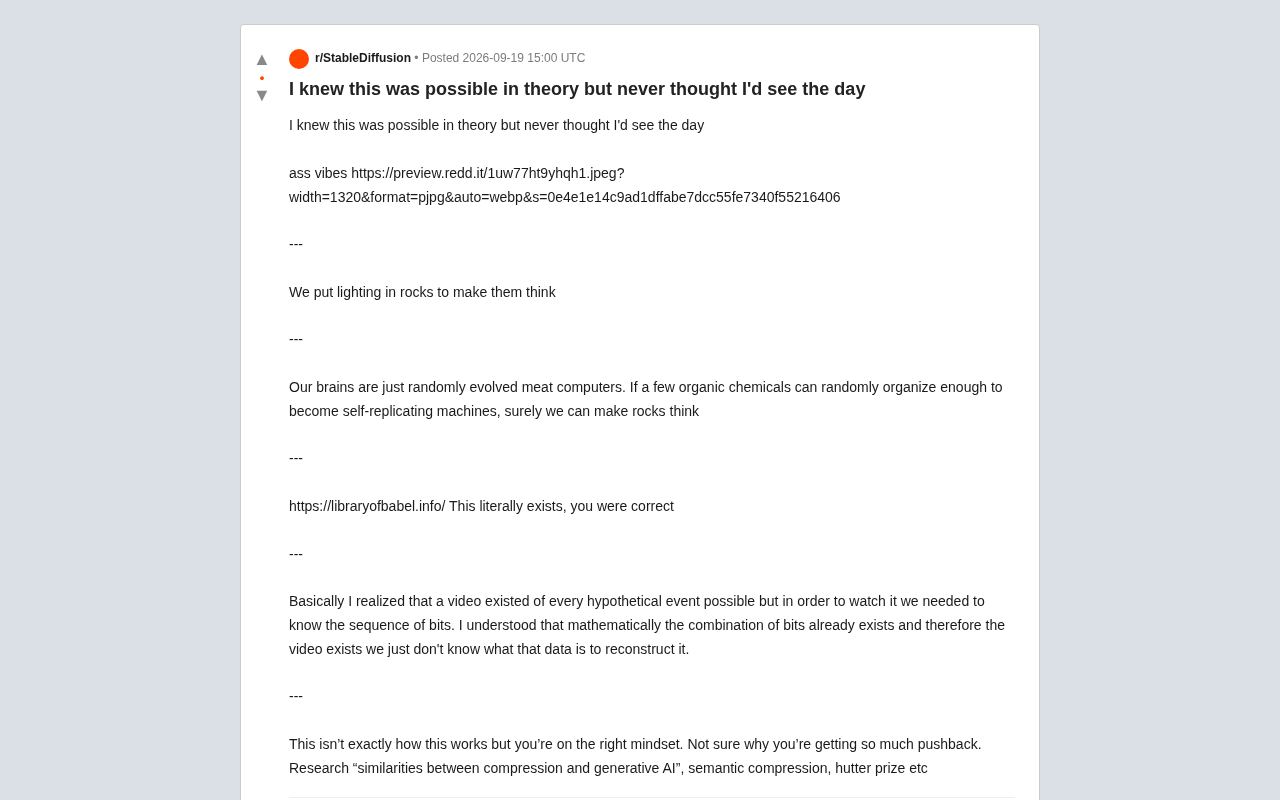
让石头思考:生成式AI与信息压缩的哲学思考
从Reddit热帖「让石头思考」出发,探讨生成式AI的信息论本质:为何压缩等价于理解,巴别图书馆式的可能性空间思辨,以及语义压缩、Hutter Prize与AI原理的深层联系。
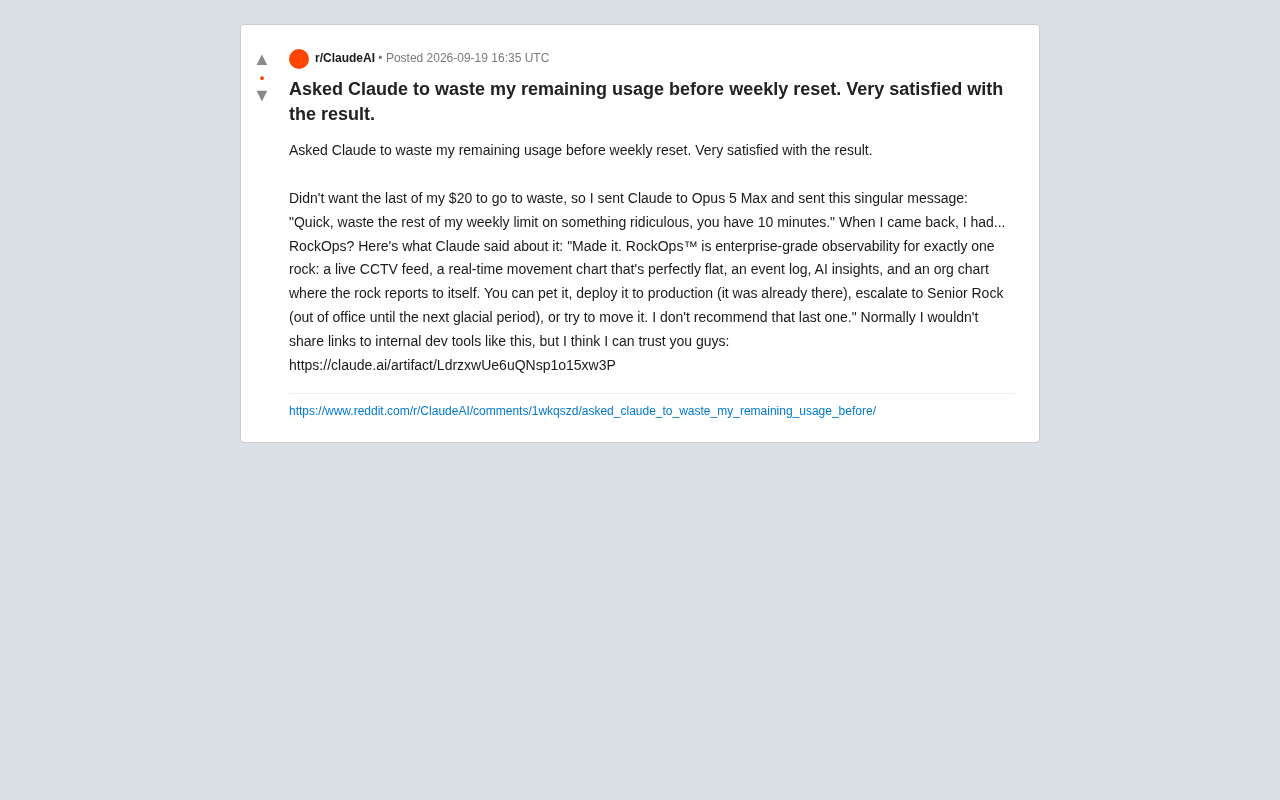
让Claude"浪费"额度:一场AI创造力的意外实验
一位Reddit用户让Claude用剩余额度"做件荒唐的事",结果AI生成了监控一块石头的企业级平台RockOps。本文分析这一趣味案例背后的AI创造力与产品设计能力。