AI测试代理误报通过率怎么降?实战四招
AI测试代理的误报通过比测试不稳定更危险,需用显式预期、硬断言等组合手段防范。
文章讨论AI测试代理在UI回归中产生误报通过(false pass)的风险:一位开发者的代理因关闭模态框后看到残留确认屏幕,将未完成的结账流程标记为通过,三天无人察觉并导致带缺陷上线。作者指出,误报通过比测试不稳定更危险,因为绿色通过掩盖问题。降低误报的四种手段包括:每步显式预期结果(效果最显著、成本最低)、第二模型作为裁判(成本翻倍但独立性存疑)、代理外硬断言(最可靠但依赖后端访问权限)、专用工具的内置防护如逐步报告和看门狗代理。社区共识是优先显式预期,组合硬断言与审计机制,并建立误报报告机制。
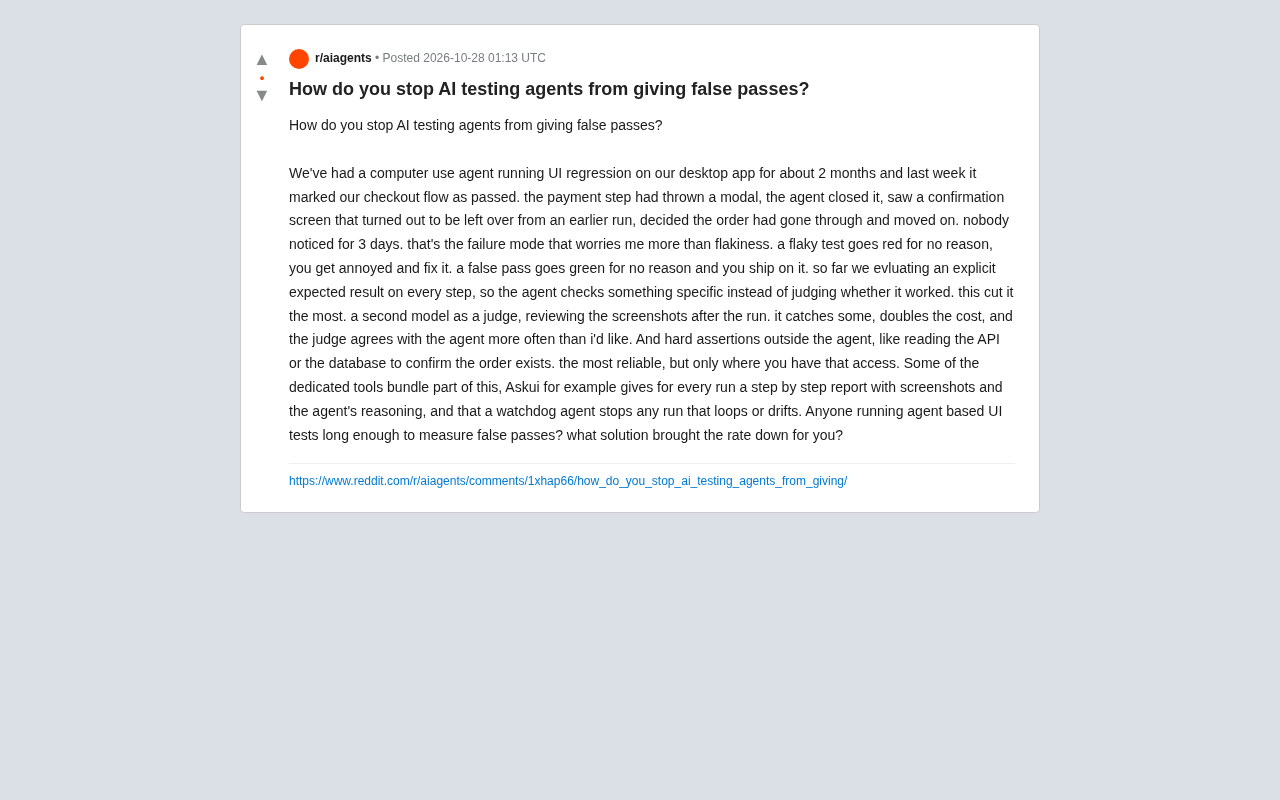
AI测试代理在UI回归中误报通过(false pass),比测试不稳定更危险。一位开发者在Reddit分享:他们的计算机使用代理运行桌面应用UI回归两个月,上周将结账流程标记为通过。实际支付步骤弹出了模态框,代理关闭后看到了一个来自早期运行的确认屏幕,便认定订单已完成。三天内无人察觉。这种静默失败——测试变绿却无实质通过——直接导致带缺陷上线。
为什么误报通过比测试不稳定更可怕
测试不稳定(flaky test)会无缘无故变红,你感到烦躁并修复它。而误报通过会无缘无故变绿,你基于它发布软件。两者的区别在于:红色失败触发行动,绿色通过掩盖问题。该开发者指出,误报通过是他们更担心的失败模式。
在UI回归中,代理需要判断每一步是否成功。如果判断基于模糊的“看起来正常”,就容易受到残留状态、模态框遮挡、时序错位的影响。上述案例中,代理关闭模态框后看到一个残留的确认屏幕,误以为订单已成功。这个错误持续了三天未被发现。
UI回归测试(UI regression testing)是指在每次代码或配置变更后,自动化地重新执行一组覆盖关键用户流程的界面测试,以确保已有功能未被破坏。它通常运行在持续集成(CI)流水线中,失败会阻断合并或发布。传统的UI回归依赖脚本化的定位器和断言,而AI测试代理则用视觉或自然语言推理来替代硬编码断言,这使得它更适应界面变化,但也引入了判断不确定性。误报通过(false pass)即测试实际未验证成功却报告通过,属于静默失败;与之相对的测试不稳定(flaky test)则是在相同代码下结果时红时绿。行业里常用逃逸缺陷(escaped defect)来描述本应被测试拦截却流入生产的缺陷,误报通过正是逃逸缺陷的主要来源之一。
降低误报通过率的四种手段
开发者尝试了多种方法,效果和成本各不相同。
1. 每步显式预期结果(效果最显著)
要求代理在每一步检查一个具体的东西,而不是由代理自行判断“是否成功”。例如,不仅检查“页面显示确认信息”,而是明确预期“订单ID出现在确认区域且状态为已支付”。开发者表示,这一措施“削减误报最多”。
显式预期结果将判断标准从代理的主观评估转变为可验证的条件。代理不再需要“理解”成功与否,只需比对预期与实际。这降低了因残留状态或时序问题导致的误判。
硬断言(hard assertion)与AI代理的“软判断”相对:硬断言是确定性的程序化检查,条件不满足即抛出失败,不依赖模型解释。在UI测试中,硬断言可以是检查某个元素文本等于预期值、某API返回200且响应体包含订单ID,或直接查询数据库确认记录存在。它的可靠性来自可重复性与不可绕过性,但维护成本较高,界面一改就可能失效。网络拦截(network interception)是介于UI与后端之间的折中手段:代理或测试框架捕获页面发出的HTTP请求,校验请求参数与响应内容,从而在不直接访问数据库的情况下验证业务动作是否真实发生。这类断言把验证点从“看起来成功”下沉到“数据或协议层面成功”,能有效识别残留屏幕和模态框遮挡造成的假象。
2. 第二模型作为裁判(成本翻倍,效果有限)
使用另一个模型在运行后审查截图。开发者指出,它能捕捉一些误报,但成本翻倍,而且裁判与代理意见一致的情况“比我希望的更多”。这意味着第二模型并不独立,可能共享相同的偏差或盲点。
第二模型的优势在于事后审查,可以引入不同的视角。但开发者未说明裁判模型是否与执行模型不同架构或训练数据。如果两者相似,一致性可能只是共同错误。
3. 代理外硬断言(最可靠,依赖访问权限)
在代理之外使用硬断言,例如读取API或数据库确认订单存在。开发者称这是“最可靠”的方法,但仅限于你有相应访问权限的场景。对于桌面应用,可能无法直接访问后端API或数据库,因此适用范围受限。
硬断言不依赖UI状态,直接验证系统状态。如果订单确实存在于数据库,UI上的确认屏幕才可信。这种方法将验证从表现层下沉到数据层,大幅减少误报。
4. 专用工具的内置防护(部分自动化)
一些专用工具集成了部分上述能力。开发者举例Askui,它为每次运行提供逐步报告,包含截图和代理的推理过程。此外,一个看门狗代理会停止任何循环或偏离的运行。
看门狗代理可以防止代理陷入无限循环或偏离预期路径。逐步报告则提供了审计轨迹,便于事后分析误报原因。但这些内置防护是否足以消除误报,取决于工具的实现细节。
多源视角:社区共识与分歧
据Reddit帖子及评论区讨论(来源单一,但反映一线实践),显式预期结果被多位开发者认为是性价比最高的措施。有评论者提到,将预期结果写成可执行的断言(如检查特定元素文本或API响应)比让代理自由判断更可靠。
关于第二模型裁判,存在分歧。部分开发者认为裁判模型应使用不同供应商的模型以避免共同偏差,另一些人则认为成本翻倍不划算,不如投资硬断言。
硬断言被普遍认可为最可靠,但实施难度取决于系统架构。对于无法访问后端的场景,开发者建议至少使用网络拦截或文件系统检查作为折中。
专用工具的看门狗功能被认为是有用补充,但不能替代显式预期结果。有用户指出,看门狗只能阻止明显异常,无法判断业务逻辑是否正确。
实践建议:组合使用,优先显式预期
基于该开发者的经验和社区讨论,降低误报通过率需要组合手段。优先实施每步显式预期结果,这是成本最低、效果最明显的措施。其次,在可访问后端的环节加入硬断言。第二模型裁判可作为补充,但需注意模型独立性和成本。专用工具的看门狗和报告功能可作为审计和防护层。
开发者最后提问:有没有人运行基于代理的UI测试足够久以测量误报通过率?什么方案降低了你的误报率?这反映出该领域仍缺乏公开的量化数据,实践者依赖经验分享。
对于正在采用AI测试代理的团队,建议从显式预期结果开始,逐步引入硬断言,并建立误报通过的报告机制,避免静默失败。
相关推荐
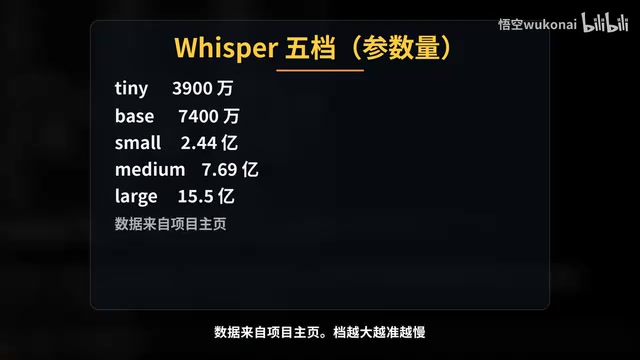
Claude Code实战:零代码搭建切片工厂,长视频自动变竖屏短视频
B站UP主悟空用Claude Code零代码搭建切片工厂,将35分钟长视频自动切成10条竖屏短视频。从Plan Mode、Whisper转写、claude.md规则、Hook质检到Subagent审核和Plugin分发,完整实战流程与实测数据。
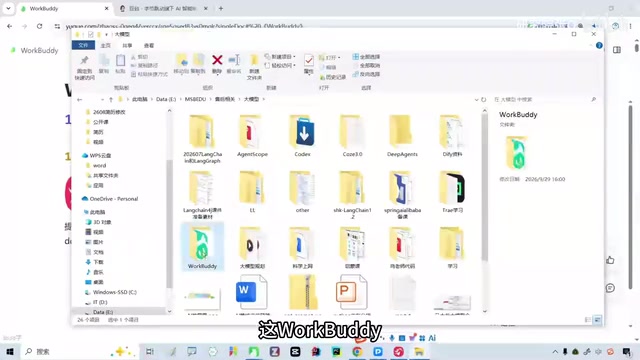
WorkBuddy保姆级教程:AI Agent如何帮你自动转文件
WorkBuddy保姆级教程实战:从豆包只能给方案到AI Agent直接动手,三分钟批量转换PDF并归档。含安装、积分机制、与Codex对比及上手建议。
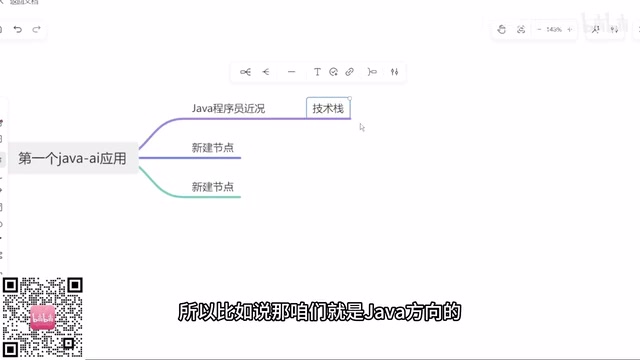
零基础入门Java+DeepSeek实战:程序员转型AI大模型开发指南
本文基于B站直播教学,详解Java程序员如何零基础转型AI大模型开发,涵盖技能路径、实战构建第一个Java AI应用、简历包装与求职策略,助你抓住大模型时代机遇。