AI产品隐形成本:切换应用触发重复计费的信任危机

一个被忽视的Bug,正在消耗用户信任
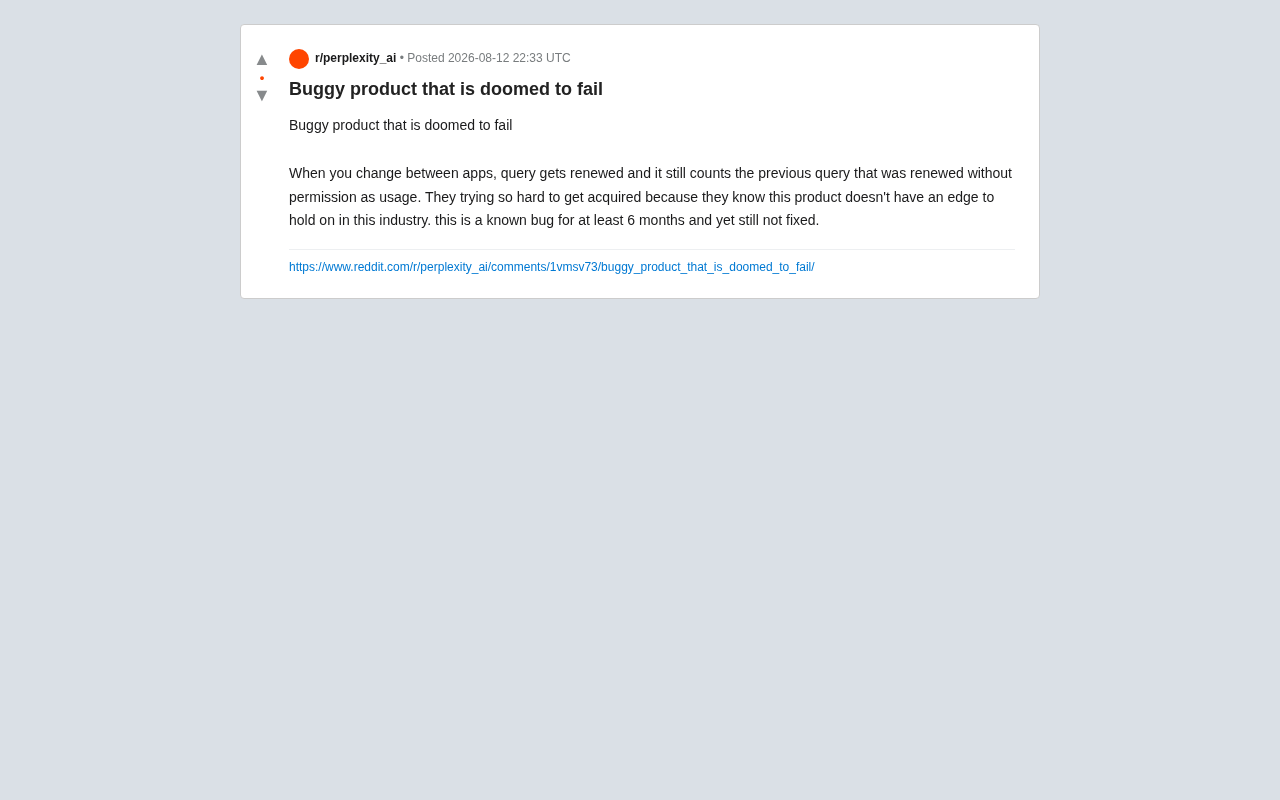
在AI工具竞争白热化的当下,产品的用户体验往往决定着生死存亡。近日,一位Reddit用户对某AI产品发出了措辞严厉的批评,直指其存在一个持续了至少6个月仍未修复的计费Bug——当用户在不同应用之间切换时,正在进行的查询会被"刷新",而这个未经用户许可就被重置的旧查询,竟然仍会被计入使用量。
这个看似技术细节的问题,实际上触及了AI订阅制产品最敏感的神经:计费的公平性与透明度。当用户为每一次查询付费或消耗额度时,任何"重复计费"都会被视为对信任的直接背叛。
切换应用触发重复计费的技术逻辑
为什么切换应用会导致额度被重复扣除?
从技术角度分析,这类问题通常源于前端状态管理与后端计费逻辑之间的脱节。当用户切换应用(例如从浏览器切到其他窗口再切回),前端可能会重新初始化会话状态,触发一次新的查询请求(query renewal)。
要理解这一问题的根源,需要了解现代Web应用的状态管理机制。前端状态管理框架(如React的useState、Redux、Zustand等)负责维护应用的UI状态,而后端API则独立处理业务逻辑。当用户切换应用时,移动端或桌面端的WebView可能触发页面的生命周期事件(如visibilitychange、pagehide/pageshow),导致组件重新挂载或会话重新初始化。
更深层来看,W3C的Page Lifecycle API定义了多个页面状态(active、passive、hidden、frozen、terminated),每个状态转换都可能触发不同的浏览器行为。在移动设备上,当用户切换应用时,浏览器可能将页面从active状态降级为frozen状态,此时JavaScript执行被暂停,定时器停止,WebSocket连接可能断开。当用户返回时,页面从frozen恢复到active,此过程可能触发Service Worker的重新激活、缓存的重新验证以及未完成请求的超时处理。如果应用使用了SPA(单页应用)框架但未正确处理这些生命周期事件,组件可能错误地认为需要重新获取数据,从而发起重复的API请求。如果前端没有实现请求去重(deduplication)或幂等性token机制,同一个用户意图就可能产生多次API调用。
问题在于:旧的查询请求可能并未被正确取消或标记为无效。后端在收到新请求时,会将其作为一次独立的使用计入额度,而被"遗弃"的旧请求也已经产生了计费记录。结果就是——用户实际只获得了一次有效结果,却被扣除了两次额度。
这类竞态条件(race condition)问题在异步Web应用中并不罕见。竞态条件是并发编程中的经典问题,指两个或多个操作的执行顺序不确定时,导致系统进入非预期状态。在普通应用中,竞态条件可能只造成重复渲染或短暂的UI闪烁,但对于以"查询次数"作为核心计费单位的AI产品而言,它直接损害了用户的经济利益——每一次非预期的额度消耗都意味着真实的金钱损失。
AI产品计费模式的特殊敏感性
AI产品的计费模式经历了从免费试用到订阅制再到按量付费的快速演变。早期的ChatGPT采用月度订阅+无限使用的模式,但随着推理成本的差异化(GPT-4的推理成本约为GPT-3.5的30-60倍),行业逐步转向"基础订阅+额度限制"或纯token计费模式。Claude、Gemini等产品也采用了类似的分层策略。
AI推理成本的结构性差异是理解当前计费模式的关键背景。以OpenAI为例,GPT-4 Turbo的输入token定价为$10/百万token,输出为$30/百万token,而GPT-3.5 Turbo仅为$0.5/$1.5。更复杂的推理模型如o1-preview,由于需要多步思维链推理,单次查询可能消耗数千甚至数万token,成本可达普通查询的数十倍。Anthropic的Claude 3 Opus同样存在显著的成本层级。这种成本结构迫使产品方在"用户体验"和"成本控制"之间艰难平衡,催生了各种精细化的额度管理机制——包括每日/每月查询限额、不同模型的差异化计费、以及基于上下文长度的动态定价。
在这种模式下,每一次查询都对应着可量化的成本和额度消耗,用户对"浪费"的感知被极度放大。与传统SaaS的席位付费不同,按次计费将用户置于一种"每次点击都在花钱"的心理状态中,任何非自愿的额度消耗都会引发强烈的不信任感。
为什么6个月都没修复?
用户特别强调,这是一个"已知超过6个月仍未修复"的Bug。从产品管理的视角看,这背后可能有几种原因:
- 优先级排序问题:团队可能将资源集中在新功能开发上,认为该Bug影响范围有限。
- 技术债务积累:修复计费逻辑往往需要触及核心系统,牵一发而动全身,团队可能因风险而拖延。
- 动机缺失的隐忧:如果Bug导致的是用户被"多扣费"而非平台亏损,那么修复它对平台收入而言并无直接好处——这是最令用户担忧的一种解读。
技术债务(technical debt)概念由Ward Cunningham在1992年提出,用以类比软件开发中为追求短期交付速度而做出的次优技术决策所累积的长期成本。在AI创业公司中,技术债务的积累速度往往更快——团队需要快速迭代模型接入、prompt工程、上下文管理等前沿功能,而基础设施(包括计费系统、错误处理、状态同步等)往往被视为"能跑就行"。计费系统的修复尤其棘手,因为它通常横跨前端、后端、数据库和支付网关等多个系统边界,修改任何一环都可能引入新的一致性问题。团队常常陷入"修复风险大于容忍风险"的判断中,直到问题在公开平台爆发。
从计费Bug到品牌信任危机
"急于被收购"的指控说明了什么
这位用户的批评中还包含一个尖锐的判断:该产品"拼命想被收购,因为他们知道这个产品在这个行业里没有可以立足的优势"。
虽然这只是单一来源的主观推测,缺乏直接证据,但它反映了一种在AI创业圈普遍存在的焦虑。2023-2024年间,AI应用层(Application Layer)公司面临着前所未有的生存压力。OpenAI、Google、Anthropic等基础模型公司不断向下游延伸,推出ChatGPT Plugins、Gemini Extensions等功能,直接侵蚀了大量"套壳"应用的生存空间。据a16z的分析,许多AI应用的用户留存率在90天后低于20%,因为用户可以用更低成本获得类似能力。
根据Sequoia Capital的分析框架,AI公司的价值捕获主要发生在三个层面:基础设施层(芯片、云计算)、模型层(基础大模型)和应用层(面向终端用户的产品)。应用层公司面临的核心问题是"可替代性"——当底层模型能力快速趋同时,仅依赖API调用构建的应用缺乏技术壁垒。CB Insights数据显示,2024年上半年AI领域的并购交易同比增长超过60%,其中大量是大厂收购应用层创业公司以获取其用户基础和垂直领域的数据资产。这种市场整合趋势使得部分创业公司从创立之初就将"被收购"作为主要退出路径来设计商业策略。
在大厂不断推出免费或低价功能的挤压下,许多缺乏技术护城河的AI应用层产品确实面临着严峻的生存压力。部分公司转向了"收购退出"策略——通过积累用户数据、建立品牌认知或占据细分市场位置来吸引大厂收购,而非追求独立盈利。这种策略转向往往伴随着对产品质量投入的下降。
当一款产品的运营重心从"打磨体验、留住用户"转向"包装故事、寻求退出"时,长期存在的用户体验问题得不到修复,也就不足为奇了。
计费透明度:AI订阅制产品的生命线
无论指控是否属实,这个案例都为整个行业敲响了警钟。在SaaS和AI订阅模式中,计费透明度是最基础也最不容妥协的底线:
- 用户对"额度"高度敏感:与传统软件的一次性付费不同,按次或按量计费让用户对每一次消耗都格外在意。
- 重复计费=信任崩塌:一次被察觉的错误扣费,足以让用户产生"这个平台在偷偷占我便宜"的印象,而这种印象极难挽回。
- 口碑传播的放大效应:一条Reddit帖子、一次社交媒体吐槽,都可能在潜在用户群中形成负面预期。
行为经济学中的"损失厌恶"理论进一步解释了用户反应为何如此强烈——人们对损失的心理感受强度约为等额收益的2-2.5倍。当用户发现自己被多扣了一次查询额度时,其心理不满程度远超"获得一次免费额度"所带来的满足感。这意味着,即使平台后续进行补偿,也难以完全修复已造成的信任损伤。
对AI产品团队的启示与最佳实践
计费逻辑必须做到"宁可少算,不可多算"
对于任何涉及用量计费的产品,工程团队应当建立明确的原则:在计费的模糊地带,永远向有利于用户的方向倾斜。一次因取消而废弃的查询,不应计入用户额度。这不仅是技术正确,更是商业伦理。
实现这一原则的技术基础是幂等性(idempotency)设计——这是分布式系统设计中的关键原则,指同一操作执行一次和执行多次的效果完全相同。在计费系统中实现幂等性,通常需要:
- 唯一幂等键:为每次用户意图生成唯一的幂等键(idempotency key),确保重复请求不会产生重复扣费;
- 两阶段提交:采用"预扣-确认-回滚"模式,只有在用户实际获得有效结果后才确认扣费;
- 请求去重层:在网关层面识别并合并短时间内的重复请求。
在实际的分布式系统中,实现幂等性面临诸多工程挑战。幂等键的存储与过期策略需要精心设计——键需要在一定时间窗口内保持有效,既不能过短(导致合法的重复请求被误判为新请求),也不能过长(导致存储成本过高)。在分布式环境下,当请求被负载均衡到不同的后端节点时,需要共享的幂等键存储(通常使用Redis等分布式缓存),而这又引入了缓存一致性和网络分区的额外复杂性。Stripe的做法是将幂等键与请求体的哈希值绑定,存储在具有48小时TTL的分布式缓存中,同时结合数据库层面的唯一约束来提供最终一致性保证。
Stripe等支付平台已将幂等性作为API设计的核心原则,AI产品的计费系统理应采用同等严格的标准。
建立Bug的"信任影响"评估维度
传统的Bug优先级评估往往基于影响范围和严重程度,但对于计费类Bug,还应引入"信任影响"这一维度。一个只影响少数用户但直接损害其经济利益的Bug,其对品牌信任的破坏力,可能远超一个影响面广但无关痛痒的显示错误。
具体而言,产品团队可以建立如下评估矩阵:将Bug按"技术严重性"和"信任影响度"两个维度进行四象限分类。涉及金钱、隐私和数据安全的问题,即使技术上只是边缘case,也应当被提升至最高优先级。这种评估框架能够帮助团队避免陷入纯技术视角的盲区。
这种方法论与Google的SRE(站点可靠性工程)团队提出的"错误预算"(error budget)概念有异曲同工之处。错误预算的核心思想是:系统的可靠性目标应当由业务需求驱动,而非单纯的技术指标。类比到计费Bug领域,产品团队应当设定"计费准确性SLO"(服务等级目标),例如"99.99%的查询计费准确率",并将任何偏离该目标的情况视为必须立即响应的事件。
主动沟通胜过沉默修复
如果Bug确实存在且短期内难以彻底修复,及时向用户说明情况、提供额度补偿或退款机制,远比让用户自己发现问题后到公开平台声讨要好得多。透明的态度本身,就是重建信任的重要一步。
在危机沟通领域,"承认-补偿-改进"的三步框架已被证明是最有效的信任修复策略。对于AI产品而言,这可以具体化为:在产品内公开已知问题列表(类似于status page)、自动检测并退还异常扣费的额度、以及定期发布技术改进报告。这些措施的成本远低于一次公关危机所带来的用户流失。
值得参考的是,Notion、Linear等SaaS产品已建立了成熟的公开changelog和incident response机制。当出现影响用户的问题时,这些公司会在数小时内发布公开声明,详细说明问题原因、影响范围、临时解决方案和永久修复时间表。这种透明度不仅没有削弱用户信心,反而成为了品牌差异化的一部分——用户会因"这家公司对我足够诚实"而产生更强的品牌忠诚度。
结语
这条来自Reddit的单一用户反馈,或许带有情绪化的表达,其中"注定失败""急于被收购"等判断也需要更多证据支撑。但它精准地揭示了一个AI产品竞争中的核心命题:在技术同质化日益严重的今天,产品的护城河不仅在于模型能力,更在于对用户的诚实与尊重。
一个持续半年未修的计费Bug,消耗的从来不只是用户的额度,更是产品赖以生存的信任资本。对于每一个AI创业团队而言,这都是一堂值得警醒的必修课。在一个用户可以零成本切换到竞品的市场环境中,信任一旦失去,往往意味着用户的永久流失——而重建信任所需的投入,将远远超过当初修复Bug本身的成本。
相关推荐

黑人觅食者Alexis Nelson:从觅食到出书,快乐零食别死
黑人觅食者Alexis Nikole Nelson做客Talks at Google,分享从童年跟随母亲认识植物到出版食谱书《Happy Snacking, Don't Die!》的旅程,揭示美国觅食兴衰背后的种族与土地历史。

如何有效呈现你的想法:三种揭示式演讲方法
揭示式演讲是传递想法最直接的方式。本文解析奇妙漫步、动态演示和梦想图景三种演讲类型,结合David Gayo、Michael Pritchard、Sylvia Earle等经典案例,教你如何有效呈现想法。

Modern Web Guidance:让AI写原生声明式对话弹窗
Google Modern Web Guidance 让 AI 编程助手在生成代码时优先使用浏览器原生声明式 dialog 能力,替代重复的 JavaScript 事件监听,实测可显著减少样板代码。