AI大厂集体降价:Seedance 2.5成本减半,GPT-6与Opus 5.5同日发布
字节、OpenAI、Anthropic同日降价提速,国产开源模型挤压推动AI使用成本持续走低。
AI行业迎来一轮密集的价格竞争:字节跳动Seedance 2.5推出"样片模式",以480p低分辨率预览替代盲目高清生成,将视频制作成本压低30%到77%;OpenAI同日发布GPT-6.0与Luna,借助更高缓存命中率将价格较GPT-5.6削减约50%;Anthropic的Opus 5.5则在保持旗舰性能的同时,将输出速度提升30%、Agent任务成本降低40%。三家大厂几乎同时祭出"更快更便宜"策略,被解读为国产开源模型持续逼近闭源能力上限、压缩其定价空间所致。对终端用户而言,这场价格战的红利正在加速传导,AI应用的使用门槛持续下降。
AI行业正在进入一轮明显的价格竞争周期。字节跳动的Seedance 2.5推出了大幅降低试错成本的新模式,OpenAI与Anthropic几乎在同一天更新旗舰模型,且都把"更快、更便宜"作为核心卖点。据B站AI内容频道EVER AI的整理,这轮降价潮的背后,是国产开源模型持续发力对海外大厂形成的价格挤压。
Seedance 2.5:样片模式如何把成本砍半
视频生成模型在实际使用中有个绕不开的痛点——盲抽成片。用户往往需要反复生成才能得到满意结果,而每一次高清生成都意味着算力和费用的消耗,试错成本居高不下。
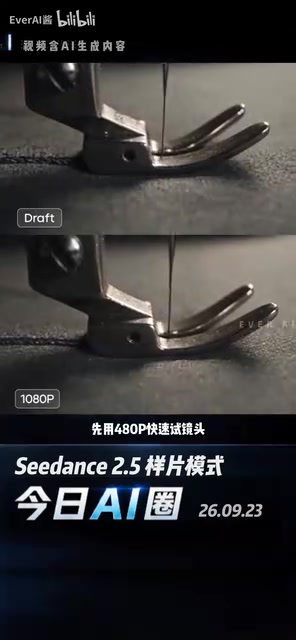
字节为Seedance 2.5引入的"样片模式"正是针对这一环节。它的逻辑很直接:先用480p低分辨率快速试镜头,预览画面构图、动作走向和整体效果,确认满意后再进入1080p成片阶段。这种"先草稿后定稿"的工作流,对动作复杂、难以把控的镜头尤其有价值。
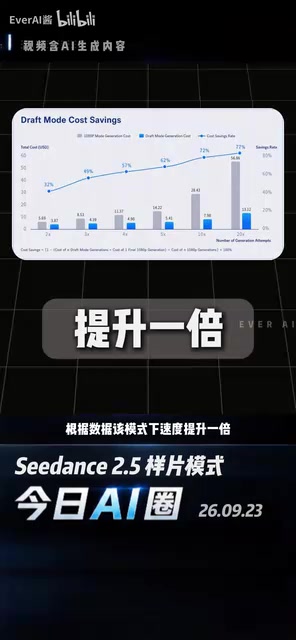
根据其公布的数据,该模式下生成速度提升一倍,成本降幅在30%到77%之间。这个区间跨度较大,说明节省幅度与具体镜头的复杂度和试错次数强相关——越是需要反复调整的镜头,低分辨率预览带来的成本节约就越显著。
OpenAI双模型更新:GPT-6.0与Luna主打性价比
同一天,OpenAI一口气推送了两款模型更新——GPT-6.0与Luna。据EVER AI的介绍,这两款模型采用了与Astra类似的训练方法,能力上属于"小步提升",但换来了更快的响应速度和更实惠的价格。
这次更新的一个关键技术点在于更高的缓存命中率。缓存命中意味着模型在处理重复或相似内容时能复用已有结果,从而少消耗Token。对于高频调用API的开发者和企业用户来说,Token消耗直接等同于成本,缓存优化的收益会在规模化使用中被成倍放大。
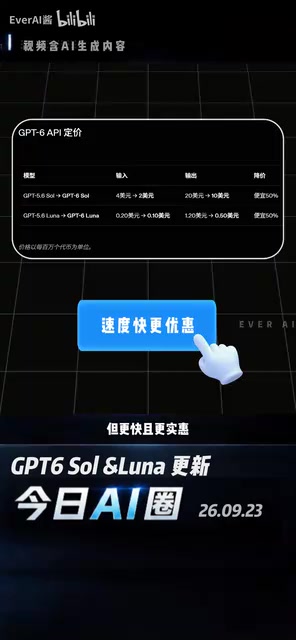
综合下来,相较于GPT-5.6,新模型的价格下降了约50%。这种"能力微增、价格腰斩"的策略,反映出OpenAI在当前竞争环境下的取舍——与其在能力上追求跨越式突破,不如先在成本效率上巩固用户黏性。
缓存命中率(Cache Hit Rate)是API调用成本优化中的关键指标。大语言模型在处理请求时,如果输入的前缀(Prompt前段)与之前的请求高度重叠,系统可以直接复用已计算的KV缓存(Key-Value Cache),跳过重复的注意力计算。OpenAI、Anthropic等平台通常对缓存命中的Token收取远低于正常价格的费用——有时低至正常价格的10%到25%。对于系统提示词(System Prompt)较长、且每次调用内容高度相似的企业应用来说,缓存命中率从50%提升到80%,实际账单成本的降幅可以超过表面上的价格下调幅度。因此"更高缓存命中率"不仅是工程侧的技术改进,也是OpenAI向API重度用户传递成本收益的核心卖点。
Anthropic反击:Opus 5.5更快更省
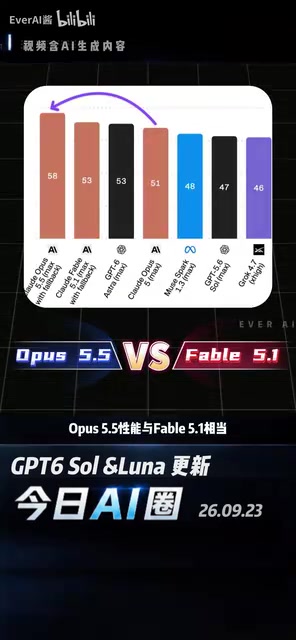
Anthropic在同一时间节点祭出了Opus 5.5。据介绍,在大多数任务上,Opus 5.5的性能与Fable 5.1相当,属于稳中有升的定位。
但真正的看点同样在效率层面:Opus 5.5的输出速度比Opus 5.0快了约30%,而在Agent任务中,成本比Opus 5.0降低了40%。Agent任务通常涉及多轮推理和大量工具调用,Token消耗巨大,成本敏感度极高。Anthropic在这一场景下重点优化成本,显然是瞄准了正在快速增长的AI Agent应用市场。
从这些网友实测的生成效果来看,模型在保持质量的同时提升效率,正是当前旗舰模型迭代的主流方向。
AI Agent任务之所以成本极高,根源在于其工作模式与单次问答截然不同。Agent需要自主规划多个子任务、反复调用外部工具(如搜索、代码执行、数据库查询),并在每一轮调用中将完整的历史对话上下文重新输入模型——随着任务推进,上下文长度持续累积,Token消耗呈非线性增长。一个复杂的Agent任务可能涉及数十轮模型调用,总Token消耗轻易超过单次对话的百倍。正因如此,Agent场景对成本极度敏感,40%的成本降低在规模化部署中意味着极大的经济收益,也是各大模型厂商将Agent成本优化单独列出、作为重点宣传指标的原因。
降价潮背后:国产开源的挤压效应
三家大厂在同一时间窗口密集推出"降价+提速"的更新,很难说是巧合。EVER AI给出的解读是:国产开源模型发力太猛,海外闭源大厂被迫开启价格内卷。
这个判断有其合理性。当开源模型在能力上不断逼近闭源产品,且天然具备成本优势时,闭源厂商的定价空间会被持续压缩。为了留住对成本敏感的中小开发者和企业客户,大厂只能通过训练方法优化、缓存机制改进等技术手段压低单位调用成本,把降价空间让渡给用户。
对使用者而言,这无疑是好消息——无论是视频生成的Seedance 2.5,还是文本与Agent场景的GPT-6.0、Opus 5.5,都在朝着"用更少的钱办更多的事"演进。价格战的本质,是竞争红利向终端用户的传导。
需要提醒的是,以上模型名称、版本号和具体数据均来自单一来源整理,部分产品命名(如Luna、Fable、Astra等)尚需以官方发布为准,读者在实际选型时建议核对第一手信息。
国产开源模型对闭源大厂形成价格挤压的机制值得展开说明。以DeepSeek广告、Qwen等为代表的国产开源模型,凭借MIT或Apache等宽松协议向外发布,任何企业都可以在自有服务器上部署,从而将每次调用的边际成本压缩到接近零。这对闭源API厂商的定价逻辑构成根本性冲击——当企业能以极低的硬件成本自托管一个能力接近的开源模型时,闭源API的溢价空间便大幅收窄。海外大厂面临的选择是:要么维持高价并接受客户流失,要么通过技术优化(缓存、蒸馏、量化推理等)压低成本、向下调价以守住市场份额。当前这轮集中降价,正是后一种策略的集中体现。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。