AI代理的“视觉思维”:一场静默的认知革命
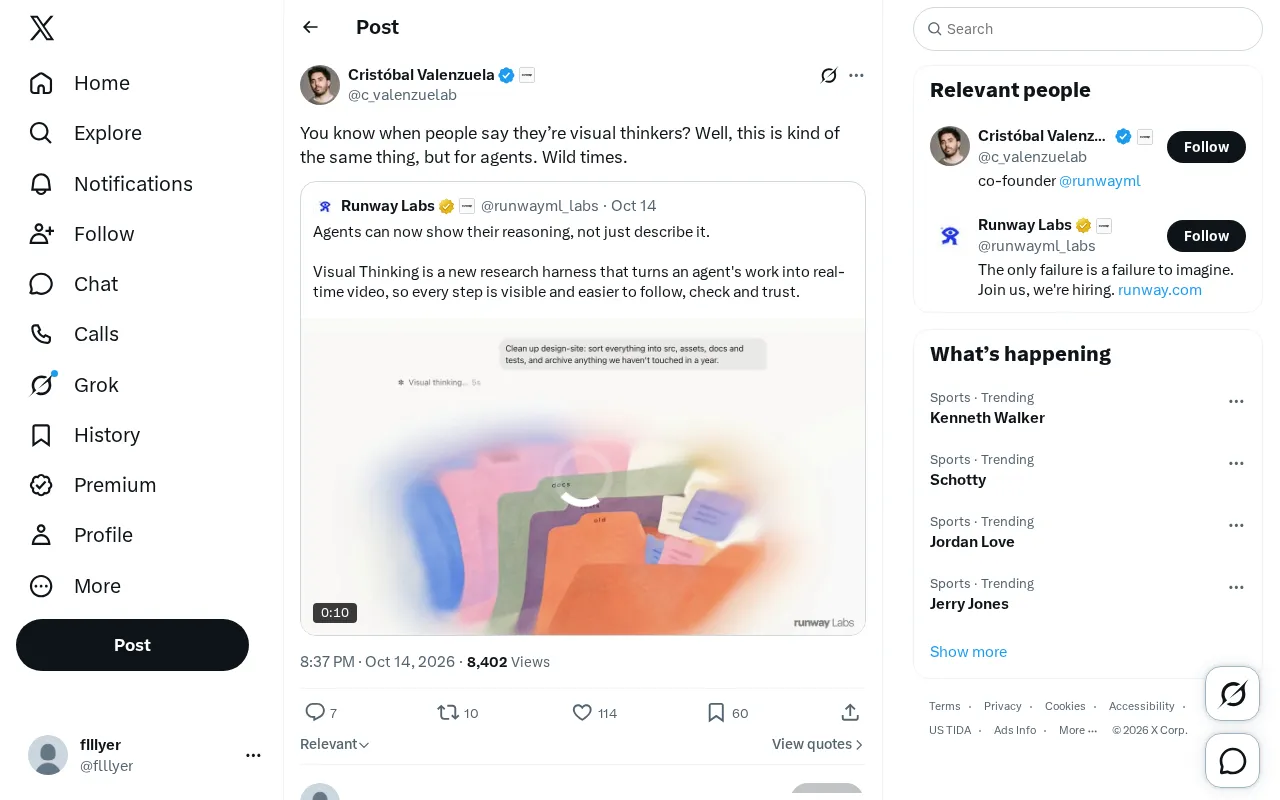
AI代理正获得类似人类的视觉思维能力,通过内部视觉表征进行推理与规划。
文章探讨了AI代理领域一个新兴趋势:赋予代理“视觉思维”能力,即通过构建和操作内部视觉表征来理解世界、规划行动,而非仅依赖文本推理链。这一转变建立在多模态大模型和视觉链式思考等技术基石之上,让代理能在空间推理、物理交互等任务中表现更优。应用前景涵盖软件自动化(视觉操作图形界面)和具身智能机器人(行动前心理预演)。然而,视觉思维也带来可解释性下降、计算成本高和评估标准缺失等挑战,研究界在符号化推理与端到端视觉推理之间存在路线分歧。
当代理开始“看图思考”
“你知道有些人自称是视觉思考者吗?嗯,这有点像那回事,但对象是AI代理。疯狂的时代。”这条来自Twitter的简短推文,配上截图,精准地捕捉到了当前AI领域一个微妙却关键的转向:我们正在赋予AI代理一种类似人类“视觉思维”的能力。
这不是指简单的图像识别,而是指代理能够在其决策过程中,构建、操作和利用内部视觉表征来理解世界、规划行动。这听起来像是科幻,但却是当下多模态AI研究最前沿的方向之一。
什么是代理的视觉思维?
人类在解决问题时,并非总是依赖语言。我们会在脑海中想象物体的旋转、空间的布局、动作的后果。这种“心理模拟”能力是智能的重要标志。
对于AI代理而言,传统的范式是基于文本的推理链。代理接收文本指令,生成文本计划,执行文本动作。但这种方式在涉及空间关系、物理交互和复杂环境导航时,显得力不从心。
代理的视觉思维,意味着代理不再仅通过文字“思考”,而是通过视觉表征来“想象”和“规划”。 例如,一个机器人在抓取杯子前,会先在内部“看到”杯子的三维结构、抓取点的位置,以及手臂移动的轨迹。这种能力将代理的推理从一维的文本序列,扩展到了二维甚至三维的视觉空间。
技术基石:从多模态感知到视觉推理
这一转变并非凭空发生。它建立在过去几年多模态大模型和具身智能研究的深厚积累之上。
多模态大模型的进化
早期的视觉模型只能做分类或检测。而如今的大模型,如GPT-4V、Gemini等,已经能够联合理解图像和文本。它们不仅能“看”到图像中的物体,还能“理解”物体间的关系和隐含的物理常识。这为代理提供了基础的视觉感知和描述能力。
视觉链式思考与内部表征
更进一步的研究,如视觉链式思考,让模型在生成答案前,先生成一系列视觉中间步骤。这类似于人类在纸上画草图来辅助思考。代理不再只是输出文本,而是输出对图像的标注、区域分割或生成的示意图,作为推理的中间产物。
据B站UP主和YouTube频道对相关论文的解读,这种“视觉草稿”能显著提升模型在空间推理和复杂问题解答上的表现。 多个独立分析都指向一个共识:引入视觉思维环节,是提升代理环境理解和规划能力的关键路径。
视觉链式思考(Visual Chain-of-Thought, VCoT)是文本链式思考在视觉模态上的延伸。其核心思想是:模型在给出最终答案前,先生成一系列中间视觉产物——可能是对图像的局部标注、关键区域的裁剪、示意性草图,甚至是生成的新图像。这些视觉中间步骤充当“思维草稿”,帮助模型将复杂的空间或物理推理分解为可管理的子问题。与纯文本推理链相比,VCoT 的优势在于它直接操作与问题同构的表征(如空间布局),避免了将三维关系强行压缩为一维文字序列时产生的信息损失。研究表明,在需要多步空间推断的任务中,引入视觉草稿能显著提升准确率。
应用前景:从虚拟助手到具身智能
代理的视觉思维将首先在哪些领域爆发?
更聪明的虚拟助手与自动化流程
在软件自动化领域,代理需要操作图形界面。具备视觉思维的代理可以“看着”屏幕,理解按钮、菜单和窗口布局,从而更鲁棒地完成点击、拖拽等操作,而不是依赖脆弱的DOM选择器。
DOM 选择器(Document Object Model Selector)是软件自动化中定位网页元素的传统方式,例如通过元素的 ID、类名或 XPath 路径来找到按钮或输入框。然而,当页面结构动态变化、元素被遮挡或渲染方式复杂时,DOM 选择器极易失效。具备视觉思维的代理则另辟蹊径:它直接“看”屏幕截图,像人类一样识别按钮、菜单和窗口的视觉特征,从而绕开对底层代码结构的依赖。这种视觉驱动的操作方式更鲁棒,也更接近真实用户的交互模式,是构建通用软件自动化代理的关键能力之一。
具身智能与机器人
这是最激动人心的应用场景。机器人需要在物理世界中导航、操作物体。视觉思维让机器人能够在行动前进行“心理预演”,预测动作后果,避免危险。据单一来源的独特见解,一些前沿实验室正在探索让机器人通过观看人类视频,直接学习并构建内部视觉模型,实现更自然的人机协作。
具身智能(Embodied AI)强调智能体必须拥有物理身体,并通过与环境的实时交互来学习和进化。与纯软件代理不同,具身智能体面临连续的状态空间、物理约束和实时性要求。视觉思维在此扮演关键角色:机器人需要在行动前构建对物体三维结构、抓取点、运动轨迹的内部模拟,这种“心理预演”能大幅降低试错成本。当前主流路径包括在仿真环境中训练视觉-运动策略,以及通过观看人类视频进行模仿学习。后者尤其依赖代理将观察到的视觉序列转化为可执行的内部行动计划,是实现自然人机协作的重要前提。
挑战与未知:思维的黑箱与可解释性
赋予代理视觉思维并非没有代价。它带来了新的挑战。
可解释性的下降。 文本推理链本身已经难以解释,而当推理过程发生在高维视觉空间中时,人类更难理解代理为何做出特定决策。我们如何调试一个“想”错了的视觉脑?
计算成本与实时性。 生成和操作内部视觉表征需要大量计算。对于需要实时响应的应用,如自动驾驶或高频交易,这是一个现实的瓶颈。
评估标准的缺失。 我们如何衡量一个代理的视觉思维“好不好”?传统的准确率指标不足以捕捉空间推理和规划的质量。学术界和工业界仍在探索新的评估基准。
这些挑战也引出了分歧。一部分研究者认为,应当坚持可解释的符号化推理,将视觉思维作为辅助;另一部分则主张,拥抱端到端的视觉推理,接受一定程度的黑箱,以换取更强的能力。两种观点在近期的AI顶会上交锋激烈,目前尚无定论。
结语:思维的形态正在被改写
那条推文所说的“疯狂的时代”,其疯狂之处不在于技术本身,而在于它暗示了一种可能性:智能的载体和形式远比我们想象的更加多元。视觉思维曾是人类引以为傲的独特能力,如今我们正尝试将其赋予机器。这不仅仅是技术路线的拓展,更是对“思考”本身定义的一次静默革命。代理们正在学会“看见”世界,而我们将见证它们由此走向何方。
相关推荐

用十几个Agent搭建黑灯工厂:Lauren Tan的信任阶梯与米其林厨房
Lauren Tan分享用十几个协调Agent每月合并超2500个PR的实战经验:从信任阶梯、米其林厨房隐喻到验证技能与内外循环连接,揭示黑灯工厂背后的环境工程哲学。

GPT-6.1 Terra深度解读:中端模型的视觉与电脑使用定位
OpenAI发布GPT-6.1 Terra,主打视觉推理与电脑操作,定价介于旗舰Sol与轻量Luna之间。本文解读其中端定位、定价策略、适用场景及推理等级实测表现。

OntoGr:为Agent记忆加上引用溯源与双时间轴
OntoGr Agent Memory 是一个开源 Python 库,为 AI Agent 记忆中的每条事实保留逐字引用、来源与双时间轴,支持可逆实体消解、冲突裁决与四路召回检索,解决 Agent 记忆的信任与可追溯问题。