AI代码工厂实战:GitHub上部署10个Agent自动改Bug

软件工厂将单一编程Agent升级为可调度的Agent集群,通过GitHub issue自动派单并始终保留人工审核。
软件工厂(Software Factory)是编程Agent的进阶架构范式:它不是一个Agent,而是一套调度系统,能同时管理约10个混合了Claude Code与Codex的编程Agent,通过GitHub issue触发任务、自动分诊派单、执行后生成PR供人工审查。整个工作流遵循「信号-分诊-执行-发布」的核心循环,始终保留human in the loop。每个Agent运行在独立的云端VPS沙箱中,既防范prompt injection攻击,又实现资源隔离与永远在线。不同模型按长处分工(Claude擅长复杂逻辑、Codex擅长3D工作),借助可复用的Agent Skill和快照机制,整套工厂几乎无需手写代码即可部署和扩容,是适合规模化使用编程Agent的团队的参考架构。
什么是软件工厂(Software Factory)
如果你已经习惯了和单个编程Agent对话,那么「软件工厂」可能是下一步的进化方向。它不是让你盯着某一个Agent的会话窗口,而是拥有一整支处于待命状态的Agent集群——这些Agent就像流水线上的工人,等着任务被分配下来。
据这位海外开发者在B站转载视频中的演示,一个典型的软件工厂能同时管理约10个编程Agent,它们混合了 Codex 和 Claude Code 两种模型,可以跨多个项目协作。工作流很简单:在 GitHub 上创建一个 issue,打上「ready」标签,工厂就会把任务自动派发给某个空闲的Agent。Agent完成后会提交一个 Pull Request 供人工审查。
需要强调的是,软件工厂本身不是编程Agent,而是一套负责调度的系统或程序。它接收来自 Slack、Telegram 或 GitHub issue 的触发信号,做一轮分诊(triage),再把任务派给合适的Agent。这套机制中始终保留了「human in the loop」——它不是让Agent完全自主运行的「黑灯工厂」,而是带人工审核关卡的自动化流水线。
工厂的核心循环:信号、分诊、执行、发布
整个工厂的运作可以拆解成一个清晰的循环:
- 信号(Signal):任何能触发工厂的事件,可以是 GitHub issue,也可以是一条 Slack 消息。
- 分诊(Triage):接收任务并决定派给谁。这一步可以用 LLM 对任务分类(比如判断是 bug、新功能还是文档更新),也可以像作者示范的那样,仅用一段简单代码抓取任务分配给空闲Agent,完全不涉及LLM。
- 执行(Implement):某个编程Agent实现改动,并通过单元测试、代码审查等护栏(guardrails)做验证。
- 发布(Release):创建 Pull Request 或直接部署代码,然后工厂继续监听新的变化。
这个循环里你可以插入任意数量的人工关卡——架构决策、破坏性变更、线上事故处理,或者最基础的审查合并 PR。作者的实现里,分诊步骤实际是一个「dispatcher」:收到 issue 后分配给空闲Agent,如果没有可用Agent就持续重试;如果用户在标签里指定了 Codex 或 Claude Code,就派给对应的Agent。
为什么要混用不同的Agent
一个容易被忽视的价值点是:软件工厂让你能发挥不同模型的长处。作者提到,Claude 在编写复杂逻辑代码上表现出色,而 Codex(GPT系列)在 3D 相关工作上更强。因此你可以在分诊环节用一个LLM扫描任务内容——涉及3D工作就派给Codex,涉及复杂编码就交给Claude,而一个简单的文档更新则完全可以交给便宜又快的小模型。
在实际演示中,作者给一个高度依赖3D的应用创建了「add dark mode」的issue,并特意指派给 Codex,结果 Codex 01 顺利接手并完成了任务。这种「因材施用」的调度,正是多Agent集群相比单一Agent的差异化优势。
沙箱隔离:安全与资源的双重保障
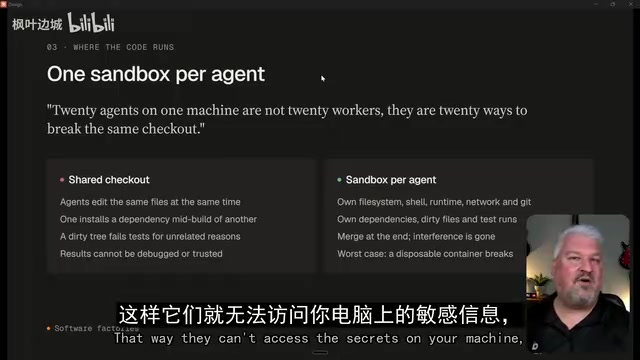
每个Agent都运行在自己独立的沙箱里,这一点作者反复强调其重要性。原因有两层:
安全层面:issue的内容可能包含通过 prompt injection 注入的有害指令。如果Agent只在受限沙箱中运行,即便被攻击,破坏范围也被完全限制——它无法访问你的笔记本、文件或密钥。
资源层面:这套方案里每个Agent跑在独立的 VPS(作者使用 Upstash 的 Box)上,各自分配硬件资源,比如 2 CPU、4GB 内存。想象同时运行 10 个、20 个甚至 100 个Agent,如果都挤在你本机上抢资源,体验会非常糟糕。独立VPS还带来一个额外好处:永远在线。合上笔记本,任务照样进行;你可以用手机打开 GitHub 提个 issue,某个Agent就会在云端默默产出一个 PR。
Prompt Injection(提示注入)是一种针对LLM的攻击手段:攻击者在Agent会处理的外部内容(如GitHub issue正文、网页、文档)中藏入伪装成指令的文字,试图劫持Agent的行为——例如让它泄露密钥、执行恶意命令或绕过既有限制。与传统SQL注入类似,其根本原因在于模型难以完全区分「数据」与「指令」。沙箱隔离是目前最实用的防御层:即便攻击成功控制了Agent的决策,Agent所处的受限环境也让它无法触及宿主系统的敏感资源。这也是为什么将工厂Agent部署在独立VPS而非本机上,是一种安全设计选择而不只是资源分配的考量。
搭建流程:让Agent替你建工厂
最有意思的一点是——你几乎不需要自己写代码,而是让编程Agent来搭建这个工厂。作者把整套构建逻辑封装成一个可复用的 Agent Skill,安装后直接触发即可。
准备工作包括:
- 至少一个 GitHub 仓库供工厂管理(可以是现有项目,也可以先部署一个简单的 to-do 应用做测试)。公开仓库要注意:别人也能提 issue 触发你的工厂,可在分诊步骤限制只处理自己指派的 issue。
- 云端运行环境(作者用 Upstash 的 Box,免费额度可跟着实操)。Box 就是运行 Claude Code 或 Codex 的 Linux 虚拟机。
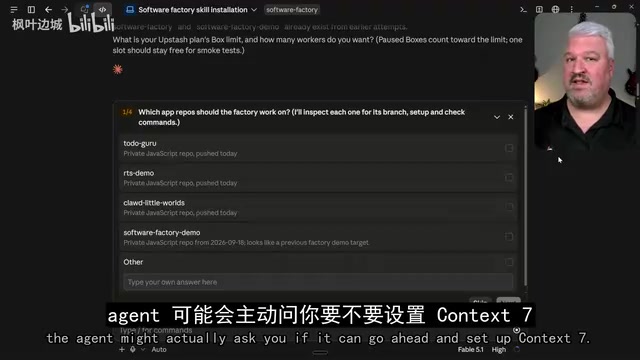
- 创建工厂本身:把 Skill 的 GitHub 链接丢给编程Agent,让它安装并执行,Agent会逐步询问要连接哪些仓库、用哪些编程Agent、工厂仓库命名、Box 数量(免费版上限10个)、默认派单策略、是否启用浏览器工具等。
随后需要配置三类密钥并写入 .env 文件:Upstash Box API Key、GitHub 细粒度访问令牌(需要 contents、issues、pull requests 的读写权限)、以及 Claude Code 的 OAuth token(让Agent用订阅额度而非按量付费的API key)。作者特别推荐把密钥直接更新到 .env 而非粘贴到聊天里,更安全。
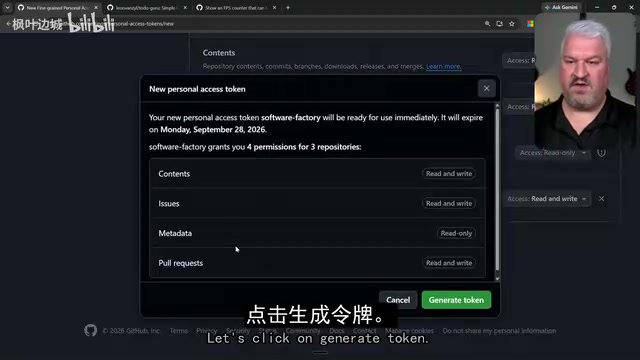
GitHub 细粒度访问令牌(Fine-grained Personal Access Token)是2022年后GitHub推出的新一代权限控制机制,相较于传统的经典令牌,它允许将权限精确限定到特定仓库及特定操作范畴(如仅允许读写某几个仓库的 issues 和 pull requests),大幅缩小凭证泄露后的攻击面。在软件工厂场景中,工厂需要跨仓库操作(监听issue、提交PR),因此令牌权限配置至关重要:权限过宽会带来安全风险,权限不足则会导致工厂无法正常调度。作者建议将令牌写入 .env 文件而非粘贴进聊天窗口,原因正是聊天记录可能被LLM上下文感知或日志留存,而 .env 文件通常处于.gitignore保护之下。
触发与测试:从 issue 到 PR 的闭环
工厂搭好后,还需要让被管理的项目仓库具备「向工厂发信号」的能力。Agent会在这些仓库里创建 Pull Request(用于把 ready issue 转发给工厂),手动合并后,仓库便能通知工厂开始工作。
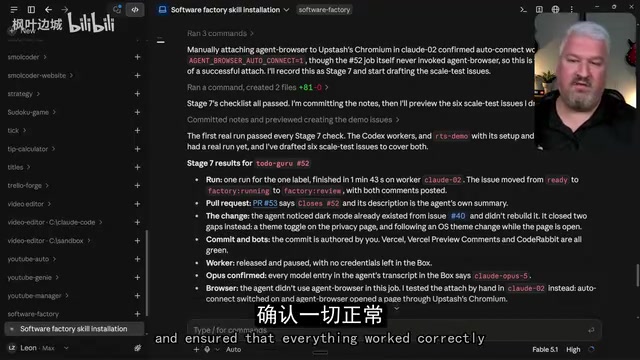
测试环节,作者创建了一个「create light and dark modes」的 issue 并打上 ready 标签。在工厂仓库的 Actions 里能看到任务被拉取。有一个细节很实用:issue 的标签会从 ready 自动变为 factory running,完成后再变为 factory review,让你一眼看清哪些 issue 正在被处理。工厂还会在 issue 评论里说明是哪个 worker(如 Claude 02)接手,并附上生成的 PR 链接。
用快照统一环境,随时扩缩容
如果你希望所有Agent都预装某些技能或护栏,不必逐个Box配置,而是用**快照(Snapshot)**创建可复用模板。作者演示了如何让Agent创建包含前端设计技能、agent browser 工具的新快照,之后所有从该快照创建的Box都会自动继承这些能力。
一个必须知道的限制:Upstash 不允许Agent删除 Box 或快照,这类操作必须人工完成,算是又一道安全防线。扩容则极为轻松——一句「我要10个Box,Codex 和 Claude 各半」,Agent就会自动创建对应数量的Box。添加新仓库同理:更新访问令牌的仓库范围,让Agent把仓库加入工厂并合并它生成的 PR 即可。
快照(Snapshot)机制在云计算中是一种将虚拟机当前状态「冻结」为可复用模板的技术,类似于Docker镜像的概念。通过快照,团队可以把调试好的Agent运行环境(包含预装工具、配置文件、技能插件)固化下来,后续所有新建的Box都从同一基准状态启动,避免了「在我机器上能跑」式的环境漂移问题。在软件工厂场景中,这特别有价值:当你需要从5个Agent快速扩容到20个时,无需逐一手动配置,所有新Box天然继承相同的能力边界和安全设置,扩缩容因此变成一个近乎无摩擦的操作。
小结:把编程Agent变成流水线
这套软件工厂的思路,本质上是把「一对一监督Agent」升级为「一对多的调度与管理」。它的价值不在于单个Agent有多强,而在于:多模型按长处分工、沙箱带来安全与资源隔离、云端VPS让任务永远在线、以及始终保留的人工审核关卡。
对于想要规模化使用编程Agent的团队来说,这是一个值得研究的架构范式。当然,是否真的需要同时跑10个甚至上百个Agent,取决于你的实际工作量——作者自己也在视频里对此打了个问号。
相关推荐
Databricks Genie重大更新:上下文、数据接入与自动化全面升级
Databricks Genie One迎来重大更新,涵盖业务感知上下文、工作区指令、多格式文件上传、Unity Catalog直连查询和定时自动化任务,推动企业级AI数据助手深度融入数据工作流。
Omnigent:让Claude Code与Codex协同工作的开源元框架
Omnigent是一款开源元框架,让Claude Code、Codex等多个编码智能体共享会话、规则与安全策略。本文解析其任务分叉、Debby多Agent评审辩论与Polly子Agent拆分等协作模式。
算力上太空:谷歌与Planet原型卫星成功发射意味着什么
谷歌与Planet合作的太空算力原型卫星由SpaceX成功发射。本文解析把计算搬到太空的动因、工程挑战以及商业航天生态的协同意义。