AI的瓶颈不是智能,而是上下文:统一语境层如何破局

企业AI失效的根源是上下文缺失,Databricks Genie用本体层为AI提供可信的业务语义地图。
文章提出一个被长期忽视的观点:企业AI表现不佳,问题不在模型智能,而在于业务上下文分散在各孤立系统中,模型无从获取可信的业务语境。Databricks Genie Ontology尝试通过构建"统一上下文层"来解决这一难题——以本体(Ontology)的方式结构化定义业务实体及其关系,同时融合人工精心整理的口径定义与AI自主学习的使用偏好。相比主流的RAG方案,本体层不只能回答"信息在哪",还能表达"信息之间是什么关系",从而支撑AI从被动问答走向自主行动。文章同时保持了理性克制,指出本体构建成本高、口径分歧难消弭、持续维护是长期挑战,相关能力描述来自厂商演示,仍需实际部署检验。
AI真正的短板:上下文缺失
当人们讨论大模型的能力时,往往聚焦于推理能力、参数规模和基准测试得分。但一个被频繁忽视的事实是:AI在企业场景里表现不佳,问题往往不出在"智能"本身,而出在"上下文"。
正如这条来自企业AI领域的观点所言——"AI没有智能问题,它有上下文问题"(AI doesn't have an intelligence problem. It has a context problem)。这句话精准击中了当前企业落地AI时的核心痛点。模型足够聪明,但它并不了解你的业务。
问题的根源在于,企业的业务上下文被分散在各个孤立的系统中:仪表盘、文档、工单、聊天记录。当一位业务用户想要一个快速、可信的答案时,相关信息却散落在十几个工具里;而数据团队则被淹没在源源不断的临时取数请求(ad hoc requests)中,难以抽身做更有价值的工作。
统一上下文层:弥合语义鸿沟
解决方案的思路是构建一个统一的上下文层(unified context layer)。它的核心价值在于:让AI能够基于可信的业务语境给出答案,能够自主执行任务,并最终把时间还给团队。
这里的关键词是"可信"。企业场景与通用问答最大的区别在于,答案不能是"大概率正确",而必须建立在明确定义的业务指标、口径和关系之上。如果AI把"活跃用户"的口径理解错了,或者拉错了数据表,那么再流畅的回答也是有害的。
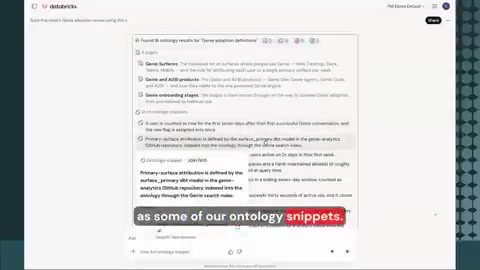
从演示截图可以看到,这套系统会把"人工精心整理的上下文"(context that we curated by hand)与"AI自己学习到的信息"结合起来。这种人机协同的方式,既保证了关键业务定义的准确性,又让AI能够在此基础上灵活推理,而不是被完全锁死在规则里。
Genie Ontology:本体论驱动的AI
这次讨论的具体产品是 Databricks 的 Genie Ontology(本体层)。Ontology(本体)这个概念来自知识工程,指的是对业务实体、属性及其关系的结构化定义——换句话说,就是给AI提供一张"企业语义地图"。
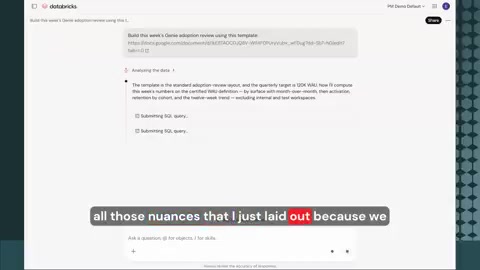
从产品演示中能观察到几个值得关注的工作流特征:
理解用户的表达习惯
系统声称"Genie已经很好地掌握了我喜欢怎么写这类文档的方式"(Genie already has a good sense for how I like to write these kinds of docs)。这意味着上下文层不只是存储业务数据定义,还在学习使用者个人的工作偏好,从而让输出更贴合实际需求。
基于本体的数据资产发现
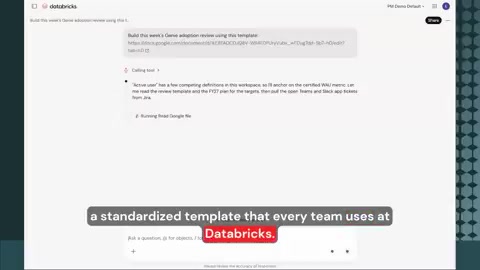
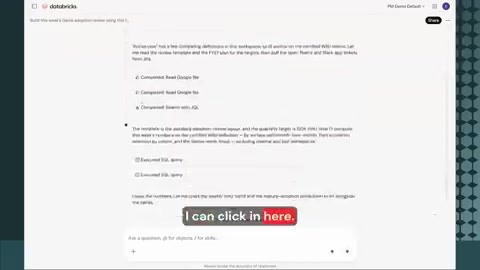
在执行任务时,AI会先"从一些潜在相关的数据资产入手"(started with some potentially relevant data assets),再逐步深入。这种有本体支撑的检索路径,比盲目的向量相似度匹配更有章法,也更容易让结果可解释、可追溯。
本体(Ontology)一词源于哲学,指"对存在本质的系统性研究",被知识工程领域借用后,专门指代对某一领域内概念、属性及关系的形式化描述。在企业数据语境中,本体通常以三元组的形式表达知识,例如"客户—归属于—区域"或"订单—包含—商品",并可附加属性约束与业务规则。知识图谱(Knowledge Graph)是本体思想的典型工业化实现,谷歌、LinkedIn等公司早年均以知识图谱为核心构建了企业语义层。将本体引入AI问答的优势在于推理可解释性:系统可以沿着语义关系链逐步推导,每一步都有据可查,这与纯向量检索的"黑箱相似度"形成鲜明对比,也更容易满足企业对答案可审计、可追溯的合规需求。
为什么本体层是企业AI的关键基础设施
把上下文层上升到本体层面,背后有清晰的逻辑。单纯依靠RAG(检索增强生成)把文档塞给模型,只能解决"信息在哪"的问题,解决不了"信息之间什么关系"的问题。而本体恰恰定义了实体与实体之间的连接。
当AI能够理解"订单"关联"客户"、"客户"归属"区域"、"区域"对应"销售负责人"这样的语义网络时,它才可能真正做到自主行动(act autonomously),而不仅仅是被动问答。这也是从"AI聊天助手"走向"AI智能体"的分水岭。
对数据团队而言,这套机制的现实意义同样直接:一旦业务口径被沉淀进本体层并被AI复用,重复的临时取数请求就会大幅减少,团队得以回归更具创造性的工作。
RAG(Retrieval-Augmented Generation,检索增强生成)是目前企业AI落地中最主流的上下文补充方案:在用户提问时,系统先从文档库中检索相关片段,再将其与问题一起送入大模型生成回答。这种方式能有效弥补模型训练数据截止日期的局限,也让模型能调用私有知识。但RAG的根本机制是"相似度匹配"——它擅长找到和问题在语义上接近的文本,却对结构化的业务逻辑无能为力。例如,RAG可以检索到包含"活跃用户"字样的文档,但无法自动理解这个指标的计算口径、它与哪张数据表关联、或者为什么与"付费用户"口径不同。本体层的补充价值正在于此:它不存储文本,而是显式编码实体之间的关系图谱,让AI拥有可遍历的业务语义结构,而非仅凭向量距离猜测上下文。
冷静看待:演示之外的现实
说一下,上述信息主要来自该产品的官方宣传与按需点播的演示(on-demand demo),属于厂商视角的单一来源。本体层的理念方向正确,但在真实企业中落地仍面临挑战:业务本体的构建与维护成本很高,组织内对指标口径常常存在分歧,人工整理的上下文如何持续更新也是个长期难题。
"上下文问题"确实是当下企业AI的真问题,统一上下文层/本体层也确实代表了一条有价值的技术路径。但它究竟能在多大程度上"把时间还给团队",仍需在更多实际部署中接受检验。
注:本文基于厂商公开演示信息整理,相关能力描述以官方为准。
相关推荐
Cursor入门指南:AI编程工具全景解析与主流对比
Cursor入门教程第一讲:解析AI编程核心逻辑,横向对比Cursor、GitHub Copilot、Windsurf、Trae、通义灵码等主流AI编程工具的优劣势与适用场景,助你快速选型。
Cursor的Agent团队实践:如何突破40%生产力瓶颈
Cursor团队分享Agent团队实战经验:为何AI编程效率停滞在40%?答案在于AI只替代了软件开发生命周期的一小部分。本文解析PM Agent、安全Bot、代码审查与增长自动化如何重构研发全流程。
Pi 1.0 实测:11万星开源AI编程智能体,被称工具界Neovim
开源AI编程智能体Pi 1.0实测:GitHub 11.17万星、MIT许可、支持15家AI服务商和多模型路由,被社区称为AI工具界的Neovim。本文详解其架构、四大功能、Pi Durable运行时及与Claude Code、Cursor的对比。