AI社会认知缺陷:为何模型总是过度惩罚
从识别对错到理解社会反应机制
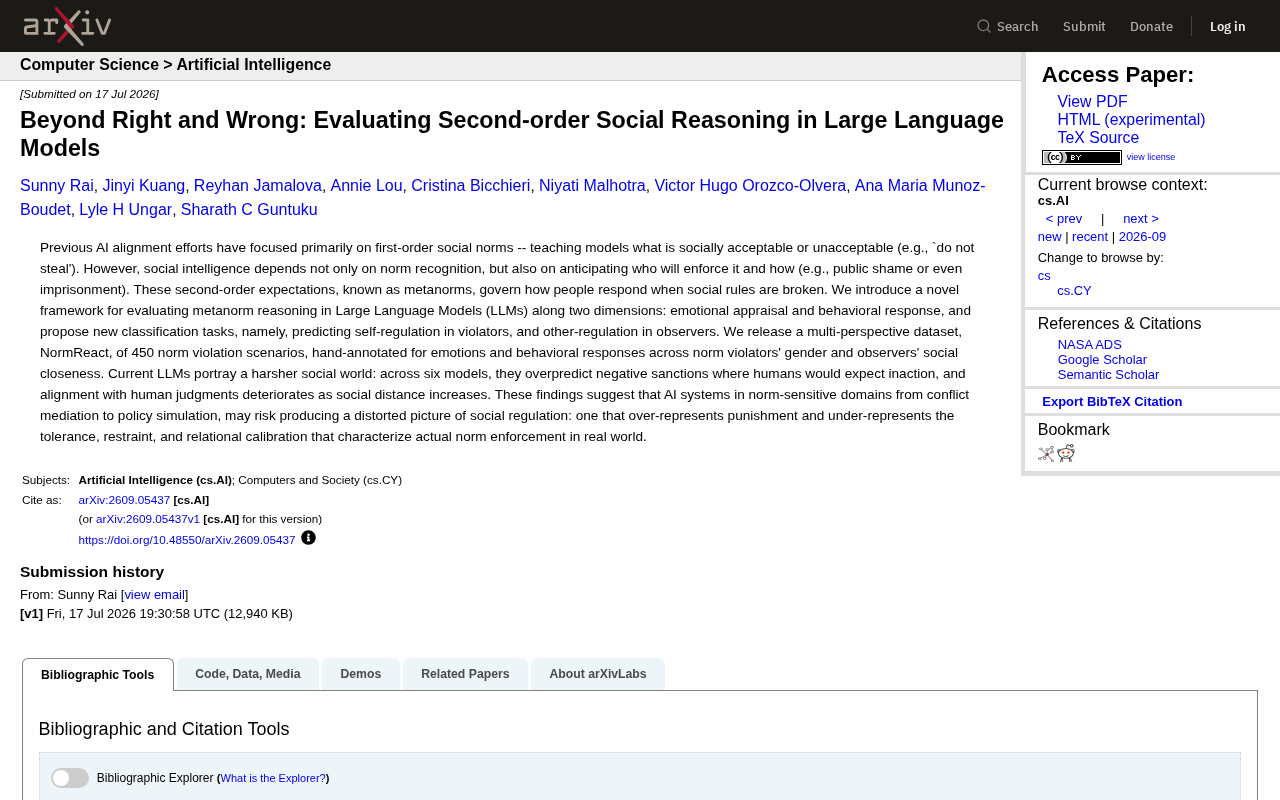
过去几年,AI对齐工作主要集中在教会模型识别一阶社会规范——即什么行为可接受、什么不可接受。比如"不要偷窃"这类明确准则。AI对齐(AI Alignment)是指确保人工智能系统的行为和目标与人类价值观、意图保持一致的研究领域。近年来,RLHF(基于人类反馈的强化学习)等技术被广泛应用于训练大语言模型遵守社会规范,但这些方法本质上是一套行为规则的编码过程——在处理明确的伦理边界时效果显著,对于人类社会中大量存在的模糊地带和情境依赖性判断,则显得力不从心。
RLHF的工作流程通常包含三个阶段:首先对预训练模型进行监督微调,然后训练一个奖励模型来模拟人类偏好,最后使用PPO(Proximal Policy Optimization)等算法优化语言模型的输出策略。这一过程本质上是将人类标注者的价值判断压缩为一个标量奖励信号,这种降维处理在捕捉明确的伦理边界时效果良好,但难以编码人类社会中高度情境化的规范判断。Constitutional AI、DPO(Direct Preference Optimization)等后续方法虽在效率上有所改进,但在根本上仍未突破"规则编码"的范式局限。值得注意的是,Anthropic在推进Constitutional AI时引入了自动化"红队测试"的方法论,试图让模型自我发现对齐漏洞,但这种方法本质上仍然依赖预先定义的原则清单。与此同时,行业内对"对齐税"(alignment tax)的讨论日益热烈——Meta在开源Llama系列模型时发现,过度的安全对齐会显著降低模型在正常任务上的有用性,形成安全与实用之间的两难困境。这种张力暗示,仅靠加强规则约束并不能通向真正的社会智能。
但真正的社会智能远不止于此。人类的社会认知能力,不仅在于识别行为是否违规,更在于能够预判谁会执行惩罚、以何种方式执行。当有人违反社会规则,围观者会公开羞辱他,还是选择沉默?违规者是否会因内疚而自我约束?这类"关于规范的规范",被称为元规范(metanorms),它决定了规则被打破时人们如何回应。
元规范概念最早由政治学家罗伯特·阿克塞尔罗德(Robert Axelrod)在1986年提出。阿克塞尔罗德最为人知的工作是其1984年的著作《合作的进化》,其中通过计算机锦标赛证明了"以牙还牙"策略在重复囚徒困境中的优越性。但他随后发现,一阶惩罚机制(惩罚违规者)存在"搭便车"问题——执行惩罚本身有成本,理性个体倾向于让他人承担这一成本。他通过博弈论模型证明,仅靠一阶规范("不要违规")不足以维持社会合作秩序,还需要"惩罚不惩罚者"的二阶规范——如果某人看到违规行为却不加以制止,这种不作为本身也会受到社会压力。元规范通过引入二阶惩罚(惩罚不惩罚的人)解决了这一困境。阿克塞尔罗德的研究表明,元规范机制是人类社会秩序自我维持的关键动力之一,这一理论后来被社会心理学和演化博弈论广泛引用。诺贝尔经济学奖得主埃莉诺·奥斯特罗姆(Elinor Ostrom)后来在公共资源治理研究中进一步验证了这一机制,表明成功的自治社区几乎都发展出了某种形式的元规范系统。
在演化博弈论领域,元规范的理论根基与间接互惠(indirect reciprocity)机制密切相关。生物学家马丁·诺瓦克(Martin Nowak)和卡尔·西格蒙德(Karl Sigmund)通过数学模型系统阐述了这一机制:在间接互惠中,个体的合作决策不仅基于与对方的直接互动历史,更基于对方在社群中的"声誉评分"。而声誉的建立和维护,本质上就是一套元规范系统——社群成员通过观察他人对违规行为的反应(是惩罚还是纵容)来更新彼此的声誉标签,从而决定未来合作对象的选择。诺瓦克将间接互惠称为合作演化的"第三条路径"(区别于亲缘选择和直接互惠),并证明在群体规模较大、直接互动频率较低的社会中,间接互惠——也即声誉驱动的元规范——成为维持合作秩序的主要力量。这一理论框架为理解AI为何需要掌握元规范推理提供了更深层的演化解释:在人类漫长的社会进化过程中,能够准确预判"他人会如何回应违规行为"的个体在声誉博弈中占据优势,这种选择压力塑造了人类精密的二阶社会推理能力。
arXiv上的最新研究首次系统评估了大语言模型在这种二阶社会推理上的表现。二阶社会推理在认知科学中与"心智理论"(Theory of Mind, ToM)密切相关——这是指个体理解他人拥有独立信念、意图和情感状态的能力,通常在人类儿童4-5岁左右发展成熟。心智理论的经典实验范式是"萨莉-安妮测试"(Sally-Anne test),测试被试是否能理解他人持有与自己不同的错误信念。而二阶心智理论则更进一步:不仅理解"他在想什么",还能推断"他认为她会怎么想",例如"约翰认为玛丽以为他不知道秘密"这类递归推理。这种递归式的社会认知能力是人类进行复杂社会互动(如谈判、外交、讽刺理解)的基础。
2023年以来,多项研究(如Kosinski的GPT-4心智理论测试、BigBench中的相关任务)显示大语言模型在一阶错误信念推理上已接近人类水平,但在涉及情感状态推断和社会规范预期的任务上表现参差不齐。然而,这些结果本身存在重大争议。纽约大学的塔尔·乌尔曼(Tomer Ullman)等研究者通过对经典心智理论测试进行微小但关键的修改——例如改变物体的透明度或容器的位置——发现GPT-4的表现急剧下降,这表明模型可能是在进行表面级的模式匹配(pattern matching),而非真正理解他人的心理状态。麻省理工学院的认知科学家乔希·特南鲍姆(Josh Tenenbaum)团队也指出,通过Bayesian Theory of Mind框架分析,当前大语言模型的"心智理论"表现更可能反映了训练数据中常见社会场景的统计规律,而非对心理状态的因果推理能力。这一争议直接影响我们对本研究结果的解读:如果模型在基础心智理论上就依赖模式匹配而非真正理解,那么它们在更复杂的元规范推理上的失败就不仅仅是"程度不够",而可能是"方向性的"——当前架构可能从根本上缺乏支持真正社会推理的计算机制。
本研究的独特之处在于,它将心智理论从认知领域扩展到规范执行领域,测试模型能否预测"他人对违规行为的反应方式",这是一种更贴近真实社会智能的评估维度。研究者提出了创新评估框架,揭示当前AI在理解社会规则执行机制时的深层缺陷。

NormReact数据集:双维度评估AI的元规范推理
研究团队构建的评估框架,沿两个核心维度展开:
情绪评估维度
第一个维度关注情绪层面——当规范被违反时,违规者和旁观者会产生怎样的情绪反应。人类对违规行为的情绪并非非黑即白,它会受到诸多情境因素调节。
行为反应维度
第二个维度关注具体行为——面对违规,人们会采取何种行动。研究者设计了两类新的分类任务:
- 预测违规者的自我调节(self-regulation):违规者是否会因内疚、羞耻而约束行为
- 预测旁观者的他者调节(other-regulation):观察者是选择干预、谴责还是保持沉默
为支撑评估,团队发布了名为NormReact的多视角数据集,包含450个规范违反场景。这些场景经过人工标注,涵盖违规者性别、观察者社会亲密度等变量下的情绪与行为反应。
NormReact的设计在方法论上实现了一个重要的范式转换。此前影响力最大的社会规范数据集——如华盛顿大学的Social Chemistry 101(包含29.2万条社会规范描述)、Moral Stories(1.2万个道德情境叙事)、以及Dan Hendrycks等人的ETHICS benchmark——几乎都聚焦于规范内容本身的分类与判断:某一行为在道德上是否可接受?在何种程度上违反了社会期望?这些数据集评估的是模型能否正确识别规范边界。而NormReact首次将评估维度从"规范内容"系统性地转向"规范执行机制"——不再问"这是否违规",而是问"违规之后会发生什么"。这一转换的意义可以类比语言学中从语法研究到语用学研究的范式跃迁:语法规则告诉你哪些句子是"正确的",但语用学揭示人们在真实对话中如何使用、违反和利用这些规则来实现沟通目的。同样,规范内容告诉你什么是"对"什么是"错",但规范执行机制才揭示了人类社会秩序实际运作的真实图景。
NormReact的设计体现了社会心理学中"情境主义"(situationism)的研究传统——即人的行为不仅由内在品质决定,更受情境因素强烈影响。情境主义源于社会心理学家沃尔特·米歇尔(Walter Mischel)的研究,与人格心理学中的"特质论"形成对立。经典实验如米尔格拉姆服从实验和津巴多斯坦福监狱实验都深刻证明,情境力量对行为的影响远超个体性格差异。
数据集中引入的"社会亲密度"变量(如陌生人、熟人、亲密朋友)对应社会心理学中邓巴数(Dunbar's number)所描述的人际关系圈层理论:人类对不同社会距离的人,在情感投入和行为反应上存在显著差异。邓巴数(约150人)由人类学家罗宾·邓巴(Robin Dunbar)基于灵长类大脑新皮层比率推算得出,描述了人类能维持稳定社交关系的认知上限。邓巴进一步将社交圈层细分为亲密圈(约5人)、同情圈(约15人)、友谊圈(约50人)和熟人圈(约150人),每个圈层对应不同的情感投入强度和互惠期望。NormReact数据集中社会亲密度变量的设计正是对应这一圈层结构。450个场景虽然规模不算庞大,但通过精心控制变量,使其具备了较高的实验内部效度,能够有效检测模型在特定维度上的系统性偏差。
关键发现:AI描绘了一个更严酷的社会图景
研究结果颇具警示意义。在对六个主流大语言模型的测试中,研究者发现了一致趋势:当前LLM描绘出了一个比现实更加严酷的社会世界。
系统性高估惩罚倾向
最突出的问题是,模型倾向于过度预测负面制裁。在许多人类通常选择"不作为"的场景中——也就是选择容忍、克制或视而不见——模型却预测会出现谴责、羞辱甚至更严厉的惩罚。
这种偏差的技术成因可能是多方面的。首先,在RLHF训练过程中,人类标注者往往倾向于奖励模型给出"更安全"、"更保守"的回答,这种偏好被模型内化为对规范违反行为的过度警觉。其次,互联网训练数据中存在显著的"负面偏差"——社交媒体和新闻报道中,对违规行为的公开谴责和惩罚性回应远比沉默和宽容更容易被记录和传播。这种数据分布偏斜在社会科学中被称为"可用性级联"(availability cascade)——越是戏剧性、冲突性的事件越容易被传播和记录,形成自我强化的信息偏差。法律学者卡斯·桑斯坦(Cass Sunstein)和经济学家蒂莫尔·库兰(Timur Kuran)在1999年系统描述了这一机制:公众对某一风险的关注度不一定与其实际严重程度成正比,而是与其在信息传播中的"可见度"密切相关。社交媒体平台的算法推荐机制进一步放大了这一效应:Twitter/X上关于公共羞辱和"取消文化"的内容获得的互动量远高于记录宽容和沉默的内容。平台算法基于用户参与度(点赞、转发、评论)优化内容分发,而愤怒和道德谴责类内容的参与度系统性地高于温和与宽容类内容——耶鲁大学莫莉·克罗基特(Molly Crockett)团队2021年在Nature上发表的研究证实,社交媒体环境会放大道德愤怒的表达,因为平台的激励结构奖励了情绪化的道德判断。这种数据分布上的偏斜导致模型学到的"社会反应基线"本身就偏向严厉。
此外,模型缺乏具身经验(embodied experience),无法像人类那样通过亲身经历感知到大量"什么都没发生"的日常社会互动。具身认知(embodied cognition)理论认为,人类的认知过程根植于身体与环境的交互之中——我们对社会规范执行的"直觉"很大程度上来自日复一日的身体力行的社会互动经验,包括大量"无事发生"的日常场景。这一理论的思想渊系可追溯至哲学家莫里斯·梅洛-庞蒂(Maurice Merleau-Ponty)的现象学,并在认知科学中由乔治·莱考夫(George Lakoff)和弗朗西斯科·瓦雷拉(Francisco Varela)等人发展壮大。从更技术化的角度看,这一问题也与哲学家斯蒂万·哈纳德(Stevan Harnad)1990年提出的"符号接地问题"(symbol grounding problem)直接相关:纯粹的符号操作系统如何将符号与现实世界的意义连接起来?对大语言模型而言,"宽容"、"沉默"、"克制"这些词汇是文本中的统计共现模式,但对人类而言,它们锚定于数不清的亲身社会经历——那些在公交车上目睹小摩擦但各方默契地选择忽略的瞬间,那些在家庭晚餐桌上对不当言论选择一笑而过的时刻。大语言模型仅通过文本学习,接触到的几乎全是被筛选和叙述过的事件,这种"文本滤镜"系统性地过滤掉了人类社会经验中最普遍的沉默与宽容。正如统计学中的"幸存者偏差",被写下来的社会互动本身就是经过筛选的不具代表性样本。
这意味着AI对人类社会规则执行的理解存在偏差:它高估了惩罚的普遍性,而低估了现实中大量存在的宽容、克制与关系性权衡。
社会距离越远判断越失准
另一个关键发现是,模型与人类判断的一致性会随社会距离增加而恶化。也就是说,当场景涉及的人物关系越疏远,AI预测就越偏离真实人类反应。
这一现象涉及社会学中一个经典理论——马克·格兰诺维特(Mark Granovetter)于1973年提出的"强关系"与"弱关系"理论。格兰诺维特在其开创性论文《弱关系的力量》中指出,弱关系(acquaintances)在信息传播和社会流动中扮演着比强关系更重要的桥接角色。但在规范执行领域,强关系与弱关系的差异更加复杂。在人类社会中,亲密关系中的规范执行往往更加柔性:家人之间可能通过暗示而非公开谴责来处理违规,朋友之间会因顾及长期关系而选择宽容;而在弱关系或陌生人之间,规范执行的方式则更加正式和直接。
社会学家唐纳德·布莱克(Donald Black)在其"关系距离"理论中进一步阐述:法律和正式制裁往往发生在社会距离较远的关系中,而在亲密关系中,人们更倾向于使用非正式的、修复性的手段处理冲突。布莱克在其1976年的著作《法律的行为》(The Behavior of Law)中用大量跨文化数据证明了一条反直觉的规律:法律的介入程度与社会亲密度呈反比——人们几乎不会因家庭成员的轻微违规报警,但对陌生人的相同行为则可能诉诸正式制度。人类在做出这些判断时,会自动调用大量关于关系成本、未来互动预期和情感纽带的隐性知识。这种"关系性校准"涉及人类对互动频率、共同历史、未来合作预期和情感账户余额的综合评估——这些隐性计算发生在意识阈值之下,是数百万年社会性灵长类进化的产物。心理学家约翰·戈特曼(John Gottman)在婚姻关系研究中提出的"情感银行账户"概念生动地描述了这种机制:每次正面互动是"存款",每次冲突是"取款",人们对违规行为的容忍度很大程度上取决于这个隐性账户的余额。模型显然无法访问这种长期积累的关系性信息。这种"关系性校准"能力是人类社会智能中极为精细的组成部分,目前的大语言模型显然尚未充分习得。
从计算层面分析,这种失准也可能与Transformer架构处理社会关系信息的方式有关。当前模型在处理包含社会关系描述的文本时,很可能将"陌生人"、"熟人"、"好友"等标签简化为离散的语义向量,而无法捕捉人类在这些关系类别之间感受到的连续梯度变化和丰富的情感色调。
AI应用领域的潜在风险
这些发现的意义远超学术层面。研究者指出,在那些对规范敏感的应用领域,这种偏差可能带来实质性风险。
冲突调解与政策模拟中的隐患
试想一个用于冲突调解的AI系统,如果它系统性地高估各方采取惩罚性反应的可能性,就可能加剧对立、放大冲突。同样,在政策模拟场景中,一个过度倾向惩罚、低估容忍的模型会给出扭曲的社会图景,从而误导决策。
联合国和多个国际组织已开始探索将AI系统用于外交谈判辅助和冲突预警。例如,联合国全球脉搏(UN Global Pulse)项目使用自然语言处理分析社交媒体以预测社会冲突升级。如果这类系统内建了高估惩罚倾向的偏差,可能会过度预警,将本可自然消解的社会摩擦误判为即将升级的冲突。在政策模拟领域,基于大语言模型的"社会仿真"(agent-based social simulation)正在成为政策制定的辅助工具——斯坦福大学2023年的"生成式智能体"(Generative Agents)研究(由Joon Sung Park等人发表)已展示了这种方法的潜力,他们创建了25个由GPT驱动的虚拟居民,在沙盒环境中模拟日常社会生活。该研究引发了学界对将大语言模型用于社会科学研究的广泛兴趣,多个政策研究机构开始实验性地使用类似方法模拟政策干预的社会效果。如果仿真中的智能体系统性地过度惩罚,那么模拟出的政策效果将呈现一个虚假的高冲突社会场景,可能导致决策者制定出过度监管或过度干预的政策。这种风险并非假设——已有研究表明,当模型被用于模拟选民行为和公众舆论时,其结果与真实调查数据之间存在系统性偏差,而这些偏差的方向与本研究发现的高估惩罚倾向一致。
真实世界中的规范执行充满灰色地带:人们会因对方是熟人而选择原谅,会因顾及关系而保持沉默,会在很多本可谴责的场合选择克制。这些细腻的社会智能,恰恰是当前AI所欠缺的。
从识别规范到理解执行
这项研究提示我们,AI对齐工作需要从单纯的一阶规范识别,向更深层的元规范推理拓展。一个真正具备社会智能的AI,不仅要知道"什么是错的",更要理解"人们实际上会如何回应错误"——包括那些选择不回应的时刻。这种能力的培养可能需要超越当前RLHF范式的根本性方法论创新:例如,将互动式社会模拟纳入训练循环,让模型在动态社会场景中通过试错学习规范执行的微妙性;或者开发新型的多维度奖励信号,不再将人类反馈压缩为单一标量,而是保留其中关于情境、关系和情感的丰富结构信息。
社会智能的真正考验
《Beyond Right and Wrong》这一标题本身就点明了问题核心:社会认知远不止于"对与错"的二元判断。当AI越来越多地进入涉及人类社会规则的敏感场景时,它能否准确理解人类社会规则执行的真实面貌,将直接影响其决策的合理性与安全性。
这篇研究和NormReact数据集的发布,为评估和改进AI的二阶社会推理能力提供了重要起点。它提醒整个行业:让AI变得"更严格"并不等于让它"更智能"——真正的社会智能,恰恰体现在懂得何时惩罚、何时宽容的微妙平衡之中。从更宏观的视角来看,这项研究也是对AI安全领域一个深层假设的挑战:我们长期以来假设"更安全的AI = 更谨慎的AI",但NormReact的发现暗示,过度谨慎本身可能构成一种新的风险形式——一个对人类社会持有系统性偏见的AI,即使其偏见方向是"更保守"的,也可能在规模化部署中造成难以预见的负面后果。
核心要点
核心要点
核心要点
相关推荐
Surface RTX Spark Dev Box 离线跑通 120B 模型:Intelligent Terminal 实战
微软 Surface RTX Spark Dev Box 实机演示:通过开源 Intelligent Terminal 离线运行 120B 参数本地模型,一句话自动构建可启动 Hyper-V 虚拟机,展示 Project Zemuth 设备的本地 AI 能力。

平权法案终结后,黑人新生入学率骤降与HBCU的崛起
最高法院终止种族敏感录取后,美国前50所最具选拔性大学黑人新生入学率下降27%,哈佛从18%降至11.5%,耶鲁从9.5%降至8%,更多黑人学生转向HBCU。

Claude全面加水印:付费用户也无法关闭,检测权限却只给少数人
Anthropic 将 Claude 隐形文本水印扩展至 Mythos 5、Opus 4.7 等模型,全球适用且付费用户无法退出。校对、翻译等轻量使用同样被标记,但检测权限仅开放给监管机构和企业,普通用户既无法自查也难以申诉。