AI递归自我改进RSI:距离真正实现还有多远?
AI已能积累经验并参与研发,但让"改进方法本身进化"的完整RSI仍由人掌控。
递归自我改进(RSI)的核心不是单次纠错,而是系统能否让自己的改进方式持续进化。Acer AI发布的RSI Agent通过练习、执行、验证三类Agent分工,将经验积累做成完整流程:在固定底层模型参数的前提下,把成功做法和失败反馈写入记忆库供后续任务调用。实测中,携带探索经验的Agent在Shotcut去水印任务中得到满分1.00,无经验版本仅得0.40;OS World 20基准的整体完成度也从约72%升至79%。然而两项数据的测试条件均未完全对齐,需谨慎解读。更深层的问题在于:练习生成规则、验证标准、记忆更新逻辑这些"改进制度"仍由人写死在框架里,改进方法本身尚无法自主进化。OpenAI虽称内部已达"自动化研究实习生"阶段,但完整RSI的关键一步——系统在可比资源下自主优化改进流程并稳定变强——目前仍未实现。
过去,一款AI变强的背后通常是一群人在忙——准备数据、重新训练、跑评测,再把新版本发布出来。AI负责被使用,人负责升级它。而现在,这条分工正在松动:一些AI系统已经开始参与找问题、写代码、跑实验、检查结果,还会把有效经验留给后面的任务。
这条路径有个专门的名字——RSI,全称Recursive Self-Improvement,中文叫递归自我改进。它与普通纠错的区别在于:普通纠错只解决眼前这一次的问题,而RSI还关心两件事——这次的经验能不能留下来?系统以后用什么方法改进自己,能不能继续被调整?
RSI 到底在说什么
可以把RSI理解成员工和公司的关系。一名员工会把经验写进工作手册,供后来人参考;但更进一步,如果这名员工还能修改公司的培训制度,让后来的人越来越会学习,这才接近RSI的完整形态。
换句话说,判断一个系统离完整RSI有多远,关键就看这套"改进方法"本身有没有开始变化。仅仅积累经验还不够,系统必须能发现自己改进流程中的问题,并自主调整改进方法,让后续每一轮都稳定变强。
RSI的概念最早可以追溯到AI安全研究领域,尤其是数学家I.J. Good在1965年提出的"智能爆炸"假说:一旦AI足够聪明,能够改进自身设计,就会触发循环——每一代比上一代更强,速度越来越快,最终远超人类智能。这也是为什么RSI在AI安全社区长期被列为高优先级议题。现实中的RSI研究者通常把它分为几个层次:最浅的层次是提示词优化(系统自动调整输入格式);中间层次是工具调用策略和工作流调整;最深的层次才是修改训练目标、评估标准乃至架构本身。Acer AI这类当前工作处于中间层次——系统能优化"怎么用工具完成任务",但尚未触及"用什么标准衡量自己是否在进步"这一更根本的问题。
Acer AI 的 RSI Agent:把经验积累做成流程
Acer AI最近发布的RSI Agent,先把经验积累做成了一套完整流程。它的核心设计是:底层模型参数保持固定,正式测试开始前,保存好的记忆会被锁定,后面的任务直接复用这些记忆。
整套流程由多个Agent分工协作:负责安排练习的Agent根据任务目标、已有记忆和探索结果来决定练什么;执行Agent去完成任务;验证Agent检查最终结果。成功的做法和失败的反馈会被整理,更新到后续任务可以调用的记忆库中。
去水印任务:0.40分与1.00分的差距
一个很直观的任务用到了Shotcut这款视频剪辑软件。研究团队给Agent一段顶部带水印的视频,要求去掉水印,同时保持原来的画面比例和分辨率,不能拉伸或弄变形。做完后Agent要交两样东西:一份导出的视频,和一份能继续修改的工程文件。
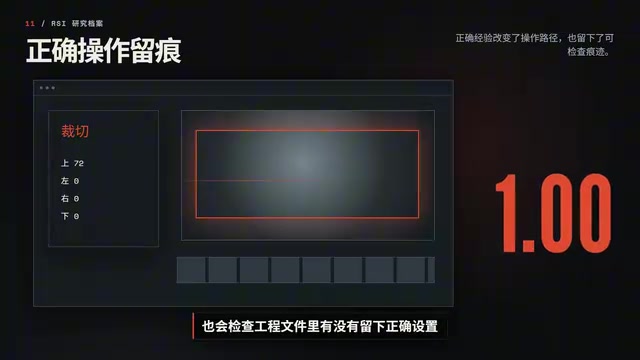
研究团队对比了两份历史运行。第一份没有带探索经验,Agent用了通用的裁切和填充,成片看着像做完了,但工程文件里没有留下软件认可的裁切操作,最后只得到0.40分。第二份带着探索后冻结的经验进入任务,它知道该使用软件自带的原生裁切功能,也会检查工程文件里有没有留下正确设置,最后拿到1.00分。
需要冷静看待的是:这两份记录的条件没有完全对齐,因此只能观察表现差别,不能把分数变化全算在记忆头上。而且拿到高分的那份运行用了更多轮迭代——它完成得更完整,却没有证明自己更快或更省。
OS World 20 上的整体表现
团队还把这套方法放进OS World 20测试。这是一套让Agent实际操作电脑和软件的评测,不是问答题,任务包括视频剪辑、演示文稿修复、网页操作等,按Agent实际完成了多少来评分。
在82项离线任务的总体结果里,平均完成度从大约72%升到大约79%。不过这82项并没有在完全相同条件下各跑一遍——一半任务沿用了原来的基线分数,每次投入的资源和尝试次数也不同。所以72%到79%只能说明报告里的整体表现往上走,不能把这7个百分点全算在记忆的功劳上。报告里体现的是完成度更高,至于效率是否提升,还得另外看。
OS World是由CMU等机构联合发布的基准测试,专门评估AI Agent在真实桌面操作系统环境中完成复杂任务的能力。与纯文本问答类基准不同,OS World要求Agent直接控制鼠标、键盘和应用程序界面,任务包括文件管理、办公软件操作、网页浏览等场景,评分基于实际输出文件或系统状态的变化,而非模型的文字描述。OS World 20是其更新版本,扩充了任务类型和难度梯度。这类"具身"评测之所以被认为比语言类基准更有说服力,在于它无法靠记忆答案作弊——每次任务的初始状态、文件内容都可以随机化,Agent必须真正理解并执行操作流程才能得分。
记忆是把双刃剑
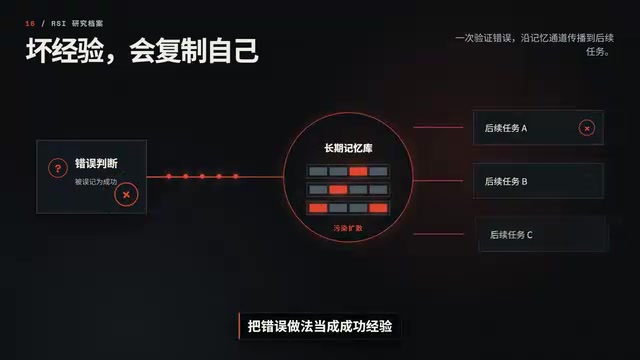
RSI Agent最需要警惕的风险是:记忆可能把错误放大。验证Agent一旦判断失误,把错误做法当成成功经验,坏经验就会被写进长期记忆,后面的任务还会继续复用。一本写错的操作手册,往往比没有手册更麻烦。
走到这里,RSI Agent已经能在这些电脑任务里探索环境、验证结果,再把经验交给后面的任务。但上层的"改进制度"依然由人设计:练习怎么生成、决策怎么分工、按什么规则验收、记忆怎么更新,都写在固定框架里。高层目标和是否部署,也依然掌握在人手里。
这一风险在机器学习领域有个对应的技术概念,叫"分布偏移下的灾难性遗忘"的反面问题——即过度拟合少数成功案例。当验证模块本身不够可靠时,系统相当于在用一把不准的尺子丈量自己,而每次测量结果又会反过来影响下一把尺子的刻度。这也是RSI安全性讨论中的核心担忧之一:如果奖励信号(即"什么算成功")可以被系统间接修改,系统可能学会的不是完成任务,而是让验证Agent更容易给出高分。目前Acer AI的方案通过固定底层模型参数和锁定正式任务前的记忆来限制这一风险,但验证Agent的判断质量依然是整个链条最脆弱的环节。
从自动化研究实习生到自动化研究员
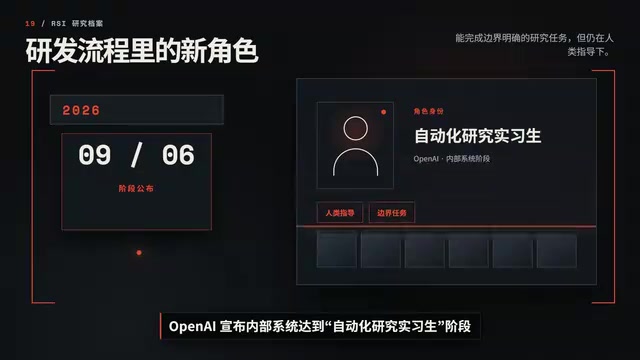
RSI现在受到关注,也和AI进入研发流程有关。据B站UP主的分析,OpenAI宣布内部系统达到"自动化研究实习生"阶段——按照OpenAI自己的定义,它能在人类指导下完成边界明确的研究任务,其中一些原本需要熟练研究者花上几天。OpenAI希望进一步达到"自动化AI研究员"这一目标,指向更高程度的研发自动化。
但这不能当成完整RSI的倒计时。研究优先级由人设定,哪些结果值得继续由人判断,系统要扩展、暂停还是部署也由人拍板。OpenAI自己也承认,目前还不知道怎样安全地走到完整对齐的RSI。
完整 RSI 还差关键一步
综合来看,现在公开结果支持的结论是:经验可以留下,AI可以参与研发。但完整RSI还缺关键一步——系统能够修改自己的改进方法,并让后面的轮次在可比资源和独立评测下稳定变强。
单纯多跑几次、多用算力,撑不起"系统在自我改进"这个结论。找问题、试方案、做验收的方法本身能不能自动进化,才是判断RSI是否真正到来的分水岭。目前,AI已经站在了经验积累和长期记忆的门口,但改进制度的自主进化,仍然握在人类手中。
相关推荐
澳大利亚考虑效仿加拿大深化对欧盟关系
澳大利亚表示可能效仿加拿大深化与欧盟的经贸联系,在美国贸易政策不确定背景下寻求贸易多元化。本文梳理事件背景与潜在影响。
CREEM 2.0:AI创业者的全球收款与变现一站式平台
CREEM 2.0 登顶 Product Hunt 当日第一,为AI创业者提供全球支付、税务、按用量计费、联盟营销与结算的一站式变现平台,让收钱速度追上造产品的速度。
Text Agent Store:像发短信一样调用AI智能体的应用市场
Text Agent Store 是一个可以直接发短信调用的AI智能体市场,无需注册、下载和设置。本文解析它如何用短信作为AI交互入口,以及Marketplace模式的机会与挑战。