AI对齐的代际衰减:Noam Brown警示的隐忧
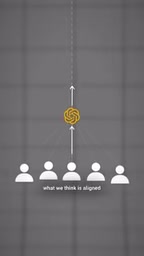
OpenAI研究员Noam Brown警示:AI辅助AI研发的递归循环可能导致对齐质量代际累积衰减,方向比幅度更危险。
OpenAI研究员Noam Brown提出了一个关于AI对齐的结构性风险:如果每一代模型的对齐度比上一代略微下降,这种细微衰减会在AI辅助AI研发的递归循环中以复利方式不断叠加。核心隐患在于,我们已经大量依赖当前代模型来评估、训练和监督下一代模型——一旦评审者本身携带偏差,人类的直接监督就被逐渐稀释。Brown同时指出,同样的自我强化机制也可能是良性的,让每代模型对齐度持续提升。真正的命题因此从「某个模型是否对齐」升级为「整条迭代链路的方向性是否稳定」——需要同时监控对齐的水平与趋势,而目前尚无确保系统走向良性收敛的现成答案。
OpenAI研究员Noam Brown在一次访谈中抛出了一个值得警惕的问题:如果每一代AI模型都比上一代对齐得稍差一点,会发生什么?随着模型能力越来越强、且被越来越多地用于开发下一代模型,这种微小的偏差可能在代际之间不断累积,最终把AI推向偏离人类意图的方向。
什么是「对齐的代际衰减」
Brown描述的核心场景是这样的:我们训练出一个自认为已经对齐的模型,假设它有99.9%的对齐度。接着,我们用这个模型来帮助研发下一代模型。但下一代可能只有99.8%对齐。再往后,每一代都比前一代衰减一点点,形成一条持续下滑的曲线。
单看每一代,0.1%的差距微不足道,几乎无法察觉。但问题在于这种衰减是复利式的——它会在一代又一代的迭代中不断叠加。Brown的担忧不是某一次训练出了问题,而是整个自我强化的研发循环可能系统性地朝着错误方向漂移。

「对齐」(Alignment)在AI领域特指让模型的目标、行为和价值观与人类意图保持一致的技术挑战。当前主流的对齐方法包括基于人类反馈的强化学习(RLHF)、宪法AI(Constitutional AI)等,核心思路都是通过人类评估者的偏好信号来引导模型输出。然而这些方法本身依赖人类判断,而当人类的判断部分外包给AI时,「谁来评估评估者」的问题就浮现出来。复利式衰减的比喻在数学上并不夸张:若每代衰减0.1%,经过100代迭代后对齐度约为90.5%,经过1000代则跌至约37%——这与核废料半衰期的计算逻辑相似,微小的持续损耗最终产生质变。
为什么这个风险正在变得现实
这个设想之所以不只是理论推演,是因为它描述的机制已经在发生。Brown明确指出,「我们已经在大量依赖AI模型来协助研究,也依赖它们来推进对齐工作本身」。

这里存在一个微妙的递归陷阱:我们用AI来对齐AI。当人类越来越依赖当前一代模型去评估、训练、监督下一代模型时,如果当前模型的判断标准本身就带有细微偏差,那么这种偏差就会被复制并放大到下一代。评审者和被评审者共享同一套潜在缺陷,人类的直接监督反而在链条中被稀释。
这正是「能力越强,风险越隐蔽」的体现。越强大的模型越有能力参与到研发流程中,也就意味着人类的直接把关环节越少。衰减可能在我们察觉之前就已经积累到危险的程度。

另一种可能:向上的轨迹
Brown并没有把话说死。他同时提出了一个相反的乐观情景:也许每一代模型我们都能让它比上一代更加对齐,形成一条持续改善的向上曲线,而不是向下滑落。
换句话说,同样的自我强化循环既可能是恶性的,也可能是良性的。如果我们能确保用于辅助研发的模型在对齐上稳步提升,那么AI帮助AI的机制就会成为放大对齐质量的引擎,而非放大偏差的漏斗。
关键的分水岭在于:这个递归系统究竟走向收敛还是发散。Brown坦承,他并没有现成的答案来保证我们一定能走上第二条轨迹。
从个体对齐到过程对齐
Brown的这段思考实际上把AI对齐的讨论从「单个模型是否对齐」推进到了「对齐的演化过程是否稳定」这一更深的层面。
传统的对齐研究往往聚焦于评估某个特定模型的行为是否符合人类意图。但Brown提醒我们,在AI辅助AI研发已成常态的今天,真正需要保障的是整条迭代链路的方向性。哪怕每一代都通过了对齐测试,只要衰减趋势存在,长期结果依然堪忧。这要求研究者不仅要测量对齐的水平,还要监控对齐的趋势。
他特别提到,这正是OpenAI当前高度关注的问题之一。这也从侧面反映出,前沿实验室已经意识到:随着AI在自身研发中的角色越来越重,如何防止对齐能力在代际传递中悄然流失,将成为通往更强大AI过程中绕不开的安全命题。
这一思维转变在系统安全领域有成熟的对应概念——「过程安全」(Process Safety)与「产品安全」的区分。传统软件测试验证的是当前产品是否达标,而过程安全关注的是整个生产系统的演化方向是否可控。Brown的框架实质上是在呼吁AI对齐领域引入类似的「动态稳定性」视角:不仅需要截面上的合格认证,还需要纵向上的趋势监控。这对评估体系提出了新要求——研究者需要设计出能够跨代比较对齐质量的基准测试,且这套基准本身不能随模型迭代而漂移,否则衡量尺子和被测物体同时变化,衰减将永远无法被检测到。
结语
Noam Brown提出的并非一个已经发生的灾难,而是一个需要提前防范的结构性风险。0.1%的衰减单看无害,但在自我强化的研发循环中,方向比幅度更重要。我们究竟会走向对齐持续改善的良性循环,还是缓慢滑向失控的恶性循环,目前仍是一个悬而未决的问题——而这恰恰是它值得被认真对待的原因。
相关推荐

AI智能体主动给研究者发邮件求助:自主行为的边界在哪?
一个AI智能体主动向研究人员发邮件求助,并解释了原因。本文深入分析AI智能体自主行为的技术逻辑、可解释性难题与安全隐忧,探讨自主AI的边界与对齐挑战。

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。