AI多快能成为专家?从拿破仑与洛克菲勒说起

AI有望在数月内达到人类顶尖水平,但受限于串行反馈瓶颈。
文章从拿破仑27岁连战连捷、洛克菲勒25岁经营最大炼油厂等历史案例出发,指出人类快速学习者的成长期只需几年而非几十年,AI应能复制甚至超越这一速度。AI可在几天日历时间内并行摄取企业全部邮件、消息和文档,并在第一天完成对员工和客户的"面试",积累数年部署上下文。但文章也明确边界:依赖真实世界因果延迟的反馈(如季度财报表现)无法被并行阅读绕过。核心论断是未来"后Spark"AI可在数月内于所有领域达到人类顶尖表现,同时提醒这是单一来源推演,信息壁垒和组织惯性可能比模型能力更早成为落地瓶颈。
历史中的快速成长者
历史充满了能力超群的年轻人,他们在自己身处的世界里远远甩开了同龄人。拿破仑27岁时已在对欧洲列强更大规模军队的作战中连战连捷;洛克菲勒25岁、进入石油行业仅两年,就经营着世界上最大的炼油厂之一。他们当然需要经验,但只需要几年,而不是几十年。
这段来自视频的观察引出一个核心问题:他们大脑中发生的那种快速学习,AI应当能够复制甚至超越。没有理由认为人类是"从经验中快速学习"的 ceiling。
AI的"经验积累"速度不在同一量级
与拿破仑或洛克菲勒不同,AI可以在短短几天的日历时间里积累数年的部署上下文。这是量级上的差异——人类的经验受限于串行时间,一天只有24小时,而AI可以并行处理海量信息。
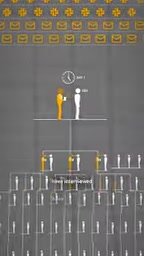
设想一个目标:让未来的AI比现任CEO更好地运营一家财富500强公司。它能多快上手?如果允许它跟随那位CEO学习,第一个上午它就能读完公司有史以来产生的每一封邮件、每一条Slack消息和每一份文档;到第一天结束,它的副本已经面试了每一位员工和主要客户。
这里的"部署上下文"(deployment context)指的是模型在真实任务环境中可访问的全部信息集合,包括企业内部文档、通讯记录、客户资料、历史决策档案等。与传统模型仅依赖训练语料不同,部署上下文是模型在特定组织内"上岗"后即时可读的私有知识。其规模往往远超任何单一人类在数年工作中能接触到的信息量,因此AI的"经验积累"本质上是信息摄取带宽的差异,而非学习算法的差异。
瓶颈与边界
这种推演显然有边界。AI无法获得需要数月串行时间才能到达的反馈——比如它在下一个季度财报上的表现如何。这类反馈依赖真实世界的因果延迟,不是靠并行阅读能绕过的。
换言之,AI的加速不是无限的。它能在信息摄取和模式识别上做到人类无法企及的密度,但涉及"做了之后等结果"的场景,仍然受制于物理世界的时间节奏。
串行时间反馈是指那些必须经过真实世界因果链条、按固定时间顺序才能产生的信号——例如产品上线后的市场反应、季度财报结果、组织变革后的员工士气变化。这类反馈无法通过并行计算或提前模拟来加速获得,因为其延迟由物理世界和制度节奏决定。AI的加速能力在"读"与"想"的环节几乎无限,但在"做—等—看结果"的环节仍受制于串行时间,这正是快速学习推演中最硬的边界。
核心论断:数月内达到人类顶尖水平
即便存在这些瓶颈,视频给出的判断依然激进:应当预期未来这类"后Spark"AI在数月内就能在所有领域达到人类顶尖表现。这里的"数月"指的是从被开发出来算起的日历时间,而非人类需要投入的成长期。
这个论断的基础在于:人类快速学习者的天花板并非认知上限,而AI不存在同等的生理与时间约束。拿破仑和洛克菲勒证明了少数人可以在几年内达到专家级水准;AI的假想路径则是把这个"几年"压缩到"几个月",并且是在所有领域同时发生,而非某一专门领域。
提一嘴,这属于单一来源的推演性观点,而非已观测到的实证结果。它依赖的前提包括:AI能有效消化企业的全部历史信息、能从中提取可操作的判断、以及并行面试式交互能替代真实的人际信任积累。这些前提是否成立,仍待验证。
这对从业者意味着什么
如果这一预期哪怕部分成立,企业引入AI的节奏就需要重新校准。关键不再是"AI能不能学会这个岗位",而是"我们是否准备好把足够的历史上下文和反馈通道交给它"。信息壁垒和组织惯性,可能比模型能力本身更早成为瓶颈。
相关推荐

AI时代程序员转型:旧技术该学多深?
AI冲击下程序员该如何转型?旧技术还要学多深?结合B站UP主分享,拆解拥抱AI的层次、学习方式从过程驱动到项目驱动的转变,以及技术壁垒降低对初级中级岗位的影响。

OpenAI发布GPT-6.2双模型Astra与Sol,API降价20%
OpenAI发布GPT-6.2 Astra与Sol两款模型,Astra的API价格下调20%至每百万token 8/40美元,并在Artificial Analysis Intelligence Index上排名第二。本文分析双模型策略、降价影响与开发者选型建议。

Perplexity Computer上线Multiagent:16个AI智能体交叉校验
Perplexity 为 Computer 推出 Multiagent 模式,主导智能体可调度最多 16 个基于 Claude、GPT、Gemini 的子智能体,共享发现并交叉校验工作成果,努力程度高于 Ultra 档位。