AI分析可溯源:让每个数据和结论都追踪到原文段落
AI分析工具正从"给出答案"进化为"给出可逐条核查的答案",可验证性成为成熟度关键指标。
本文围绕一项将AI分析结论追溯到源文档具体段落与表格的功能展开,指出这是解决AI"幻觉"问题、提升专业场景可信度的重要方向。相比仅提供文档级引用的工具,精确到段落和表格的定位才能真正降低用户的验证成本。与此同时,将引用预览内嵌于工作流,避免用户频繁跳出界面查阅原文,进一步减少了核查的摩擦。文章认为,对科研、法律、金融等高准确性要求领域而言,可验证性(verifiability)正成为衡量AI研究工具是否走向成熟的核心指标,标志着AI从辅助创意迈向辅助严肃研究的转变。
当AI分析变得可验证
在使用AI进行文献研究或数据分析时,一个长期存在的痛点是:AI给出的结论究竟从何而来?当模型输出一段看似专业的分析时,用户往往难以判断其中的数字和论断是否真实可靠,还是模型的"幻觉"产物。
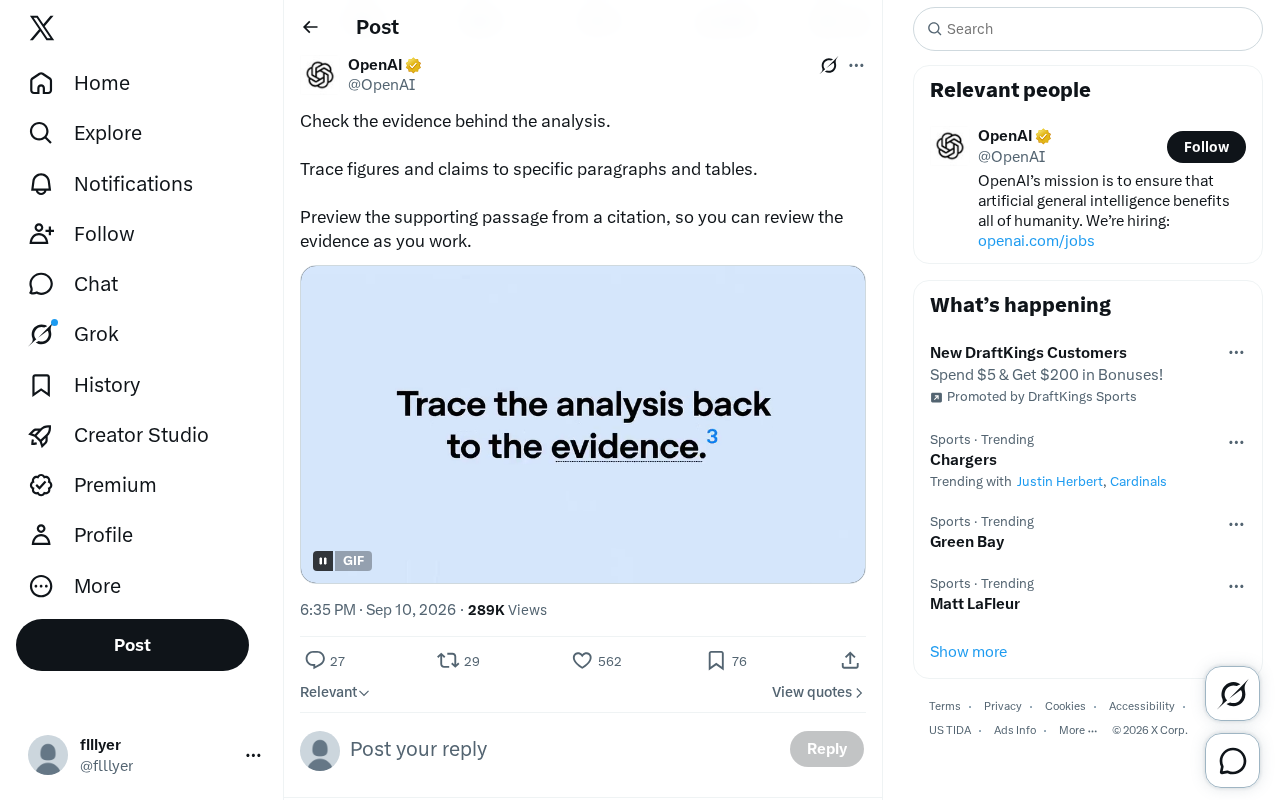
这条来自Twitter的分享聚焦于一项实用功能——将AI分析中的每一个数据、每一项论断,追溯到源文档中具体的段落与表格。换言之,分析不再是一个不透明的黑箱,而是可以逐条核对的推理链条。
追溯到具体段落与表格
原文强调了三个核心能力。其一是"核查分析背后的证据"(Check the evidence behind the analysis),意味着系统不仅给出结论,还保留了支撑这些结论的原始依据。
其二是将数字和论断"追踪到特定的段落和表格"(Trace figures and claims to specific paragraphs and tables)。这一点尤为关键——学术论文和研究报告中的核心数据通常分布在正文段落与数据表格里,能够精确定位到具体位置,才能让核查真正落地,而不是笼统地指向某篇文档。
为什么定位精度很重要
很多AI工具虽然提供了"引用来源",但往往只能给出文档级别的链接,用户仍需自己在长篇材料中大海捞针。而将引用细化到段落和表格层级,才真正降低了验证成本。对于处理大量文献的研究者来说,这种精度直接决定了工具是否好用。
边工作边预览证据
第三项能力是"预览引用的支撑段落"(Preview the supporting passage from a citation),让用户在工作过程中就能查看证据本身。
这种设计思路的价值在于将验证融入工作流。传统方式下,核对来源意味着要跳出当前界面、打开原文、翻找对应内容,流程被反复打断。而内嵌式的引用预览让用户可以"边工作边审阅证据"(review the evidence as you work),保持思维的连贯性。
对AI研究工具的启示
这类功能反映了AI工具发展的一个重要方向:从"生成答案"转向"生成可信的答案"。随着大模型在专业场景中的应用加深,可验证性(verifiability)正成为衡量工具是否成熟的关键指标。
对于科研、法律、金融等对准确性要求极高的领域,一个无法追溯来源的AI输出几乎没有实用价值。而当每一条论断都能回溯到原始段落时,AI才真正从"辅助创意"进阶为"辅助严肃研究"。
需要说明的是,这条推文本身是功能宣传性质的简短分享,未提供具体产品名称、技术实现细节或实测数据。上述分析基于原文所述的三项功能展开,读者若要评估其实际效果,仍需参考完整的产品文档与体验。
相关推荐
会话式家庭服务器:老旧笔记本的低功耗玩法
一位 Reddit 用户用十年老笔记本搭建会话式家庭服务器,每天只开机 10-12 小时运行 Plex、qBittorrent 和 Watcharr,三服务空闲内存仅 305MB。本文探讨会话式与 24/7 常开的取舍及极简 Homelab 运维思路。
OpenAI推出ChatGPT金融服务版:内置金融数据+GPT-6推理
OpenAI推出ChatGPT金融服务版:内置金融数据+GPT-6推理
OpenAI推出ChatGPT金融服务版,结合内置金融数据与GPT-6 Astra的推理能力,支持研究分析、财务建模和客户材料定制,面向金融机构的企业级AI工具。
安全基准测试揭示:AI工具的"外壳"比模型本身更关键
AI安全基准测试正逐渐暴露出一个被忽视的关键变量——测试框架(harness)。本文解析harness为何比模型本身更能影响安全能力表现,及其对基准测试方法论的深远启示。