AI副业实测:7种方法30天赚钱真相与盈利蓝图

真实测试揭示AI副业首月零收入,成功关键在于解决具体问题与构建工作流护城河而非兜售通用AI输出。
一位拥有全职工作的普通人对七种AI赚钱方法进行了为期六个月的严谨测试,结果显示首月收入为零,AI自由写作38小时只赚15美元,而解决具体专业问题的定制GPT则收入超1.2万美元。文章揭示了AI副业失败的结构性根源:AI让内容生产极度廉价,导致通用赛道竞争奔向价格底线;同时存在60至90天的流量空窗期,大多数人在此时放弃。真正的制胜逻辑是将"出售AI输出"转变为"出售完整业务工作流",锁定具体问题、实现可衡量的ROI,并通过数据、行为、工作流三层护城河及RAG技术构建防御性。此外,AI应用存在真实的可变成本,毛收入绝不等于净收入,变现模式选错可能在起步前就扼杀一家公司。
用真实数据戳破AI暴富神话
社交媒体上充斥着「几条提示词就能建立被动收入帝国」的宣传,但当一位拥有全职工作的普通人真正下场,严谨测试七种AI赚钱方法后,第一个月的收入结果令人清醒——零美元。
这不是为了打击「一夜暴富」的追梦者,而是要把真相摆到台面上:如果你从零开始、毫无受众积累,实现真正盈利的时间线远比网络导师们鼓吹的要漫长得多。AI最危险的地方在于,它擅长让一切「听起来都可行」。它能在几秒内头脑风暴50个创业点子,一下午写出一本电子书,但创造内容不等于创造需求。
正因为AI让内容生产变得极度廉价,竞争也随之爆炸式增长。真正的目标不是不停地生产那些淹没在饱和互联网中、无人问津的通用内容,而是找到AI能真正创造杠杆效应的地方。
为什么大多数AI副业注定失败
一项长达六个月的测试揭示了残酷的对比。AI自由写作在投入38小时后,总共只赚到15美元——因为在通用AI写作领域竞争,本质上就是一场奔向「0元价格底线」的赛跑。无脸YouTube频道和Canva AI模板也几乎颗粒无收:在没有数月甚至数年积累的权威性之前,你对算法和外部世界而言完全隐形。
关键在于,这些失败是结构性问题,而非努力问题。
与之形成鲜明对比的是定制化GPT机器人,这个方向赚到了超过1.2万美元。原因在于,它不是在兜售通用的AI输出,而是为目标客户解决了一个高度具体、反复出现的专业问题。
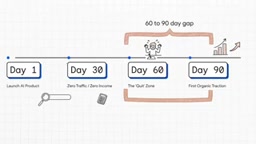
另一个让人放弃的陷阱是对时间线的误判。从推出AI产品到看见自然流量增长,中间存在一个残酷的60到90天空窗期。你上线后的头两个月往往是死寂一片——零流量、零收入。大约在第60天,就是所谓的「放弃区」,大多数创作者在此时缴械投降,误以为整套方法就是骗局。而对于SEO驱动的联盟博客,数据(比如搜索展示量的攀升)其实早在收入进账之前就已经在证明方法有效了。
制胜公式:具体性与自动化
决定成败的核心变量,不是你用了哪个闪亮的新模型,而是问题的具体性。你必须锁定一个具体的人,解决一个高度具体的问题。
一个成功案例并没有笼统地「卖AI」,而是为一位管理咨询顾问打造了专门处理每周更新邮件的定制GPT,并用对方自己的文档进行训练。它瞄准的是一项重复性任务,交付的是立竿见影、可衡量的投资回报——每周为这位顾问省下90分钟。
这里的心态转变至关重要:从出售AI输出,转向出售完整的业务工作流。
正如一位在30天内测试了七种方法的开发者精准总结的那样:「让我赚到钱的不是AI,而是自动化。」AI只是更大管道中的一小块拼图,真正的商业价值来自于为企业自动化那些重复的、痛苦的、消耗营收的任务。人们愿意掏钱买单的,是包裹在AI外层的工程与工作流,而绝非原始的提示词生成本身。
构建难以复制的护城河
如果你在AI之上构建软件,你构建的就是业内所称的「套壳」(wrapper)。但薄套壳和厚套壳之间存在天壤之别。
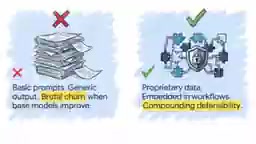
薄套壳本质上只是一个基础提示词模板,外加一层漂亮的UI皮肤,输出通用、同质化严重。这类产品面临惨烈的用户流失——ChatGPT一更新,用户立刻跑光,因为没有任何理由留下来。
厚套壳则利用专有数据管道,深度嵌入用户的日常工作流,从而创造出可复利积累的防御性。要防止竞争对手在一个周末就克隆你的产品,你需要构建三层护城河:
三层防御体系
- 数据护城河:捕捉用户的修正,积累出一份别人没有的独特数据集
- 行为护城河:设计反馈闭环,让每一次点赞或编辑都能让产品变得可衡量地更聪明
- 工作流护城河:把工具直接嵌入企业的CRM或日常流程,拉高切换成本,让「拆除」你的产品变成客户实际的运营噩梦
要真正筑牢数据护城河,最强大的工具之一就是RAG(检索增强生成)。这可以说是你能做的杠杆率最高的技术投资。RAG将基础模型连接到独特的专有知识库——比如企业内部文档或历史客服工单——让AI不再从开放互联网上盲目猜测,而是从你的特定数据中检索事实,把回答锚定在现实之上。这正是构建一款企业真正信任的产品的途径。
「套壳」(wrapper)这一概念在AI创业圈中颇具争议。狭义上,它指的是开发者调用OpenAI、Anthropic等大模型的API,在其上层封装一套用户界面和业务逻辑,而非从头训练自己的模型。这种模式的吸引力显而易见:无需数亿美元的算力投入,任何人都可以快速搭建看起来功能完备的AI产品。然而,批评者指出,纯粹的薄套壳产品缺乏技术壁垒——底层模型能力的任何提升都可能直接取代上层产品的核心价值,而竞争对手只需一个周末就能克隆出相同的功能。这也是为什么区分「薄」与「厚」如此重要:真正有价值的套壳产品,其护城河来自于对特定行业数据的积累、对用户工作流的深度嵌入,以及随时间不断自我强化的反馈机制,而非模型本身的能力。
RAG(Retrieval-Augmented Generation,检索增强生成)是一种将大语言模型与外部知识库结合的架构范式。其核心思路是:当用户提出问题时,系统首先从企业私有文档、数据库或历史记录中检索出最相关的片段,再将这些片段连同原始问题一起送入语言模型,由模型基于检索到的真实内容生成回答,而非单纯依赖模型训练时记忆的知识。这一机制解决了大模型的两个关键缺陷:一是「幻觉」问题(模型编造不存在的事实),二是知识截止日期问题(无法获取训练数据之后的最新信息)。对于企业应用而言,RAG意味着可以将内部SOP文件、合同条款、客服历史等私有数据直接赋予AI,同时确保数据不必上传至模型训练集,在一定程度上保护了数据隐私。正因如此,RAG成为当前企业级AI应用落地的主流技术路径之一。
AI经济学陷阱:毛收入不等于净收入
传统软件每增加一个用户,托管成本几乎为零;而AI应用有着实实在在的可变成本。每一次API调用、每一次生成、处理的每一个token都在真金白银地花钱。
如果你收取固定订阅费,却允许用户无限生成,少数重度用户就能堆起巨额API账单,彻底吞噬你的利润。如果不持续追踪「每次生成」的AI成本,一个看似盈利的应用可能瞬间变成巨大的财务亏损。在AI领域,毛收入绝不等于净收入。
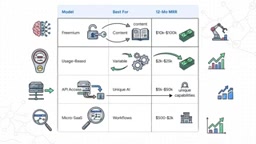
正因如此,选择变现模式是生死攸关的决定:
- 免费增值订阅:适合广泛的内容工具
- 用量计费:当成本随使用量直接上升时的必选项,如按次生成或积分制
- AI访问授权:适合拥有高度独特能力的产品
- SaaS微产品:适合超具体、窄领域的业务任务,虽然需要时间积累recurring revenue
为用户的真实行为选错结构,可能在创业公司起步之前就把它扼杀。
理解AI应用成本结构,需要了解「token」的计费机制。Token是大语言模型处理文本的基本单位,大致上每750个英文单词或500个中文汉字对应约1000个token。主流模型API按输入token和输出token分别计费:输入token指用户发送给模型的内容(包括系统提示词、上下文历史、检索到的文档片段),输出token指模型生成的回答。在实际应用中,一次看似简单的对话可能携带数千token的系统提示和上下文,使得真实成本远超预期。对于允许长文档处理或多轮对话的产品,单次请求消耗的token量可轻松达到数万,这正是「重度用户堆起巨额账单」的技术根源。因此,产品设计阶段就需要对提示词长度、上下文窗口策略、缓存机制等进行精细化管理,否则随用户规模增长,成本曲线将呈非线性上升。
可持续盈利的四步蓝图
所有洞察最终汇聚成一套精确的行动蓝图:
- 找到人们已经想解决的问题。不要试图发明全新的问题,去寻找人们已经在浪费时间或金钱的地方。
- 给AI一份清晰、严格受限的工作。让它待在工作流内部,不要妄图让它无所不能。
- 构建以营收为导向的最小可行产品,立即测试是否真有人愿意付费。
- 为留存而设计。产品必须在第一次使用中就交付可衡量的成功结果,用户才有理由回来。
最后留下一个发人深省的问题:你能用AI更快解决什么具体问题? 注意,这个问题不是「你如何用AI赚钱」。
技术本身只是一个撬动杠杆的工具,而商业永远关乎真正的问题解决。是时候停止让AI为你凭空「变」出一门生意,转而思考AI如何帮你为真实世界的问题构建更好的解决方案——持久的机会,恰恰藏在那里。
相关推荐

Rysh Forge 实测:一份 OpenAPI 规范自动生成 Claude 可调用的 Agent 工具
Rysh Forge 用一条命令把 OpenAPI 规范自动转换成 Claude 可调用的 Agent 工具,同时生成 MCP server、Python SDK 和文档,并对写操作强制人工确认,实现全链路可观测。本文解析其工作流与价值。

OpenAI Agents SDK 实战:如何实现 Human-in-the-Loop 人工审批
基于 OpenAI Agents SDK 实现 Human-in-the-Loop 人工审批机制的完整教程:从 needs_approval 暂停工具调用、捕获 interruptions 中断,到 approve/reject 决策与 RunState 状态序列化恢复,让 AI Agent 在执行高风险操作前先征得人类同意。

MaRN开源:用低维参数映射训练神经网络的PyTorch库
开源PyTorch库MaRN通过低维参数映射训练神经网络,MNIST CNN参数压缩57.7倍仍保持91.8%准确率。本文解析其基准测试、功能构成与适用场景。