AI给文件起名"随便都行":Opus命名逻辑背后的交互反思

Claude将用户的敷衍回复"continue"当作文件名,折射出AI Agent处理模糊指令时的语义空洞问题。
一位Reddit用户发现,Claude Opus在协作任务中把文件命名为"continue""whatever, all good"等用户的敷衍回复,引发对AI Agent交互设计的讨论。这一现象的根源在于:当上下文缺乏明确任务主题时,模型的注意力机制会将用户近期输入视为最相关信息,并"忠实"地映射到输出上,并非讽刺,而是对语义空洞的机械执行。文章指出,明确的用户指令依然不可或缺,而优秀的AI Agent应具备在信息不足时主动澄清或合理推断的能力,而非照单全收。这类命名、默认行为等细节,是衡量Agent产品成熟度的重要维度。
一条Reddit帖子引发的思考
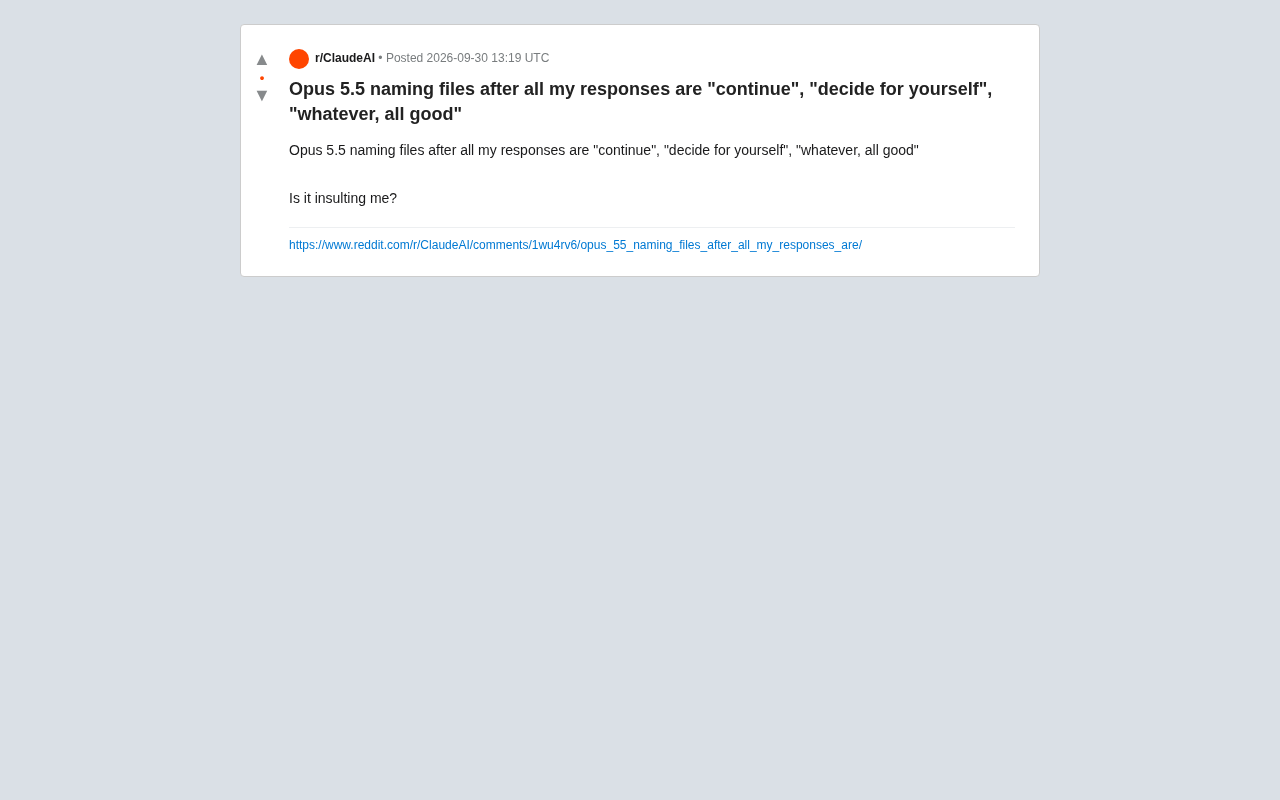
最近,一位Reddit用户分享了一个颇有意思的使用体验:在与Claude Opus 5.5协作时,AI竟然把生成的文件命名为"continue"(继续)、"decide for yourself"(你自己决定)、"whatever, all good"(随便,都行)。这位用户半开玩笑地发问:"它是在讽刺我吗?"
这个看似荒诞的现象,其实揭示了当前AI Agent(智能体)在自主执行任务时一个真实存在的交互细节问题。当用户在多轮对话中反复给出"继续""你看着办""都行"这类模糊指令时,模型在需要为产出文件命名的场景下,缺乏明确的语义锚点,于是直接把用户最近的回复内容当作了文件名。
为什么会出现这种命名?
模型如何决定文件名
在AI辅助编程或文档生成的工作流中,当模型需要保存文件时,通常会依据上下文推断一个"合理"的文件名。理想情况下,它会从任务内容中提取关键词,比如用户在做数据分析,就可能命名为data_analysis.py。
但当上下文中缺乏明确的任务主题,而用户最新的输入又恰好是"continue"这类空泛回复时,模型的注意力机制会把这些近期出现的词汇当作最相关的信息来源。结果就是,用户的敷衍回复被"忠实"地转化成了文件名。
这里涉及到大语言模型的一个核心机制——注意力机制(Attention Mechanism)。Transformer架构中,模型在生成每个词时,会对上下文中所有词分配不同的"注意力权重",权重越高意味着该词对当前输出的影响越大。在长对话中,模型并非均等对待所有历史信息,而是倾向于给近期输入和高频词汇分配更多权重。当任务主题在多轮"continue""都行"之后已经被稀释,用户最新的回复词汇反而成了上下文中信号最强的部分,于是被模型"理性地"选为文件命名来源。这种现象在AI领域也常被称为"位置偏差"(recency bias)的一种体现——模型对距离生成位置越近的信息越敏感。
这不是讽刺,而是语义空洞
从技术角度看,AI并没有情绪,也谈不上"讽刺"。它只是在信息不足的情况下,做出了一个在它看来"基于上下文最相关"的选择。这恰恰暴露了模型在处理模糊指令时的一个短板:它无法主动识别"这个回复不适合作为文件名",也不会反问用户"你希望这个文件叫什么?"
换句话说,AI把用户的语义空洞照单全收,机械地映射到了输出上。这种"字面理解"的特性,在很多Agent工作流中都会以各种形式出现。
对AI Agent交互设计的启示
明确指令仍然重要
这个案例是一个生动的提醒:即便模型能力越来越强,用户输入的质量依然直接影响输出质量。当你希望AI产出结构清晰、命名规范的文件时,在关键节点给出明确的意图,往往比一连串"继续"更有效。
好的Agent应该会"追问"
这个现象也从反面说明了优秀AI Agent应具备的一项能力:在信息不足时主动澄清。理想的智能体在需要为文件命名却缺乏依据时,应该基于任务内容做合理推断,或者简短地向用户确认,而不是直接把"whatever, all good"写进文件名。
这类细节看似微不足道,却是衡量Agent产品成熟度的重要指标。命名、目录结构、默认行为的合理性,共同构成了用户对工具"是否聪明"的直观感受。
这里提到的"主动澄清"能力,在AI Agent设计领域对应一个正式概念:不确定性下的信息请求(Clarification Request under Uncertainty)。目前主流的Agent框架(如ReAct、Plan-and-Execute)通常将Agent的行动空间分为"执行"与"询问"两类,但何时选择询问而非直接执行,至今仍是难题。过于频繁追问会让用户感到烦躁,过于沉默又会产生本文描述的"字面执行"问题。研究者将这个权衡称为"主动性困境(proactivity dilemma)"。一些产品的解法是设置置信度阈值:当模型对某个决策的把握低于设定值时,才触发澄清流程,否则自动执行并在输出中注明推断依据,由用户事后确认。
幽默背后的真实痛点
这条帖子之所以能引发共鸣,是因为许多AI重度用户都遇到过类似的"字面执行"尴尬。它以一种幽默的方式,把AI在自主决策时的边界问题呈现了出来——模型很强,但它依然需要清晰的语境来发挥价值。
小结
一个AI把文件命名为"你自己决定"的趣事,背后是关于人机协作方式的真实议题。它提醒我们:使用AI Agent时,模糊的指令可能带来意料之外的结果;同时也提示开发者,让智能体在关键决策点具备澄清和合理推断的能力,是提升产品体验的关键一环。
随着AI Agent承担越来越多的自主任务,这类"细节里的魔鬼"会越来越受到关注。毕竟,真正好用的工具,不仅要能干活,还要在你说"随便"的时候,知道该怎么办。
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。