AI工程师必知:五大核心模块解析

拆解构成当今AI产品的五大核心模块及其组合逻辑。
文章系统梳理了当今AI产品反复出现的五大核心组件:作为系统"大脑"的大语言模型(经历预训练、SFT、RL三阶段训练)、将输入映射到高维空间以支撑搜索与推荐的嵌入模型、为模型外挂内部知识并附带引用的检索增强生成(RAG)、围绕LLM执行工具调用与管理上下文的Agent Harness,以及预测环境下一状态的世界模型。作者强调这些模块并非孤立存在,编程Agent、客服机器人、推荐系统都是它们的组合产物。与其追逐每个新框架,不如吃透这五块"积木",从而获得跨越产品周期的稳定知识。
为什么这些模块反复出现
从 ChatGPT 到 Waymo 自动驾驶,当今大多数 AI 产品并非从零发明,而是由一组反复出现的核心组件拼装而成。理解这些"积木",你就能快速看懂任何 AI 系统的骨架。本文基于 YouTube 技术频道的系统梳理,拆解五大模块:大语言模型、嵌入模型、检索增强生成、Agent Harness 和世界模型。
这些模块并非孤立存在——一个编程 Agent 是 LLM 加 Harness,一个内部客服机器人很可能是 RAG 系统,而推荐系统则几乎都由嵌入模型驱动。掌握它们,等于拿到了拆解 AI 产品的通用工具箱。
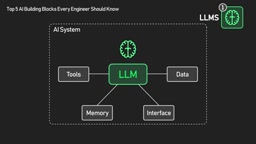
1. 大语言模型:系统的大脑
LLM 是基于 Transformer 架构的神经网络,核心能力是给定词序列预测下一个词。正是这一能力撑起了早期 ChatGPT 的体验。
但"预测下一个词"只是表象。LLM 真正的价值在于它能处理上下文、理解含义并决定下一步该做什么——它是整个 AI 系统的"大脑"。这也是为什么在五大模块中,LLM 处于最核心的位置。
前沿 LLM 训练的三阶段
一个前沿模型的诞生通常经历三步:
- 预训练:模型阅读互联网上数万亿词汇,习得语法、事实和基础知识。
- SFT(监督微调):通过学习精选的问答样例,模型学会"真正回答问题",而不只是续写文本。
- RL(强化学习):模型生成多个回答,并根据人类偏好的答案进行加权,相当于反复练习。
这三阶段的分工值得记住:预训练给"知识",SFT 给"对话格式",RL 给"人类偏好对齐"。
Transformer 架构是 2017 年 Google 论文《Attention Is All You Need》提出的神经网络结构,其核心是自注意力机制(self-attention):序列中每个词都能直接关注到其他所有词,并动态计算彼此的相关权重。相比循环神经网络(RNN)必须逐词串行处理,自注意力可以并行计算整个序列,极大提升了训练效率,也让模型能捕捉长距离依赖。GPT、Claude、Gemini 等主流大模型均建立在 Transformer 的解码器结构之上,"预测下一个词"正是通过堆叠数十层注意力与前馈网络逐步实现的。理解这一点,就能明白为何上下文长度、算力规模会直接决定模型能力边界。
SFT 与 RLHF 的区别常被混淆。SFT(监督微调)是用人工编写的高质量"问题—答案"对做标准的下一词预测训练,本质仍是模仿,让模型从"续写网页"切换到"对话应答"。而 RL(此处通常指基于人类反馈的强化学习,RLHF)不直接告诉模型正确答案,而是让模型对同一提示生成多个候选回答,由人类(或奖励模型)标注哪个更好,再用强化学习算法(如 PPO、DPO)调整模型参数,使其更倾向输出被偏好的回答。前者教"怎么答",后者教"答得更好",二者结合才形成今天可用的对话模型。
2. 嵌入模型:让搜索成为可能
嵌入模型同样是神经网络,但训练目标完全不同——它不预测下一个词,而是把输入映射到一个高维空间(嵌入空间)。训练数据是数百万对样本:相关的样本在空间中彼此靠近,无关的则远离。
这个性质直接催生了搜索与检索能力。运行时,把用户查询映射到同一嵌入空间,就能找到语义相近的数据。Google 搜索就是典型例子:你搜 "cheap flights to Europe",关于 affordable airfare 的页面依然会出现,因为查询和页面被映射到了同一空间。
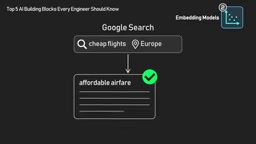
YouTube 和 TikTok 的推荐系统,底层同样是嵌入模型。理解了它,你就理解了现代搜索与推荐的地基。
3. 检索增强生成(RAG):给模型外挂知识
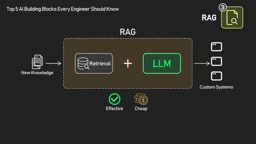
LLM 知识渊博,却答不了关于你内部文档的具体问题。RAG 填补了这个缺口:先用嵌入模型把你的内部文档建成知识库,运行时把用户查询嵌入并检索出相关片段,再将"查询 + 检索内容"一起交给 LLM 生成回答。
Notebook LLM 就是这种模式——你上传文档后提问,回答只来自这些文件,并附带引用出处。RAG 是一种高效且低成本的方式,让模型获得它从未训练过的知识,并构建真正适配你数据的定制系统。
RAG 的检索环节通常依赖向量数据库。文档被嵌入模型切成若干片段(chunk)并转成向量后,存入专门优化的向量数据库(如 Pinecone、Weaviate、Milvus 或 pgvector)。运行时系统对查询向量做近似最近邻搜索(ANN,常用 HNSW 等索引算法),在毫秒级内从百万级片段中召回最相似的若干条。检索质量高度依赖分块策略与嵌入模型选择:块太大噪声多,块太小丢上下文。此外还可加入重排序(rerank)模型对召回结果二次精排,进一步提升交给 LLM 的上下文相关性。
4. Agent Harness:给 LLM 装上手脚
LLM 能回答大多数问题,但遇到需要实时信息的场景——比如本周末的体育赛事——就无能为力。很多查询需要联网搜索或执行代码,而 Agent Harness 就是围绕 LLM 构建的系统层:它安全地执行函数、调用外部工具、把结果回传给 LLM,并循环往复直到模型给出最终答案。
Harness 还负责管理模型有限的上下文窗口、跨会话保持记忆、判断哪些操作需要人工审批。Claude Code、ChatGPT 等强大 Agent 的核心价值,恰恰在于这个围绕 LLM 构建的系统层,而不是模型本身。
**函数调用(function calling / tool use)**是 Agent Harness 得以工作的关键机制。开发者以结构化 schema 向模型声明可用工具的名称、用途和参数格式;模型在推理时若判断需要外部能力,会输出一个符合 schema 的调用请求而非普通文本。Harness 截获该请求、实际执行对应函数(如搜索、查数据库、跑代码),再把结果作为新消息回传给模型,如此循环。模型本身从不真正执行任何操作,它只"决定调用什么",真正的执行与安全边界全部由 Harness 掌控——这正是原文强调 Agent 核心价值在系统层而非模型本身的技术原因。
5. 世界模型:预测环境的下一步
LLM 能预测下一个词,却未必理解物理规律和物体交互,无法产出环境的下一个状态。世界模型是另一类神经网络,训练目标是预测环境中接下来会发生什么,通常以视频形式呈现。
训练时,它观看海量视频并预测后续帧,从而学习物体如何运动与交互。运行时输入当前状态(如最近几帧)和可选的动作(如"向右移动"),输出未来几帧。DeepMind 的 Genie 3 生成可实时漫游的交互式 3D 世界,NVIDIA 的 Cosmo 模型则让机器人和自动驾驶在仿真中训练,再进入真实世界。
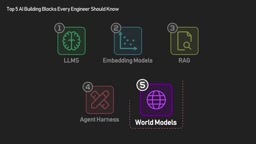
组合起来看:AI 系统的拼装逻辑
五大模块的意义在于组合。编程 Agent = LLM + Agent Harness;机器人 = 世界模型 + LLM;推荐系统 = 嵌入模型;内部客服机器人 ≈ RAG 系统。把这些模块放进你的工具箱,构建 AI 应用时会从容得多。
原文作者强调,这些模块会在真实 AI 系统中"一次又一次地出现"。与其追逐每一个新框架,不如先把这五块积木吃透——它们才是跨越产品周期的稳定知识。
相关推荐

GitHub日报·10月23日:Agent运行时与技能库同日爆发

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。