AI工具榜单正在误导你的技术选型决策吗?

排名式AI工具榜单因格式简化、快速过时和忽视切换成本,会系统性误导生产决策。
文章指出,AI工具排名榜单的问题不在于结论对错,而在于"排名"这一格式本身强迫作者对复杂现实做简化。它必须为每个类别选一个赢家,从而抹杀了同一类别下不同任务颗粒度的能力差异;AI能力以月为单位迭代,使三个月前的榜单在传播中被剥离日期后当作永恒真理;切换成本对个人用户与生产管线用户差异巨大,榜单默认服务前者并系统性误导后者。作者认为,真正长效的参考是类别划分与失败模式知识,而非具体排名,并提醒读者把榜单当作评估起点,而非部署决策依据。
一份榜单引发的连锁迁移
一位知名AI商业顾问发布了一份2026年AI工具分类排名榜单。Claude拿下写作类最佳,Higgsfield在视频生成上击败Sora和KlingAI。榜单干净、自信、易于传播——几天之内,它被截图、转发,甚至被一些人用来重构真实的生产管线。
但等大多数人看到它时,这份榜单已经部分过时了。更关键的是,评论区暴露出的问题,比榜单本身的偏差更值得警惕。
我想提出一个可能有争议的判断:排名式AI工具榜单不只是不够精确,它的格式本身就会对行动者造成一种可预测的、结构性的误导。问题不在于排名对不对,而在于排名这个格式强迫作者对底层现实做了什么简化。
排名格式抹杀了任务颗粒度
榜单需要一个赢家。一个工具获得"写作最佳"的标签。但写作是一个筐,里面装着几十种不同任务:长篇编辑内容、短社交文案、技术文档、邮件序列、产品描述、对话脚本。
Claude目前在长篇写作的语气一致性上确实优于多数替代品。这是真实且有意义的能力差异。中文AI社区的评论中有人提到,他们把文章写作工作流切换到Claude后,感觉它"更懂语域"。
话说回来,GPT-4o在同一讨论中获得了强有力的辩护——在速度和产出量比风格精度更重要的写作任务上,多位评论者专门反驳了写作排名,不是因为他们不认可Claude,而是因为他们自己的使用场景让GPT感觉更自然。
一份排名无法同时容纳这两种情况。它必须选一个,然后称之为"最佳"。任何看到"Claude:写作最佳"就据此行动的人,如果不了解评测者优化的是哪种写作任务,就已经被误导了——即便Claude确实出色。
时效半衰期比想象中更短
这份榜单发布于2026年3月初。在转发版本的顶部评论中,有一条简单的话:"这已经过时了,原视频是3月的。"这条评论获得了大量互动,因为人们立刻意识到了问题。
AI模型能力的更新周期,让三个月前的基准测试显得像远古遗迹。GPT Image 2.5在图像生成排名中明显缺席,多位评论者指出了这一重大遗漏。无论2.5在实际使用中是否真的优于榜单上的替代品,它的缺席本身就说明测试发生在一次重大能力更新之前。这不是小警告——这是一个结构性不同的工具在被比较。
视频生成类别有同样的问题。Kling和Higgsfield自榜单制作以来都发布了重要更新。排名捕捉了一个瞬间,而那个瞬间已经过去了。
这不是制榜者的错。格式制造了问题。一份写着"截至2026年3月最佳"的榜单,如果在6月被转发时丢掉了日期语境,就会被当作永恒真理来运作。而大多数截图分享的人,会完全去掉日期。
能力更新的节奏:2023年以来,主流大模型与生成式工具的能力迭代周期已从"年"压缩到"月"甚至"周"。GPT-4到GPT-4o、Sora从预览到正式版、Kling多次版本跳变,都属于同一量级下的能力跃迁,而非微调。这意味着任何一次基准测试都只是对某个具体快照的采样,一旦跨越某个版本节点,之前的排名结论可能整体失效。理解这一点,就能明白为何"三个月前的榜单"在AI领域几乎等同于"上一个技术世代"——这不是夸张,而是迭代速度与信息传播半衰期错配的必然结果。
切换成本被系统性低估
这产生了一个具体的失效模式:一位从业者看到"Claude:写作最佳",花一周时间迁移内容管线,发现自己的特定写作任务其实在原有方案上跑得更好,再花一周部分回退。
两周的工作流中断不是假设。当你把排名榜单当作部署决策而非自身评估的起点时,它就会发生。中文AI社区的那条讨论清晰地展示了这种分化:热衷于按榜单行动的人,大多在做个人项目;持怀疑态度的声音,大多运营着切换成本真实存在的生产管线。
榜单不知道你是哪一种人,也不可能知道。所以它默认服务于个人项目用户——那些人一下午就能换工具——而这个格式会主动误导生产用户——对他们来说,同样的切换要花好几天。
什么是切换成本:切换成本指从一个工具迁移到另一个工具时,除了订阅费用之外的所有隐性支出,包括重写提示词与工作流、重新校准输出质量、团队重新培训、与上下游系统的接口适配,以及迁移期间产出质量下降带来的机会成本。对个人项目而言,切换成本通常以小时计;对生产管线而言,同样的迁移可能涉及多环节联调与回归测试,成本以周计。排名榜单在呈现时天然剥离了这层成本维度,只比较"能力高低",因此对两类用户的误导程度完全不同。
什么才是真正长效的参考
这些榜单中的类别划分往往比各类别内的赢家更持久。"写作、图像生成、视频生成、编程助手"作为AI工具类型学的分类,在数月内是稳定的。各类别的具体赢家则不然。
如果你要用排名榜单作为决策输入,用它来识别你需要什么类别的工具、哪些名字值得评估,然后针对你的实际任务做一次窄范围评估。不是评测者的任务,是你的。
另一个能穿越排名更迭的东西是失败模式知识。"Sora在某些物体类型上产生不一致的运动物理"比"Higgsfield排名高于Sora"更具可操作性。失败模式是黏性的,排名不是。
失败模式知识为何更稳定:失败模式描述的是工具在特定输入下可复现的失效方式,例如"某模型在快速运动镜头上出现物体形变"或"某助手在长文档中段丢失指代一致性"。这类知识之所以比排名更持久,是因为它绑定的是模型的架构特性与训练数据偏差,而这些通常不会在一次版本更新中被彻底消除。相比之下,排名只给出"谁更好"的总体判断,无法告诉你在哪种输入下会翻车。把失败模式作为评估清单,可以把"选哪个工具"转化为"在什么条件下用哪个工具",后者才是可执行、可积累的决策知识。
这个格式为传播而优化,不为决策而优化
这是论点中不太舒服的核心:排名式AI工具榜单首先是内容产品。它们为可分享性而优化,意味着干净的格式、自信的结论、易记的类别标签。所有这些特性都在主动对抗那种能让榜单真正服务于部署决策的细微差别。
这不是愤世嫉俗。制榜的顾问把自己的工作做得很好——榜单完全按照设计运作。问题在于,消费榜单的受众把它当作了它从未被设计成的东西。
中文AI社区的那条讨论最终比榜单本身更有用,因为评论暴露了分歧:GPT Image 2.5缺席、Claude写作排名有争议、视频排名已过时、个人与生产用例拉扯方向不同。那些争论才是真正的信号。排名榜单只是包装。
值得反复琢磨的问题:当你上一次因为一份排名榜单而更换技术栈中的工具时,如果那个排名并不适用于你的具体任务,你付出的真实代价是多少?
相关推荐
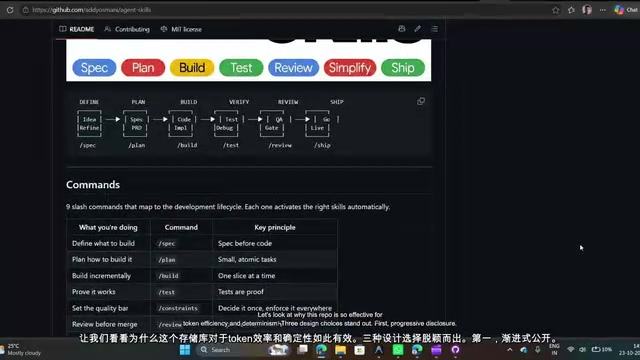
别再往CLAUDE.md塞两万行:10个技能砍掉上下文成本
与其往CLAUDE.md塞两万行规则,不如用渐进式披露的技能体系。本文拆解10个Claude Code技能:Addy Osmani Agent Skills、Graphify语义知识图谱、Superpowers子代理编排、LSP插件等,教你削减token成本并提升代码质量。

苹果iPhone Duo折叠屏开箱:万元级新物种值不值?
苹果首款折叠屏iPhone Duo开箱上手:顶配近5000加元,哑光内屏成最大亮点,折痕控制出色,护照式宽矮比例引领新形态。本文梳理屏幕、铰链、手感和价格的完整体验。
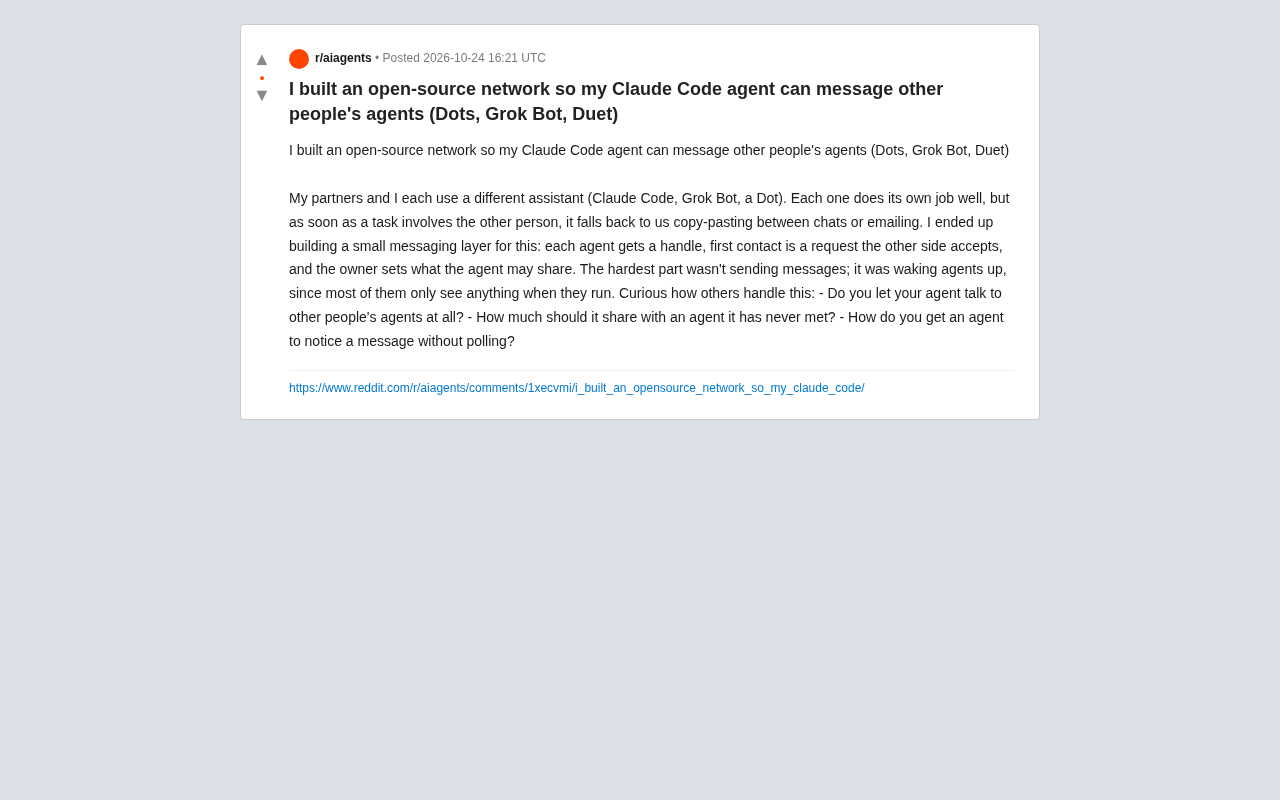
开源智能体消息网络:让Claude Code与其他AI助手直接对话
开发者构建开源消息层,让Claude Code、Grok Bot等AI智能体直接通信。项目采用句柄与握手机制控制权限,但唤醒休眠智能体成为最大技术挑战。探讨智能体互操作性的未来与信任边界。