AI合规审查:让智能体对照协会标准审核文档可行吗?
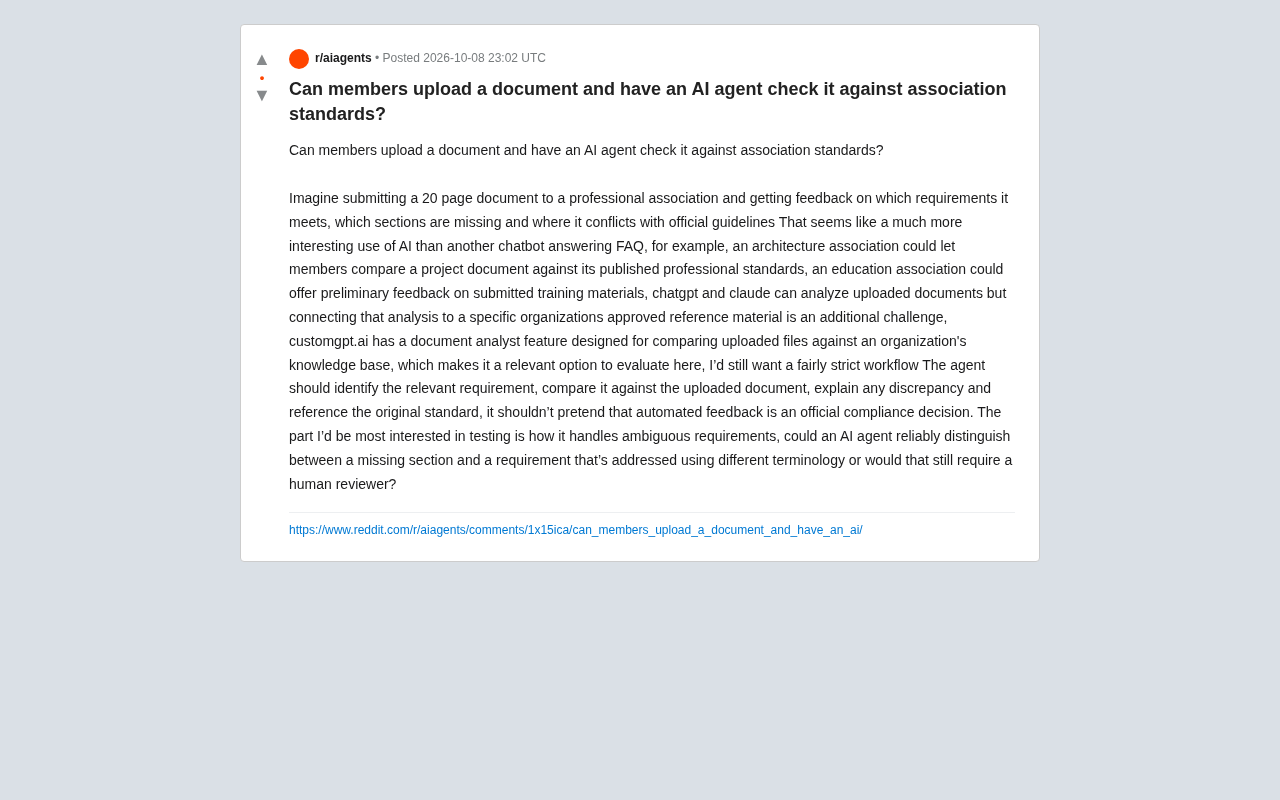
用AI智能体对照专业标准审查文档,比FAQ机器人更具实用价值,但核心难点在于知识库绑定与模糊要求的判定。
本文探讨了一种比FAQ聊天机器人更具深度的AI应用场景:让会员上传文档,由AI智能体对照组织官方标准逐条审查,指出已满足、缺失或冲突的内容。真正的技术挑战不在于文档理解本身,而在于如何将AI分析能力与特定组织的权威知识库精准绑定。理想的工作流应包含定位条款、逐条比对、解释差异、引用原文四个步骤,且AI输出必须定位为辅助意见而非官方合规裁定。最大的技术难点是模糊要求的判定——区分"换了术语但实质已满足"与"真正缺失",这直接考验模型的语义推理能力。合理的产品定位是"人机协同预审层",AI负责结构化列出问题清单,人类审查者负责最终确认,从而在效率与责任之间取得平衡。
从FAQ机器人到文档合规审查
大多数协会和专业组织部署AI时,第一步往往是搭建一个回答常见问题的聊天机器人。但一位Reddit用户提出了一个更有价值的应用场景:让会员上传文档,由AI智能体对照组织的官方标准进行审查,并指出哪些要求已满足、哪些章节缺失、哪些内容与指南冲突。
设想这样一个流程——会员向专业协会提交一份20页的文档,几分钟后就能收到结构化反馈。建筑师协会可以让成员将项目文档与已发布的专业标准进行比对;教育类协会可以对提交的培训材料给出初步意见。相比又一个回答FAQ的聊天机器人,这类"对照审查"显然是对AI能力更深入的运用。
核心难点:把分析绑定到特定知识库
ChatGPT和Claude都能分析上传的文档,这早已不是新鲜能力。真正的挑战在于,如何把这种通用分析能力与某个特定组织的权威参考资料连接起来。
泛泛地让大模型"看一下这份文档写得对不对",和让它"对照本协会第3版专业执业标准逐条核查",是两件难度完全不同的事。前者依赖模型的通用知识,后者要求系统能准确检索并引用组织内部那套唯一正确的标准文本。
原帖作者提到,customgpt.ai 提供了一个"文档分析师"(Document Analyst)功能,专门用于将上传文件与组织的知识库进行比对,因此被视为一个值得评估的候选方案。这类工具的意义正在于解决"绑定专有参考资料"这个关键环节,而非单纯的文本理解。
这一挑战在技术上通常通过 RAG(检索增强生成,Retrieval-Augmented Generation) 架构来解决。RAG 的核心思路是:不依赖大模型训练时内化的通用知识,而是在推理阶段实时从外部知识库中检索相关段落,再将检索结果作为上下文喂给模型生成回答。对于合规审查场景,这意味着系统需要先将组织的标准文档切片、向量化并存入数据库,用户上传文档后,系统会自动检索与文档内容最相关的标准条款,再由模型进行逐条比对。RAG 架构的质量直接决定了"绑定专有参考资料"这一环节的可靠程度——检索精度不足时,模型可能引用了错误或不相关的条款,导致整个审查结论失去可信度。这也是为什么评估此类工具时,检索准确率比模型本身的理解能力更值得优先关注。
一个严格的工作流应该是什么样
作者对这类AI审查提出了相当克制且专业的要求,值得照搬到任何类似项目中:
- 定位相关要求:智能体首先要识别出标准中与当前内容对应的具体条款;
- 逐条比对:将该要求与上传文档的实际内容进行对照;
- 解释差异:清楚说明文档在哪里、以何种方式偏离了要求;
- 引用原始标准:每条反馈都要回溯到标准原文,而非凭空判断。
最重要的一条底线是:自动化反馈不能冒充官方合规裁定。AI给出的是辅助性意见,最终的合规认定权应保留在组织和人类审查者手中。这种定位既规避了法律与责任风险,也让工具的价值边界更加清晰。
真正的考验:模糊要求如何处理
帖子最有洞察力的部分,是作者点出了这类系统最难啃的骨头——模糊要求的判定。
设想一条标准要求文档包含"风险评估说明"。文档里确实没有以"风险评估"为标题的章节,但其中某段文字用"潜在隐患分析"的措辞覆盖了同样的内容。此时AI该如何判断?
这里存在两种截然不同的误判风险:
- 把"用不同术语表达的已满足要求"误报为"缺失章节"(假阴性,制造不必要的修改负担);
- 反过来,把表面相似但实质不符的内容判定为合规(假阳性,放过真正的问题)。
区分"真正缺失"与"换了说法表达",考验的是模型的语义理解和领域推理能力。在术语高度专业、表述方式多样的行业文档中,这往往正是人类资深审查者的价值所在。作者的疑问也很现实:AI能否可靠地做出这种区分,还是说这一环节终究离不开人工复核?
这一问题在信息检索领域被称为语义等价性判断,也是当前大语言模型能力边界的典型测试点。现有模型在语义相似度判断上已有相当水准,但在专业领域文档中,"术语不同但含义等价"与"术语相近但内涵有差距"之间的边界极为微妙,单纯依赖向量相似度的检索方法往往力不从心。一种更稳健的工程实践是引入置信度分级机制:对高度确定的匹配或缺失标注为"明确结论",对语义相近但存疑的情况标注为"需人工复核",主动暴露系统的不确定性,而非强行给出二元判断。这样的输出格式既保留了自动化效率,又为人工审查者提供了明确的介入点,是目前在高风险合规场景中较为务实的折中方案。
这类应用的落地价值
从产品思路看,这个方向的吸引力在于它击中了专业组织的真实痛点:标准繁多、人工审查成本高、初审反馈周期长。一个能做"预审"的AI智能体,哪怕不能替代最终裁定,也能大幅过滤掉明显不合规的提交,让人类审查者专注于真正模糊和复杂的判断。
合理的产品定位或许是"人机协同的预审层":AI负责结构化地列出问题清单并附上标准引用,人类审查者在此基础上快速确认或推翻。这样既发挥了AI在规模化比对上的效率优势,又把最终责任留给了人。
对于考虑引入此类功能的组织而言,评估重点不应是"模型能不能读懂文档",而是三个更关键的问题:能否准确检索到对应标准条款、能否在反馈中可靠引用原文、以及在面对模糊措辞时的误判率有多高。这三点,才真正决定了一个合规审查智能体是实用工具还是又一个华而不实的演示。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。