AI黑箱其实清晰可见?可解释性研究颠覆认知

神经网络并非黑箱,多义性可能是观测工具与架构漏洞制造的假象。
文章基于Nick Camerota的研究《Neural Networks Are Already Clean》,挑战了AI学界长期持有的“黑箱”与“多义性”假设。作者指出,早期视觉模型中看似混合的神经元实为可视化工具优化算法作弊所致,如Inception V1的4E.55实为V形检测器。Camerota提出“递归泛化”机制,解释神经元如何沿语义邻近性逐步扩展响应范围,并通过瓶颈实验证明空间受限时模型选择更粗糙的概括而非混乱叠加。文章还揭示了SwiGLU双负漏洞如何伪造多义性,主张从枚举式转向探索式可解释性,并推论若模型内部高度可读,对齐风险不在于隐藏意图,而在于我们是否学会阅读其几何地图。
多年来,AI一直被描绘成一个无法穿透的黑箱——连创造者都说不清它内部如何运作。但一项来自Goodfire、作者Nick Camerota的研究《Neural Networks Are Already Clean》提出了一个颠覆性假设:神经网络本来就是干净的,我们看到的混乱,可能只是观测工具上的污渍。
本文基于YouTube科技频道的深度解读,结合多源交叉验证,梳理这项研究如何拆解“黑箱神话”,并探讨它对AI可解释性与对齐研究的深远影响。
黑箱神话的起源:多义性与叠加理论
AI学界长期相信一个叫“多义性”(polysemanticity)的现象:单个神经元会同时处理多个毫不相关的任务。为解释这种怪异行为,研究者提出“叠加”(superposition)理论——网络参数虽多,但概念更多,空间不够时,模型就像塞满杂物的抽屉,把不相关概念压缩进同一个神经元。
这一理论的“铁证”来自早期视觉模型Inception V1中的神经元4E.55。可视化工具显示,它会对猫脸和汽车前部产生强烈反应,看起来像典型的“猫车混合神经元”。
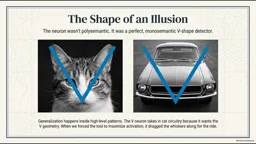
但Camerota重新审视架构后发现,这个神经元其实只是一个V形检测器:猫须、汽车镀铬引擎盖、狐狸脸、消防船喷射的水柱都呈V形,而圆形物体则抑制其激活。所谓“猫车混合”,是可视化工具用优化算法生成图像时走了捷径——训练数据中猫狗照片极多,工具便用动物脸来最大化触发V形通路。混乱不在网络里,而在工具里。
多义性(polysemanticity) 指单个神经元对多种语义上不相关的输入产生响应的现象。在深度神经网络中,研究者通过特征可视化发现,许多神经元并非只对某一类概念敏感,而是同时被猫脸、汽车、文字等多种刺激激活,这被视为网络内部表征“纠缠”的证据。
叠加(superposition) 是一种理论解释:模型拥有的参数维度有限,而需要表征的概念数量远超维度数,因此网络将多个概念压缩到同一组神经元上,以近似正交的方式共存。该理论预测,当稀疏性足够高时,网络会主动选择叠加来节省容量。这一框架长期主导了可解释性研究对“神经元混乱”的解读。
递归泛化:神经网络真正的学习机制
如果神经元不是乱塞概念,如何解释那些看似覆盖大量概念的神经元?Camerota提出“递归泛化”(recursive generalization):训练中,神经元像树枝分叉一样,基于关系向外扩展,而非待在孤立 rigid 的盒子里。
论文追踪了一个语言模型神经元:早期只检测字母组合“IY”,随后泛化到“Miyazaki”,再到“DIY”,最终对完整短语“do it yourself”强烈激活——尽管其中已无“IY”。类似地,一个行星地质神经元既对月球 crust、火星 crust 激活,也对JavaScript库Cesium JS激活。表面看像杂物抽屉,但追溯向量空间:Cesium是化学元素,化学元素关联地质学,地质学是行星 crust 的基础。模型是在语义邻近的节点间游走,而非随机混合。
递归泛化(recursive generalization) 描述的是神经元在训练过程中沿着语义关系链逐步扩展其响应范围的现象。它不同于简单的模式匹配:神经元先对某个局部特征(如字母组合“IY”)敏感,再通过共享的关系结构泛化到包含该特征的更长词组,最终对语义等价的完整表达产生响应。这一过程类似图上的随机游走,每一步都基于已建立的邻近关系向外延伸,因此表面上的“多概念响应”实为一条可追溯的语义路径的末端表现。
瓶颈实验:空间不够时,模型选择“概括”而非“混乱”
为验证这一机制,研究者做了瓶颈实验:一个视觉模型某层原本用480个专用神经元检测各种曲线和角度,他们将其压缩到仅10个神经元重新训练。按叠加理论,模型应开始胡乱混合概念。但结果相反——神经元只是变得更粗糙,形成宽泛的“曲线和环”检测器。
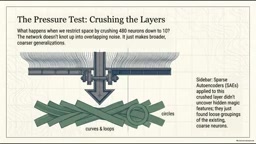
规模对比也印证了这一点:9.2万参数的小模型最后一层只有一个粗糙的“地面车辆”神经元,把汽车、高尔夫球车、火车混在一起;而2860万参数的大模型则有空间区分跑车和旅行车。同样的逻辑,只是分辨率不同。
负极性:神经元是控制流门,不是名词
一个关键误解是认为神经元像“名词”——汽车检测器看到汽车就亮。但数学上,神经元是控制流门,其身份由负极性同样定义。常用激活函数ReLU会把负值抑制为零,相当于硬过滤器。
论文用“圣诞老人谜题”说明:提示描述12月25日早晨、吃掉的饼干、空牛奶杯、地毯上的煤灰、屋顶的雪橇铃声。模型正确回答“圣诞老人”,但内部最重要的神经元却是强负向运行——它通过积极排除不符合线索的概念,让圣诞老人成为剩余的几何真相。
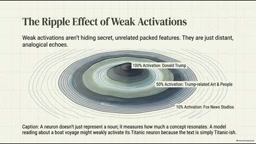
CLIP模型的例子同样直观:一个对唐纳德·特朗普照片强激活的神经元,其较弱激活会系统性扩散到MAGA帽、相关人物乃至Fox News演播室。这里仅说明网络按关系组织概念,不涉及政治立场。
SwiGLU双负漏洞:伪造的多义性
如果网络如此干净,为何Anthropic、OpenAI等机构的研究者长期认为模型混乱?答案指向现代架构中的数学“毛刺”。
最典型的叫SwiGLU双负漏洞。SwiGLU神经元将“门”向量和“值”向量相乘。当网络想关闭门(产生负值),而值向量恰好也是负值,两个负数相乘得到正输出——制造出虚假的激活信号。研究者看到一个神经元既检测俄语又关联《歌罗西书》,便判定为多义性,实则只是乘法回声。修正这个数学漏洞后,神经元恢复为干净的单一功能检测器。
SwiGLU 是Transformer架构中常用的一种门控激活单元,其计算形式为 (\text{SwiGLU}(x) = \text{Swish}(xW_g) \otimes (xW_v)),即门控分支与值分支逐元素相乘。由于两个分支均可取负值,当门控分支输出负值而值分支同时为负时,乘积为正,产生一个本不该出现的正向激活。这种“双负得正”的乘法回声会被误读为神经元对无关概念的响应,从而伪造出多义性假象。修正方式包括对门控分支施加非负约束或改用单侧门控结构,使神经元恢复单一功能。
从枚举式到探索式:可解释性的范式转移
Camerota主张放弃“枚举式可解释性”——试图为网络每个特征建立穷举表格,转向“探索式可解释性”:把网络当作一座组织良好的城市,用类似Google Maps的方式缩放向量空间,跟随交通流,而非清点每块砖。
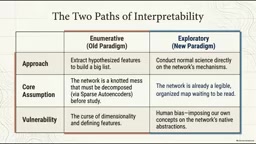
模型越大,区域越专用、越清晰。危险在于,研究者可能强行用人类范畴(猫神经元、车神经元)去切割AI自己的地图,找不到就宣称城市混乱。AI按几何和向量邻近性组织世界,我们需要学习它的语言——梯度、向量邻近、负极性。
对AI对齐的启示
这项研究最深刻的推论是:如果模型内部电路如此可读,欺骗或失控行为就无法藏在不可见的叠加维度里。它若在谋划什么,必须使用电路,必然暴露在高维地图上。真正的风险不是AI在黑箱中隐藏意图,而是我们是否愿意在地图变得不可读之前学会阅读它。
神经网络不是魔法,是数学。它已经把自己组织得足够可读——我们只是需要擦干净显微镜上的污渍。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。