AI角色跨场景一致性实战:从角色档案到提示词模板

通过角色档案、参考图复用与结构化提示词模板,系统解决AI多场景角色一致性难题。
本文针对AI生成内容中最常见的痛点——跨场景角色外观漂移——提出了一套完整的八步工作流。核心思路是:先建立区分"固定特征"与"灵活特征"的角色档案,再生成高质量参考图并在后续每个场景中持续复用,同时采用模块化提示词模板将角色身份与场景指令解耦,并在末尾加入显式约束防止模型引入意外变化。在视频制作层面,文章建议提前规划分镜连贯性、优先使用图生视频(I2V)而非纯文本驱动,并在每个片段生成后逐一对照参考图审查,而非等到全片完成才返工。文章最终强调:没有任何单一提示词能保证完美一致,可重复的结构化工作流才是专业成片的真正基础。
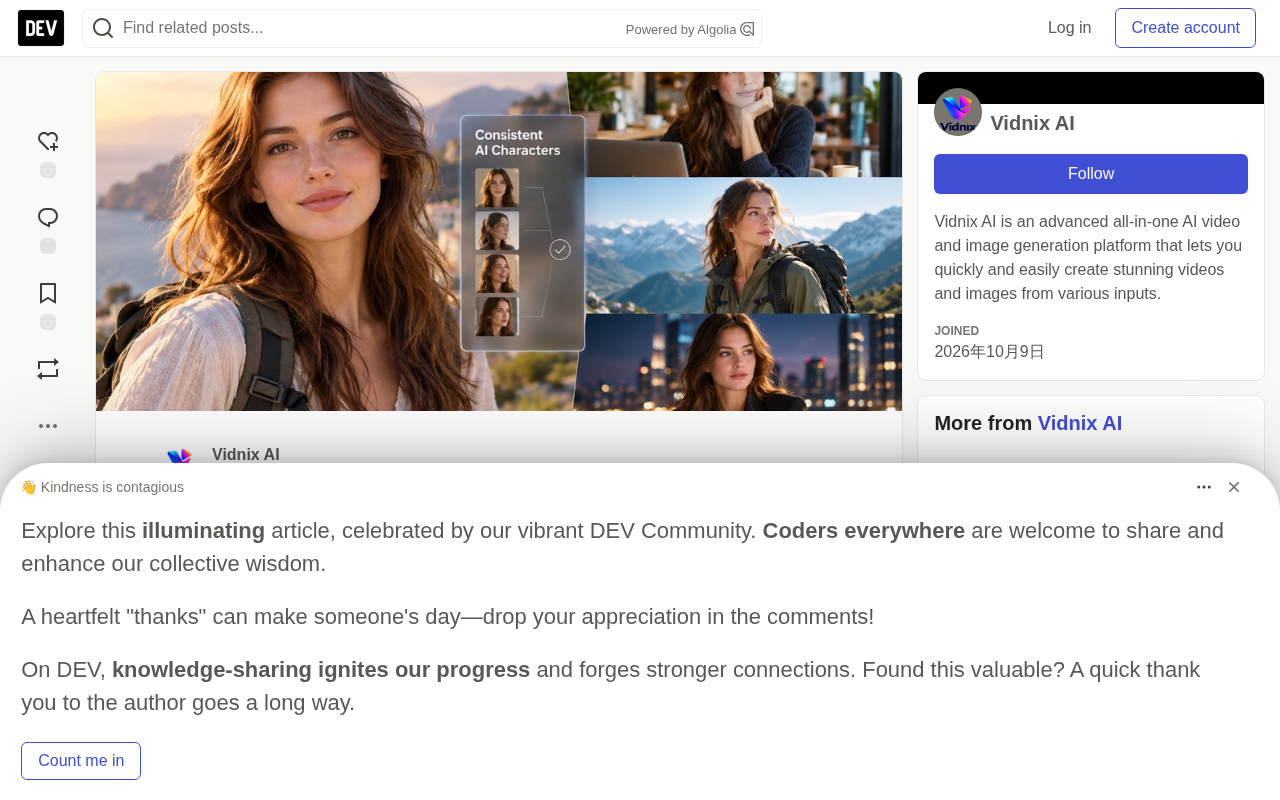
制作一个AI生成的角色从未如此简单,真正的挑战出现在你需要这个角色出现在多个场景中——面孔、发型、服装和整体外观都要保持不变。无论是制作电影级AI视频、短片、社媒内容、产品广告还是动画故事,角色一致性都是专业成片的关键。如果角色在每个镜头里都长得不一样,观众会难以跟上剧情,成片会显得支离破碎。
好消息是,通过一套结构化的工作流,你可以显著改善角色一致性。核心思路是:建立清晰的角色档案、使用参考图、保持提示词一致,并提前规划场景。
什么是AI角色一致性
AI角色一致性,指的是在多张AI生成图像或视频片段中保持同一个可辨识角色的能力。一个一致的角色应保留关键视觉特征,包括面部特征(脸型、眼睛颜色、鼻子、嘴唇)、头发(发型、发色、长度、质感)、服装(主要穿搭、配饰、标志性细节)、身材特征(身高、体型、比例、年龄),以及让角色在场景间可辨识的视觉身份。
一个重要前提是:一致性并不等于每一帧都完全相同。角色应该能够转身、行走、说话、表达情绪并与不同环境互动,同时保留可辨识的身份。设想一部短片中的年轻女性在未来城市中探索,她先出现在火车站,再走过拥挤的街道,最后进入屋顶咖啡馆——如果她的面孔、发型和服装在没有剧情原因的情况下频繁变化,这部视频就会像三段毫不相关的片段。
为什么AI角色会在场景间变化
理解角色漂移的成因,是改善一致性的前提。原文归纳了五个主要原因。
每次生成都可能有不同解读。 当你仅凭文本生成新场景时,模型可能对角色描述做出不同诠释。即便使用同一个名字,生成的面孔也可能改变。像"一位棕发的漂亮年轻女性"这样的描述,留下了太多开放空间。
提示词包含冲突细节。 在不同提示词之间更改多个角色属性会造成视觉不一致,比如一处写"长直发"、另一处写"短卷发",就是在给模型互相矛盾的指令。
镜头角度和光线影响外观。 特写、侧脸和远景提供的视觉信息不同;戏剧化的光影和调色也会让同一个角色看起来明显不同。
参考图可能未被有效利用。 参考图能帮助建立视觉身份,但其影响力取决于生成模型和可用的参考图控制。某些工作流在角色从不同角度出现或执行复杂动作时,对身份的保留效果更好。
视频运动引入额外挑战。 在AI视频中,角色必须在运动全程保持可辨识。行走、转身、表情变化和与物体互动,都可能在开头帧正确的情况下引入视觉漂移。
从技术层面看,主流文生图和文生视频模型(如Stable Diffusion、Midjourney、Sora、Runway等)在每次推理时都会重新从噪声中采样,并不存储任何"角色记忆"。模型所依赖的是提示词在高维语义空间中的表示,即便输入文字完全相同,随机种子(seed)不同也会产生外观各异的结果。部分工具提供了固定seed的选项,可在相同构图下减少差异,但一旦提示词或镜头角度发生变化,seed的约束作用就会大幅减弱。近年出现的IP-Adapter、ControlNet人脸模块、以及各平台自研的角色一致性功能(如Midjourney的Character Reference、Kling的角色参考),本质上是将参考图编码为额外的条件向量注入生成过程,从而在语义层面"锚定"角色身份,这也是为什么参考图比纯文本描述更能稳定外观的底层原因。
第一步:建立详细的角色档案
角色一致性的根基,是一份清晰、可复用的角色档案。在生成多个场景之前,先定义角色外观,并确定哪些属性必须保持不变。
以示例角色Emma为例:27岁,椭圆脸、柔和下颌线、鼻梁有淡淡雀斑、眉形分明;榛色眼睛;栗棕色长发带松散波浪、中分;肤色偏白带暖调;苗条有运动感的身材;标志性穿搭是米色针织毛衣、深色长裤、棕色皮质单肩包;左眼下方有一颗小美人痣;整体为写实风格,自然肤质,电影级光线。
区分固定特征与灵活特征 是档案管理的核心。固定特征定义角色身份:面部结构、眼睛颜色、发色、标志性印记;灵活特征则可随剧情变化:面部表情、身体姿态、镜头角度、光线、背景,有时也包括服装。如果角色在故事中换装,务必显式记录,避免有意的造型变化沦为不可控的视觉漂移。
第二步:生成高质量角色参考图
档案就绪后,先生成一张清晰的参考图,再去创作各个场景。好的参考图应清楚展示角色的定义性特征,细节足以辨识面孔、发型、肤色和服装。
对于写实角色,可用类似这样的提示词:"创建Emma的写实人物肖像,27岁女性,椭圆脸、榛色眼睛、鼻梁淡雀斑、左眼下方小美人痣、栗棕色松散波浪长发中分,肤色偏白带暖调,身穿米色针织毛衣。自然肤质、真实面部比例、柔和影棚光、中性背景、正面肖像、锐利的面部细节、一致的发型与面部身份。"
仔细审查结果再将其作为参考。如果面孔或发型有误,优先修正参考图本身,而不是逐一纠正后续每个场景。
构建一个小型参考集 会更稳妥:正面肖像、四分之三视角、侧脸、展示穿搭的全身图。这些参考能帮助确立角色从不同角度的样貌,尤其适用于涉及对话、运动或多机位的故事。注意保持它们在视觉上彼此对齐,避免使用明显不同版本的角色图。
第三步到第四步:复用参考图与可复用提示词模板
改善一致性最有效的技巧之一,是在工作流支持时反复复用同一张已批准的参考图。与其每个场景都让模型从文本重新"想象"一遍角色,不如提供参考图并说明什么应该改变。
从头手写每个场景提示词容易引入矛盾,更好的做法是把提示词拆成可复用的模块:角色身份、固定外观细节、服装配饰、场景环境、动作与表情、镜头角度与运动、光线与视觉风格、以及防止不必要变化的约束条款。
原文给出的模板结尾处有一句关键约束值得照搬:"保持与参考图相同的可辨识角色身份。不要对角色的面孔、发色、发型、眼睛颜色或标志性特征引入未请求的更改。只改变本提示词中明确描述的场景元素。" 这种结构把角色身份与场景指令分离,让提示词更易管理和修订。
在不同平台上,复用参考图的具体机制差异较大。Midjourney的--cref(Character Reference)参数允许直接指定角色参考图,并通过--cw(character weight)调节其影响强度;Stable Diffusion生态中常用IP-Adapter或InstantID等插件,将参考人脸编码后与文本提示词联合控制生成;Runway、Kling等视频工具则通常在项目设置中提供"角色图"上传入口。无论使用哪种工具,核心逻辑一致:参考图的分辨率越高、面部细节越清晰、角度越正面,模型提取的特征越稳定,后续场景的一致性也越好。因此在参考图阶段多花时间打磨,是整个工作流中性价比最高的投入。
第五步到第六步:规划连贯性与善用图生视频
角色一致性不只关乎外观,场景之间也必须逻辑自洽。生成视频片段前,先做一个简单的分镜表或镜头清单,标明每个场景的动作、镜头类型和连贯性细节——比如Emma始终带着那只棕色包,服装和发型在相邻镜头间保持一致。
注意转场细节。 如果一个场景结尾Emma右手拿着咖啡杯,下一个场景不应在没有动作解释的情况下突然变成左手。对复杂制作,建议维护一张连贯性表,记录每个镜头的末帧、角色位置、服装、道具、光线和预期动作。
当工作流支持**图生视频(image-to-video)**时,它是控制角色外观的实用手段。实用流程是:创建并批准参考图→生成将角色置入目标环境的场景图→审查面孔、服装、姿态与构图→以批准的场景图作为视频生成起点→描述运动、镜头移动和环境变化→审查成片是否出现视觉漂移。不过图生视频并不能消除所有不一致,快速运动、复杂互动、长片段和极端镜头变化仍会影响外观。对困难镜头,更短、动作更简单的片段往往更容易控制。
图生视频(Image-to-Video,I2V)与文生视频(Text-to-Video,T2V)在角色一致性上有本质区别。T2V每次生成都从文本重新构建画面,角色外观依赖提示词的语义稳定性;而I2V以一张已批准的图像作为第一帧,视频生成过程在像素层面受到该帧的强约束,面部结构、发色、服装等低层纹理特征得以延续。这也是为什么I2V在角色一致性上普遍优于T2V。实际制作中,常见做法是先用文生图工具产出每个场景的"关键帧"并逐一审核,再以这些关键帧驱动I2V生成动态片段,最后将片段剪辑拼接成完整视频——这种"图像桥接"策略可以把跨镜头的一致性问题,分解为更可控的逐帧检查问题。
第七步到第八步:保持一致但避免千篇一律与逐场审查
一个常见误区是在每个提示词里重复所有视觉细节,却忽视场景本身的目的。一致性不意味着全片使用相同的镜头角度、背景、表情和光线。正确做法是保持角色身份,同时让视觉叙事自然演进:用特写捕捉情绪、用远景交代环境、用跟拍展示行走、用侧脸表现对话、用光线变化暗示时间推移。关键是区分"有意的创意变化"与"不想要的角色漂移"。
不要等整片完成才检查一致性。应逐个场景对照批准的参考图审查,核对清单包括:面孔是否仍可辨识、眼睛发色发型是否一致、标志性特征是否可见、服装是否符合连贯性计划、身体比例是否合理一致、运动是否自然、道具配饰在场景间是否正确传递、片段是否与前一场景逻辑衔接。发现不一致时,先定位成因再重新生成——面孔变了就强化参考图指令或换用身份保留更好的工作流,服装变了就简化描述并显式指定批准的穿搭,动作不自然就降低复杂度并缩短片段。有针对性的修正往往比重写整条提示词更高效。
需要避开的常见错误
原文总结了六个高频错误,值得作为检查表反复对照:
- 场景间更改角色描述——哪怕微小的措辞变化也会诱发不同解读。应维护单一已批准档案并一致复用。
- 仅依赖文本——详细描述有用,但文本本身难以可靠地在每次生成中复现同一张脸。应在可用时使用参考图或其他身份保留控制。
- 一次改动过多变量——同时改变角色、服装、镜头、光线和动作,会让问题难以归因。应保持身份相关变量稳定,只改下一场景所需的元素。
- 过早生成冗长复杂的镜头——先测试简单动作,再逐步构建复杂场景。
- 忽略起始帧与结束帧——单看每段都尚可,但可能无法流畅衔接,组装前要审查场景边界与视觉连续性。
- 期待任何模型都能完美一致——不同模型各有所长,正式投产前先用几个代表性场景测试。
写在最后
跨场景创建一致的AI角色,需要规划、参考图、结构化提示词和细致审查的组合。先定义角色的固定视觉特征,创建高质量参考图并尽可能复用,将角色身份与场景指令分离,规划镜头间的连贯性,组装前逐一审查片段。
最重要的一点是:没有任何单一提示词能保证完美一致。不同的模型和场景会产生不同结果,因此一套可重复的工作流远比单纯依赖措辞更可靠。有了组织良好的角色档案和稳定的生成流程,你就能为叙事、营销、社媒和创意项目产出更连贯的AI视频。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。