AI接单实战:5个爬虫逆向小业务需求拆解

AI工具将爬虫逆向小单开发周期从数小时压缩至十几分钟,5个真实案例展示了务实接单思路。
B站UP主老张通过5个报价300-500元的真实爬虫接单需求,展示了AI大模型如何将原本需要数小时的逆向开发工作压缩至十几分钟。五个案例涵盖加密参数逆向(encrypted/request data)、新闻数据采集、酒店多维度房价采集、批量文件下载和sign参数逆向,技术难度从基础到中等不等。核心方法论是:用AI快速生成采集代码、定位关键接口参数,将精力集中于验证业务结果而非手写全部逻辑。老张特别强调务实解题思维——文件下载需求无需死磕无效链接,而应寻找数据的替代获取通道。文章同时提示,AI降低门槛也意味着小单竞争加剧,且涉及身份证查询等场景需关注数据合规边界。
AI重塑爬虫逆向接单的门槛
传统的爬虫逆向开发,往往需要开发者对JavaScript加密逻辑、参数签名、验证码识别等有深入理解,一个需求做下来动辄数小时。而借助大模型辅助编程工具,这类小业务单的处理效率被大幅压缩。B站UP主James(老张)在最新分享中演示了5个真实接单需求,并坦言每个需求的实际耗时「撑死不过十来分钟」。
这背后的逻辑值得关注:当AI能够快速生成可用的采集代码、分析接口参数时,接单者无需从零手写逆向脚本,而是把精力放在定位核心加密参数、验证业务结果上。这意味着爬虫逆向这个原本偏硬核的技术方向,正在被AI工具显著降低上手门槛。
五个真实需求的技术拆解
需求一:从业人员信息查询(加密参数逆向)
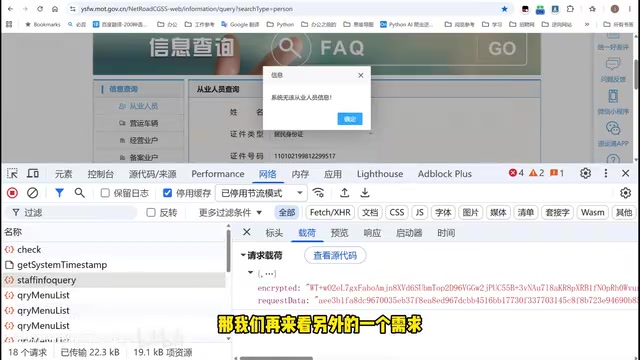
第一个需求是针对某从业人员信息查询系统的采集。用户输入随机生成的身份证号与姓名后查询,系统返回从业人员信息。老张指出,这个需求的核心难点就落在两个接口参数上——encrypted 和 request data。只要把这两个参数的生成逻辑解决掉,整个采集就能跑通。
附带的验证码环节难度不高,可以选择手动过掉,也可以尝试用代码自动识别。老张建议有能力的接单者把验证码一并解决,因为「验证码的价格也不是很贵,但自己能弄出来还是挺不错的」——言下之意,附加能力能提升单价与竞争力。
所谓「加密参数逆向」,本质是还原网站前端JavaScript代码对请求参数的加密过程。现代Web应用为防止接口被滥用,通常会在发送请求前对关键参数进行加密处理——例如用AES/RSA算法加密请求体,或对时间戳、随机数、用户ID等拼接后计算MD5/SHA哈希作为签名(sign)。逆向工程师需要在浏览器开发者工具中抓包,找到加密逻辑所在的JS文件,再通过断点调试或AST反混淆等手段还原出加密算法及密钥,最终用Python等语言重新实现这段逻辑,让采集脚本能生成合法的请求参数。encrypted 和 request data 两个参数正是这一场景的典型代表——前者通常是加密后的请求体,后者可能是包含签名信息的元数据对象。大模型在此环节的价值在于:将抠出的混淆JS代码片段输入后,能快速推断加密方式并生成对应的Python实现,省去了人工逐行分析的时间。
需求二:香港江苏企业协会新闻数据采集
第二个需求相对基础,属于纯数据采集类型。目标是抓取香港江苏企业协会的协会新闻页面——需要逐条点进详情页,把每条新闻的完整信息(标题、发布时间、正文内容等,长短不一)全部抓取下来,并整理汇总到一个文件中。
老张展示了用AI生成的代码,整体代码量不多,且由AI自动完成了从抓取到整合文档的全流程。这类需求没有加密对抗,核心是列表翻页与详情页解析,是AI辅助采集最容易出效果的典型场景。
带业务逻辑的采集:酒店价格数据
需求三:酒店房价多维度采集(报价300元)
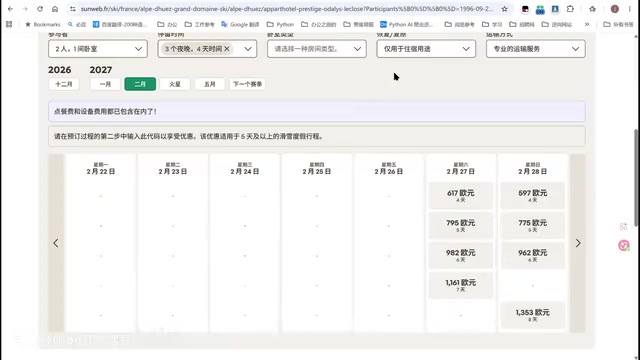
酒店需求的报价为300元,目标是采集某酒店网站在不同条件下的房价数据。这个需求的技术难度本身不高,但业务逻辑需要特别留意。
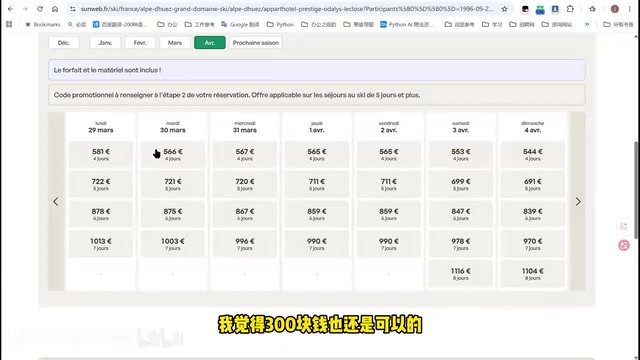
老张特别提醒了几个入住条件的约束:成人数量会影响房间能否成立(单人似乎无法下单,需要满足两人才能入住一个房间);此外还涉及儿童(child)与婴儿(baby)的人数搭配、每个房间的最大入住人数限制。采集目标通常是某个月份内不同入住天数对应的价格组合。
这类需求如果用传统编程方式处理,由于涉及日期、人数等多参数组合与页面交互,会有一定难度;但结合AI生成代码,可以快速覆盖这些组合逻辑。对于看不懂的外文页面,老张建议直接用浏览器翻译辅助理解需求细节。
文件下载与「取巧」思维
需求四:批量文件下载(报价500元)
第四个需求报价500元,表面是文件下载——网站上有文件下载入口,但直接点击下载链接是无效的(链接拿不到)。客户的真实诉求是:不想手动点击,希望代码运行后自动把所有数据/文件整理下来。
老张在这里抛出了一个重要观点:解决需求时不要「为技术而技术」。很多人习惯死磕最硬核的逆向路径,但在实际业务或接单场景中,「能解决问题才是核心」。他暗示这个需求存在一个「取巧」的实现路径——不必非得破解那个点不动的下载链接,而是找到数据的另一条获取通道。这种务实的解题思路,恰恰是接单者比纯技术研究者更需要具备的能力。
需求五:reData网站参数逆向(报价400元)
最后一个是reData网站的采集需求,报价400元。核心参数是 content 和 sign 两个。老张坦言该网站近期做了调整,参数的查找方式比以前复杂了一些,不像过去那样容易定位,但报价并未明显上涨。这类需求同样可以尝试直接用大模型辅助完成逆向分析。
sign 参数是爬虫逆向中最常见的接口鉴权机制之一,全称为「数字签名」(Signature)。其典型生成方式是:将请求参数按照特定规则排序拼接成字符串,加上服务器颁发的密钥(secret key)或时间戳,再经过MD5、HMAC-SHA256等哈希算法计算得出一串固定长度的字符串附在请求中。服务端收到请求后用同样算法重新计算并比对,若不一致则拒绝响应。content 参数则通常指被加密或编码后的请求内容体。网站「做了调整」往往意味着密钥获取方式变化、参数拼接顺序改变,或在原有算法外增加了JS混淆层,使得定位入口函数的难度上升。这也解释了为何此类逆向工作具有持续性维护成本——网站反爬策略迭代后,已有脚本可能随时失效,需要重新分析。
从演示看AI辅助逆向的真实价值
老张在整个演示中反复强调一点:他全程使用大模型工具生成代码,「没必要自己从零用原生方式去试」。生成的结果结构清晰、可直接使用。这反映出当前AI编程工具在特定垂直任务上的成熟度——对于参数定位明确、逻辑不算极端复杂的爬虫需求,AI能把开发周期从数小时压缩到十几分钟。
不过需要清醒看待几点。其一,这些单的报价普遍在300-500元区间,属于「小业务单」,AI降低了交付成本但也意味着单价竞争会更激烈。其二,视频以演示和「评论区扣666领资料」为主要形式,真正的参数逆向细节(如 sign 如何生成、下载链接的取巧具体方法)并未完整展开,更多是指明方向、留给学习者自行实现。其三,涉及身份证信息查询、企业数据采集等场景,需要留意数据来源的合规边界。
对想入门爬虫逆向接单的开发者而言,这类拆解的真正价值不在于「拿现成答案」,而在于建立一种务实的解题框架:先定位核心参数或数据通道,再用AI快速验证可行性,最后聚焦交付结果而非炫技。正如老张所说,「自己实现了才能够真正掌握,才能用到实战里面」。
数据合规是爬虫业务中不可忽视的法律边界。在中国法律框架下,《数据安全法》《个人信息保护法》及《网络安全法》均对个人信息的收集、处理有明确约束。身份证号码属于个人敏感信息,未经授权批量查询或存储存在法律风险;企业信息的公开程度各异,从官方登记系统抓取的数据若用于商业用途同样需关注授权来源。此外,《反不正当竞争法》及部分平台的服务条款也对自动化数据采集有限制性规定。接单者在承接此类需求时,除技术可行性外,还应评估需求方的数据用途、目标网站的授权状态以及自身的潜在连带责任,「能跑通」与「合法合规地跑通」之间存在本质差异。
相关推荐
OpenAI DevDay爆料:神秘智能体"o"与超高速API曝光
OpenAI DevDay前夕爆料汇总:神秘全天候智能体"o"曝光,支持63种语言并针对长周期任务设计;超高速API扩容在即;同时Anthropic Sonnet 5.5与MiniMax M3.1 Flash相继发布,AI行业竞争白热化。

谷歌推出全新Gemini企业智能体:一个提示框搞定所有工作
谷歌在NASA一号机库的Gemini at Work活动上推出全新Gemini企业智能体,一个提示框即可完成问答、知识工作、图像生成和代码运行。本文解析其统一智能体、持久执行、多智能体编排等六大核心架构原则。

Markdown为何成为人机与AI智能体沟通的通用语言
Markdown正成为人机与AI智能体之间的通用信息表示格式。本文解析它为何胜出,以及非结构化数据转Markdown这一关键翻译层对AI应用的意义。