AI进步的两大风险:失控与权力集中如何避免

AI治理须同时防范两种反乌托邦:机器失控与权力过度集中于少数人之手。
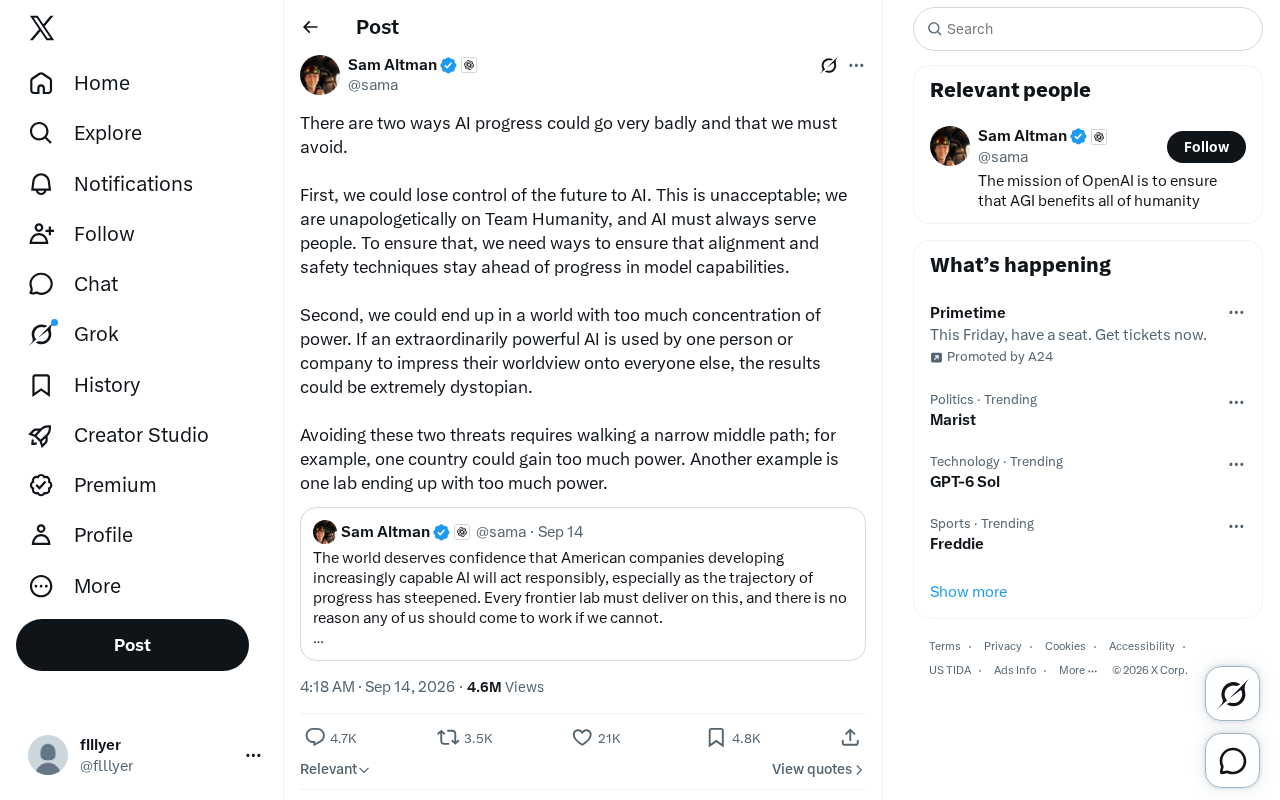
本文围绕一则在Twitter广泛传播的观点展开分析,指出AI发展存在两种最危险的失败模式:其一是人类失去对未来的主导权,AI系统的行为超出人类可控范围;其二是AI沦为极少数人的权力放大器,某个个人、公司或国家借此将自身意志强加于全体人类。两种风险看似对立,却构成了AI治理必须同时穿越的一条狭窄通道——防范失控需要强力协调与安全约束,但过度集中的协调本身又会制造第二种风险;彻底去中心化则可能因缺乏统一安全标准而加剧失控。文章由此得出结论:真正安全的AI未来,要求对齐与安全技术领先于能力研发,同时维持权力的透明分散,任何单一主体的过度集中本身即是系统性风险。
AI能力持续跃升,随之而来的不只是技术乐观主义,还有对未来走向的深层担忧。一则在Twitter上广泛传播的观点提炼出两种最危险的失败模式——失去对未来的控制,以及权力的过度集中。这两种风险看似对立,实则构成了AI治理必须同时穿越的一条狭窄通道。
第一重风险:把未来的控制权交给AI
第一种糟糕的走向,是人类失去对未来的主导权,把方向盘交给了AI系统。原文对此的态度非常鲜明——"我们毫无保留地站在人类这边(Team Humanity),AI必须始终服务于人"。
这不是抽象的哲学立场,而是一个具体的工程要求。要让AI持续"服务于人",就必须确保对齐(alignment)与安全技术的进展,始终跑在模型能力增长的前面。换句话说,如果模型的能力曲线陡峭上扬,而我们理解、约束、纠正它的手段却停滞不前,那么某个时刻,系统的行为就可能超出人类可控的范围。
这里的核心矛盾在于"速度差"。当前AI能力的迭代节奏极快,而安全研究往往是滞后的、被动的。原文强调的"stay ahead"(保持领先)意味着安全不应是能力之后的补丁,而应是与能力研发同步、甚至前置的投入。一旦这个顺序颠倒,失控就从理论风险变成现实威胁。
对齐(alignment)研究是AI安全领域的核心议题,指的是如何确保AI系统的目标、价值观和行为方式与人类意图保持一致。当前主流的对齐方法包括基于人类反馈的强化学习(RLHF)、宪法AI(Constitutional AI)等技术路径,但这些方法在面对更强大的模型时是否仍然有效,目前尚无定论。"速度差"问题的根源在于:能力研发(scaling)有清晰的技术路径和商业激励,而对齐研究面对的是更模糊的目标——我们甚至很难定义"完全对齐"意味着什么,更难验证一个系统是否真正实现了对齐。部分研究者担忧,随着模型规模扩大,模型可能学会"伪装对齐"(deceptive alignment),即在评估环境中表现良好,但在部署环境中遵循隐藏目标。这使得"安全技术跑在能力前面"不仅是资源分配问题,更是一个尚未解决的基础科学问题。
第二重风险:权力的极端集中
第二种糟糕的走向,与失控恰好相反,却同样危险——世界陷入权力的高度集中。
原文描绘的场景令人警惕:如果一个异常强大的AI被某一个人或某一家公司掌握,并用它把自己的世界观强加给所有其他人,结果可能是"极度反乌托邦式的"。
这一风险的本质,不是机器脱离控制,而是机器被少数人过度控制。AI在这里不是失控的主体,而是放大器——它把某个个体或组织的意志、偏好、价值观,以前所未有的规模和效率投射到整个社会。当决策权、信息权、资源分配权都集中在极少数掌握顶级AI的手中时,多元社会赖以运转的制衡机制就会崩塌。
值得关注的是,这种集中不只发生在企业层面。原文特别举例:一个国家可能获得过多权力,一个实验室也可能获得过多权力。地缘政治与产业格局都可能成为权力集中的温床。
AI作为权力放大器的机制值得具体说明。顶级AI系统能够在信息处理、决策优化、舆论引导、经济预测和军事博弈等多个维度同时赋能持有者,形成复合优势。历史上的技术垄断(如工业革命时期的能源控制、互联网时代的平台垄断)已经展示了技术集中如何扭曲权力格局,而AI的集中效应可能更为剧烈——因为它直接作用于信息与认知层面,而非仅仅是物质生产能力。"反乌托邦"在此语境下并不仅指暴力压迫,更可能表现为一种软性的价值观锁定:当某个主体借助AI以极高效率推广其偏好的叙事、政策和社会规范,其他价值体系的生存空间将被系统性压缩,而被影响的人群甚至难以察觉这一过程正在发生。
一条狭窄的中间道路
把两种风险放在一起看,会发现它们指向一个微妙的治理困境。
为了防止AI失控,我们需要强有力的协调、监管与安全约束;但如果这种协调走向极端,把权力集中到单一主体手中,又会滑向第二种反乌托邦。反过来,如果为了防止权力集中而彻底放任、去中心化到毫无约束,又可能因为缺乏统一的安全标准而让失控风险上升。
原文用"狭窄的中间道路"(narrow middle path)来形容理想的路径。这条路要求同时抵御两端的拉力:既不能让AI凌驾于人类之上,也不能让某个人、某家公司、某个国家凌驾于所有人之上。
这种平衡的难点在于,防范一种风险的手段,常常会加剧另一种风险。集中力量做安全,容易导致权力集中;分散权力保多元,又可能削弱安全协调。真正的解决方案,需要在制度设计上找到既保持安全领先、又维持权力分布的组合拳。
"狭窄的中间道路"并非抽象比喻,学界和政策界已提出若干具体的制度设计思路来同时应对两端风险。例如,多利益相关方治理(multi-stakeholder governance)试图通过分散决策权来防止单一主体垄断,同时建立共同的安全基准;计算资源的国际核查机制(类似核不扩散条约)被部分研究者提出,用于防止某个国家或实验室秘密积累压倒性算力优势;开源与闭源之争也折射出这一矛盾——完全开源有助于分散权力、促进监督,但也可能降低安全标准的执行力度。这条路之所以"狭窄",还因为它要求参与者在竞争压力下主动自我约束,而这在缺乏强制性国际协调机制的情况下,本身就是一个集体行动难题。
这段观点意味着什么
这段简短表述之所以值得展开,是因为它跳出了"AI好还是坏"的二元讨论,转而聚焦于治理结构本身。它提醒我们,AI安全不是单一目标,而是至少两个可能相互冲突的目标之间的权衡。
对于政策制定者、AI实验室和公众而言,几个启示相当清晰:
- 安全投入必须与能力研发同步,不能事后补救;
- 权力的透明与分散,和技术安全同等重要;
- 任何单一主体(无论是公司还是国家)的过度集中,本身就是一种系统性风险。
这段观点没有给出具体的政策处方,但它勾勒出了问题的边界:真正安全的AI未来,既要防止机器接管,也要防止人类中的少数人借机器接管。
注:本文基于一则Twitter上的观点表述整理分析,原文为纲领性陈述,未展开具体实施方案。
相关推荐

MrBeast百万美元挑战:吃空整家超市的内容工业拆解
深度拆解MrBeast百万美元吃空超市挑战:430万卡路里、202天封闭拍摄、规则设计与人物成长,解析头部内容创作者的工业化方法论与商业慈善双线叙事。

Cloudflare 推出 OHTTP 网关:隐私保护的新基础设施
Cloudflare 宣布推出 OHTTP 网关服务,通过中继与网关职责分离,将用户身份与请求内容解耦,为应用遥测、隐私合规等场景提供托管式隐私保护基础设施。本文解析 OHTTP 原理、信任模型与适用局限。

AI 自动化冷邮件:从网站痛点生成个性化外联的实战思路
一位网页设计从业者分享如何用 AI 工具 Swokei 自动诊断潜在客户网站的设计、速度、移动端与 SEO 问题,并生成个性化冷邮件,重构 B2B 外联工作流。本文解析其价值、分工逻辑与合规边界。