AI决策模型:当你的AI应返回概率而非段落

Liquid AI发布不生成文本、单次前向传播返回带概率决策的开源模型d1。
Liquid AI发布d1-3B和d1-omni-600M两款开源权重决策模型,其核心特征是只做决策、不生成文本:给定一个输入状态和一组命名问题,模型在一次前向传播中直接返回带概率的类型化答案(是/否、选项、评分),实现零输出token。这使其在RTX 4090上回答一个问题仅需8毫秒,三个问题21毫秒,适合边缘设备与高频率小决策场景。文章指出概率输出是最大价值,可据此构建置信度路由器:高置信度自动执行、中等转人工或大模型、低置信度升级。适合审核过滤、意图路由、RAG相关性检查、智能体护栏等,不适合开放式文本生成。作者提醒概率需经校准验证。
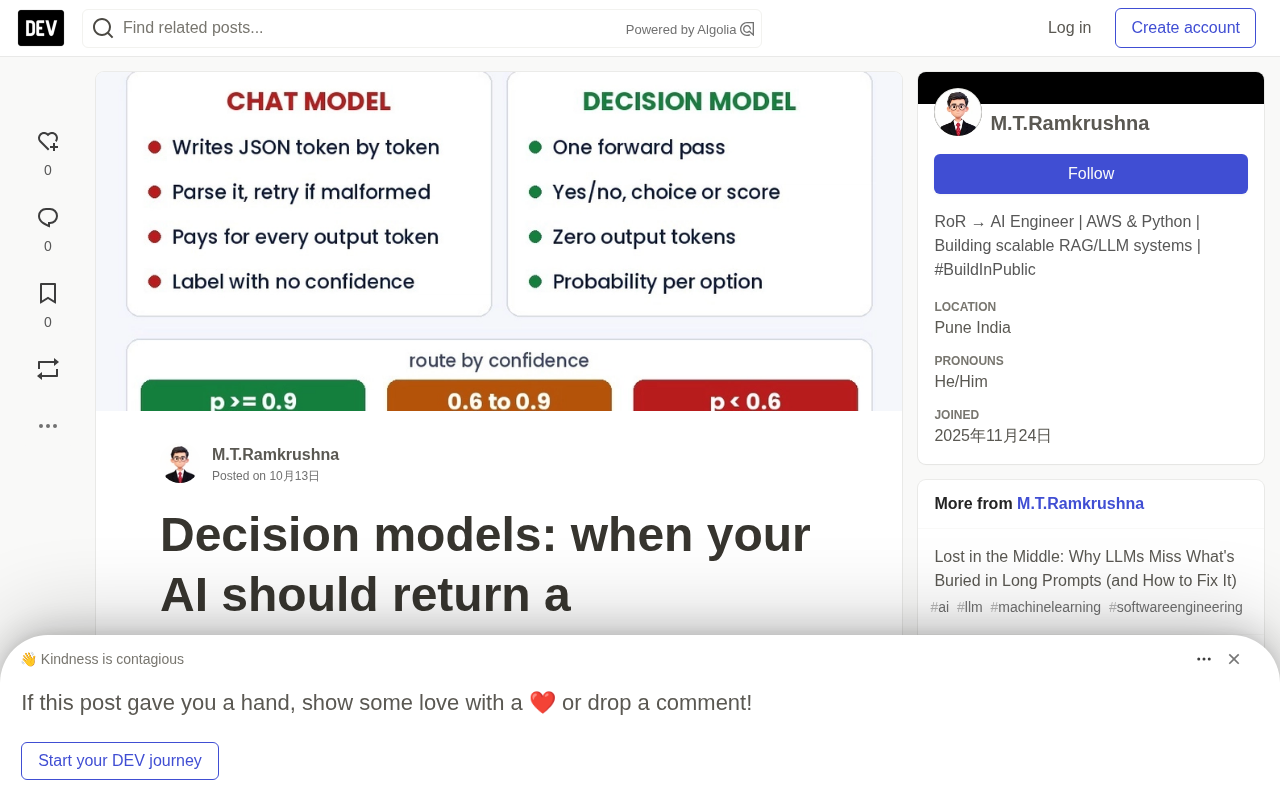
大多数团队处理一张客服工单时,做法几乎一样:把工单丢给聊天模型,用提示词要求它以JSON格式输出分类结果。模型生成几十个token的JSON,你解析它,偶尔因为某个字段多了个尾随空格而重试。这套流程能跑通,但代价被忽略了——你用文本生成器做了三个小决策,为每个输出token付费,等待它们逐个流式输出,最终得到一个标签,却完全不知道模型有多确定。
Liquid AI最近发布了两款围绕不同理念构建的开源权重模型,称为决策模型(decision models)。即便你不使用这两款具体模型,也值得理解它们背后的思路,因为它会改变你对产品中大量LLM调用的认知。
Liquid AI发布了什么
据Liquid AI官方博客和Hugging Face发布帖,其d1系列包含两款开源权重模型:
- d1-3B(约31亿参数),基于LFM2.5-VL-3B视觉语言骨干训练,支持文本和图像输入。
- d1-omni-600M(约5.87亿参数),基于小型双向编码器,增加了视觉和音频编码器。支持文本加图像,或文本加最长30秒音频。Liquid称其为早期研究版本。
关键不在于它们能做什么,而在于它们不做什么。两款模型都不生成文本。你给模型一个输入(称为“状态”)和一组命名问题,它在一次前向传播中返回带概率的类型化答案:带概率的是/否答案、在你定义选项中的选择及对应概率,或你描述的尺度上的评分。MarkTechPost的报道将其概括为“零输出token”,这是最简洁的表述。
为什么一次前向传播很重要
聊天模型的延迟主要来自输出token:生成一个token,反馈回去,再生成下一个。即使是一段简短的JSON答案,也包含数十个串行步骤。而决策模型只读一次输入,直接从最终层读取答案,仅此而已。
据Hugging Face发布帖中Liquid提供的d1-3B数据:在NVIDIA RTX 4090上,回答一个问题仅需8毫秒,三个问题21毫秒;在Jetson AGX Thor上分别为16毫秒和20毫秒;在Jetson AGX Orin 64GB上为26毫秒和35毫秒;在Jetson Orin Nano上为50毫秒和73毫秒。
质量方面,官方报告在七个公开文本基准(阅读理解、毒性检测、意图分类、医学问答和跨语言任务)上平均得分82.9,在其Decision Index v0.2.1公开划分上得分48.57。这些目前是厂商数据,需等独立评测验证。ModelSystem.One指出,其检查的官方索引快照早于这些模型卡。即便如此,结果的核心意义明确:一个3B模型在边缘板上以毫秒级速度作答,没有输出token需要付费或等待。
前向传播(forward pass)指的是神经网络从输入层到输出层完整计算一次、得到结果的过程,与训练时的反向传播相对。自回归语言模型生成N个token,实际上要做N次前向传播:每次都要重新读取全部输入和已生成的token,计算下一token的概率分布,采样后再把新token拼回输入重复。这导致延迟随输出长度线性增长,也正是逐token流式输出的根源。而分类器式模型只需一次前向传播:输入读入一遍,直接从最后一层读出答案分布,无需循环、无需采样、无需把输出写回输入。这正是决策模型能实现毫秒级延迟的根本原因——它的计算量与输入长度线性相关,与“输出长度”无关,因为根本没有输出序列要生成。
决策模型所说的“状态”(state)指模型接收的一次性输入表征,可以是一段文本的编码、一张图像的嵌入,或音频特征的编码,具体取决于骨干模型。与聊天模型把对话历史拼接成提示词不同,状态通常是一个固定维度的向量或张量,经过编码器一次压缩得到。之后每个“问题”都针对同一个状态做一次轻量计算(如一个分类头或一个小型打分模块),这就是为什么三个问题的耗时(21毫秒)并非一个问题的三倍(8毫秒)——状态编码只做一次,多问一个问题的边际成本很低。理解这一点有助于设计用法:把同一份输入上的所有决策打包成一组问题,共享一次编码,是本架构最经济的用法。
在代码中是什么样子
官方示例展示了使用模式。你将问题定义为数据结构,而不是要求JSON的提示词:
from transformers import AutoModel

model = AutoModel.from_pretrained("LiquidAI/d1-3B", trust_remote_code=True)

questions = {
    "refund": {"type": "noul", "instructions": "Is the customer asking for a refund?"},
    "team": {"type": "choice", "instructions": "Which team should handle this?",
             "criteria": {"billing": "Charges, refunds, invoices",
                          "technical": "App or site faults",
                          "fraud": "Suspected unauthorised use"}},
    "urgency": {"type": "score", "instructions": "How urgent is this?",
                "criteria": ["Can wait", "Today", "Blocking the customer now"]},
}

print(model.system_one("I was charged twice this month, please refund one of them.", questions))
注意消失了什么:没有“仅用JSON回复”,没有解析,没有针对格式错误输出的重试循环。输出空间由问题固定,模型无法凭空发明第四个团队。需要transformers>=5.14和trust_remote_code=True,在生产环境运行前应审查模型代码。
真正的优势:可据以行动的概率
聊天模型说"team": "billing"。决策模型大致说“billing 0.91,fraud 0.07,technical 0.02”。这个数字才是最有用的部分,因为它让你能构建置信度路由器:
def route(ticket, decide, escalate):
    result = decide(ticket)              # 快速决策模型,毫秒级
    label, p = result.top()
    if p >= 0.90:
        return label                     # 自动执行
    if p >= 0.60:
        return f"{label} (needs review)" # 排队给人工或更大模型
    return escalate(ticket)              # 困难案例:交给完整LLM
这才是真正值得带走的模式。大多数生产AI系统都有少量这类小规模、高频率决策:是否含有毒性、意图是什么、检索到的段落是否回答了问题、智能体步骤是否应继续、图像是否有缺陷。在小型快速模型上运行它们,对高置信度的直接行动,只把大模型预算花在不确定的长尾上。
一个诚实的提醒:“校准”意味着概率应与现实匹配(它认为0.9的事情应该大约90%正确)。不要盲目相信。在设置阈值前,用你自己的标注数据检查,就像检查任何分类器一样。
校准(calibration)是概率输出能否被信任的关键属性。一个校准良好的模型,当它输出0.9的概率时,这类样本中大约应有90%确实属于该类别。但神经网络普遍存在过度自信倾向:softmax输出的高概率未必反映真实频率,尤其在训练分布之外的输入上,模型可能给出0.99却完全错误。因此文中强调不要盲目设定阈值。实务做法是:收集一批带人工标注的样本,画出可靠性图(预测概率分桶 vs 实际准确率),或计算ECE等指标,据此决定“自动执行”的阈值设在何处。若校准不佳,可考虑温度缩放等后处理,或干脆用阈值+人工抽检兜底。决策模型的概率只有在经过校准验证后,才真正具备路由价值。
适用与不适用场景
适合的场景:
- 每条消息的审核与安全过滤
- 意图和工单路由
- RAG相关性检查(“这段内容回答问题了吗?”)
- 智能体循环中的护栏(“这个工具调用安全吗?”)
- 无网络预算的设备端或边缘检查:视觉检测、机器人、自助终端
不适合的场景:
- 答案需要开放式文本的任务:摘要、草稿、解释
- 选项事先未知的决策
- 需要长时间多步推理的场景
实践注意事项:
- 开源模型使用LFM Open License v1.0,据MarkTechPost报道,年收入低于1000万美元可免费商用。发布前请自行阅读许可证。
- d1-omni-600M明确为早期研究版本,未公布延迟数据。
- 基准为自报数据,音频决策基准在Liquid看来仍是开放问题。
置信度路由器(confidence router)是一种常见的AI系统架构模式:用小而快的模型做前置判断,按输出概率决定后续走自动执行、人工复核还是升级到大模型。它的经济性来自分布的长尾特性——大多数输入其实是简单、常见的,小模型能以高置信度正确处理,只有少数困难样本才需要动用昂贵的大模型。这种设计把大模型预算集中花在真正需要它的地方,同时用概率阈值显式控制准确率与成本的权衡。阈值本身不是固定的,应依据校准结果和业务容忍度调整:安全敏感场景可把自动执行阈值调高,追求吞吐的场景可调低。
更大的图景
业界花了两年时间把所有AI问题都路由到聊天界面,因为前沿模型就是这样的。但我们所谓的许多“LLM功能”实际上只是穿着聊天外衣的分类器。当输出是一个决策时,一个只做决策的模型更快、更便宜、更易验证,并且会告诉你它有多确定。你不需要明天就切换到d1,但值得花一小时列出产品中所有输出实质上是标签、是/否或分数的LLM调用。那份清单里藏着你的延迟和成本节约空间。
参考来源
- Liquid AI官方博客:Open d1, edge decision models for text, vision, and audio
- Hugging Face博客:Multimodal open d1 decision models for the edge
- Liquid AI博客:Introducing d1, the hosted decision model with vision
- MarkTechPost:Liquid AI releases open-weight d1-3B and d1-omni-600M
- ModelSystem.One:Liquid AI ships open d1-3B and d1-omni-600M
你的产品中有多少LLM调用实际上只是一个标签、一个是/否或一个分数?
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。