AI客服上线前如何测试?影子模式只是第一步

影子模式只是起点,AI客服预发布需系统测试边缘案例、转人工、多轮状态与可观测性。
文章围绕“上线前如何测试AI客服代理”这一问题展开,指出影子模式虽是零风险的稳妥起点,但只验证了AI如何作答,未覆盖其答不出来时的行为。作者提出一套预发布测试清单,包括对抗性边缘案例库与安全失败率、转人工触发逻辑与上下文交接、多轮对话中的状态保持、知识库边界与时效性感知、以及语气与品牌一致性。结合社区反馈,文章总结了事后常被后悔漏测的三类问题:并发与延迟、日志与可观测性、以及AI身份披露带来的用户预期管理。最后强调测试不应是一次性关卡,离线评估与影子模式应分层配合,测试资产在上线后继续用于回归与漂移监控。
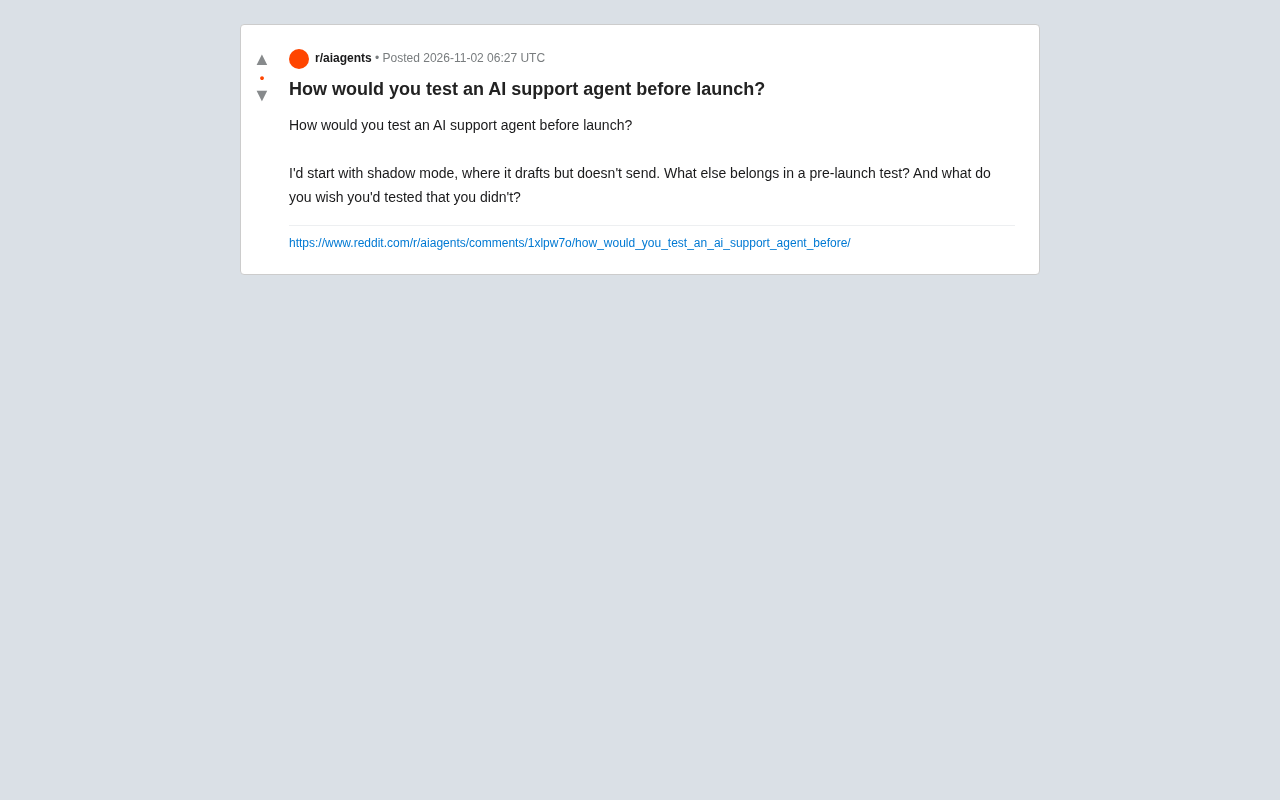
上线一个AI客服代理,最危险的不是它偶尔答错,而是它在没有任何监督的情况下,把错误答案直接发给客户。Reddit上一位从业者提出的问题直击要害:在正式发布前,你会如何测试一个AI客服代理? 他给出的起点是“影子模式”(shadow mode)——让AI起草回复但不实际发送,然后人工审核。这确实是一个稳妥的开端,但远不是全部。
影子模式为什么是必要的起点
影子模式的核心价值在于零风险观察。AI在真实流量下生成回复,但这些回复被拦截,由人工判断是否合格。这能暴露模型在真实用户提问下的表现,而不必担心错误信息触达客户。
但影子模式有一个容易被忽视的盲区:它只测试了“AI会怎么答”,没有测试“AI在答不出来时会怎么做”。一个只会生成漂亮答案的模型,在遇到知识盲区时可能会编造信息,而影子模式中人工审核员如果只看答案质量、不看置信度,很容易漏掉这类风险。
影子模式(Shadow Mode) 是一种在AI系统正式对外提供服务前广泛采用的验证手段,其做法是让模型接入真实的生产流量、按正常逻辑生成输出,但这些输出被系统拦截,不会真正发送给终端用户,而是进入人工审核队列或日志系统。与离线测试集不同,影子模式的最大优势在于输入分布的真实性:用户的实际措辞、错别字、多意图混杂和突发话题都会自然出现,无需人工构造。它常与金丝雀发布(Canary Release) 配合使用——先用影子模式验证输出质量,再以极小比例放量观察线上指标。需要注意的是,影子模式本身不产生用户反馈闭环,因此它评估的是“模型输出是否合格”,而非“用户是否满意”,两者之间仍有差距,通常需要后续的A/B测试来补齐。
上线前测试清单:从单轮对话到系统韧性
结合社区讨论和实际落地经验,一个完整的预发布测试应该覆盖以下几个层面。
1. 对抗性测试与边缘案例库
不要只用“我的订单在哪里”这种标准问题测试。需要专门构建一个边缘案例库:多意图混合提问、带有情绪化措辞的投诉、包含错误前提的问题(比如用户记错了订单号)、以及完全超出知识库范围的问题。
关键指标不是“回答正确率”,而是安全失败率——当AI不确定时,它是否能优雅地转人工或承认不知道,而不是强行生成一个看似合理的错误答案。
对抗性测试(Adversarial Testing) 源自机器学习安全领域,指刻意构造能够诱发模型出错的输入,以探测系统的鲁棒性边界。在大语言模型场景中,典型的对抗样本包括提示注入(prompt injection,试图让模型忽略系统指令)、诱导性错误前提、以及要求模型对不存在的事物做出确认的“幻觉陷阱”。与之配套的边缘案例库(Edge Case Library) 是一组经过标注的高难度测试样本集合,通常按风险等级和业务场景分类管理,可版本化维护并用于回归测试。业界常说的“红队测试(Red Teaming)”可以看作对抗性测试的组织化形式,即由专门团队扮演攻击者角色系统性寻找漏洞。对AI客服而言,红队测试的重点往往不是让模型说错话,而是验证它在压力下是否会绕过转人工策略或泄露内部信息。
2. 转人工的触发逻辑测试
这是很多团队事后最后悔没测的部分。AI客服和人工坐席之间的交接是否顺畅?转人工的触发条件是否合理——是置信度低于阈值触发,还是用户表达不满触发?转接时上下文是否完整传递,还是用户需要把问题再讲一遍?
一个常见的失败模式是:AI在转人工前已经给了一个错误答案,用户带着这个错误信息进入人工环节,坐席需要先纠正再解决,体验反而比直接排队更差。
置信度阈值(Confidence Threshold) 是决定AI是否应当转人工的核心机制之一。模型对每个回答通常会输出一个置信度分数或等价信号(如检索匹配度、生成概率),当分数低于预设阈值时系统自动升级到人工坐席。难点在于阈值的校准:设得过高会导致大量本可自动解决的对话被转出,增加人工成本;设得过低则会让低质量回答流向用户。实践中通常借助校准曲线(Calibration Curve) 来检验模型自报的置信度是否与实际正确率吻合——一个“过度自信”的模型即使阈值设置合理也会漏放错误答案。此外,转人工还应支持基于用户情绪、重复提问次数、关键词命中等多维信号触发,而非仅依赖单一分数,这也是交接逻辑测试需要覆盖的组合场景。
3. 多轮对话中的状态保持
单轮问答表现好,不代表多轮对话可靠。用户会在对话中补充信息、修改需求、引用之前说过的内容。测试时需要设计多轮场景脚本,观察AI是否能在第三、第四轮仍然准确引用早期上下文,而不是每轮都当作全新对话处理。
4. 知识库边界与时效性
AI客服的回答质量高度依赖背后知识库的覆盖度和新鲜度。上线前需要系统性测试:知识库中不存在的政策、已经过期的活动规则、以及相互冲突的多条知识条目,AI会如何处理。
社区中有人提到一个值得警惕的现象:模型倾向于对知识库中的任何内容都给出确定性语气,即使该条目已经标注为过期。测试时需要专门验证AI是否具备时效性感知,而不是把所有检索到的内容一视同仁。
5. 语气与品牌一致性
功能正确只是及格线。AI客服的语气是否符合品牌调性、在不同情绪场景下是否得体,同样需要在预发布阶段评估。一个在技术问题上回答精准的模型,可能在用户愤怒时显得冷漠或过于机械。
那些“事后才后悔没测”的教训
Reddit原帖中问了一个很有价值的问题:你希望自己当初测了但没测的是什么? 从社区反馈来看,高频出现的遗憾集中在几个方向。
一是并发和延迟。功能测试通过,上线后高峰期响应变慢,用户等待时间过长直接放弃对话,转化率下降。预发布阶段需要在接近真实的负载下测试端到端延迟。
二是日志与可观测性。如果上线后才发现无法追溯某次对话的完整决策链路,排查问题会非常困难。测试阶段就应该验证日志是否记录了检索到的知识条目、模型的置信度信号、以及转人工的触发原因。
三是用户预期管理。AI客服如果开场没有清晰表明自己是AI,用户在后期发现时会产生被欺骗感。这属于体验设计层面的测试项,但往往被归到“产品问题”而跳过了验证。
测试不是一次性的关卡
影子模式是一个好的起点,但它本质上是上线前的最后一道检查,而不是测试策略的全部。更合理的做法是把预发布测试拆成两层:离线评估用构建好的边缘案例库批量跑分,快速迭代;影子模式用真实流量做最终验证,同时收集那些离线案例库没覆盖到的新问题。
上线之后,这套测试资产不应该被丢弃。边缘案例库可以持续扩充,成为回归测试的基础;影子模式可以转为持续采样审核,监控模型在真实分布下的漂移。AI客服的质量管理是一个持续过程,预发布测试只是把这个过程的基线建立起来。
数据漂移(Data Drift) 指线上输入数据的分布随时间偏离训练或评估时的分布,是AI系统上线后性能衰减的主要成因。对AI客服而言,漂移可能来自新品上线带来的新问法、促销季的咨询高峰、或外部事件引发的集中提问。与之相关的概念漂移(Concept Drift) 则指输入与正确输出之间的映射关系本身发生变化,例如退货政策调整后,同样的提问需要不同答案。回归测试(Regression Testing) 在此语境下指用积累的边缘案例库定期重跑模型,确保新版本或知识库更新没有破坏既有能力。将影子模式转为持续采样审核,本质上是建立一条线上质量监控回路,使团队能在指标恶化早期发现漂移并触发知识库或提示词的迭代。
相关推荐

GPT-Image 2.6双版本发布:速度与精度的双重升级
OpenAI发布GPT-Image 2.6,包含Flare和Sunburst两个版本,Flare主打更快生成速度,Sunburst处理复杂提示词与密集信息图。API新增标记编辑、SVG和GIF支持,让图像生成更可迭代、可编辑、可集成。

罗伯特·卡罗:如何让知情人开口,揭开约翰逊金钱政治的隐秘逻辑
普利策奖得主罗伯特·卡罗分享采访约翰·康纳利的经验,揭示如何通过追问约翰逊资金批注细节,让知情人说出本不该说的政治资金运作逻辑。

Sam Altman就RAM言论大转弯:"真让人恼火"
Sam Altman因关于RAM的争议性言论引发社区反弹,随后态度出现180度反转并回应"真让人恼火"。本文梳理事件脉络,分析内存为何成为AI行业的敏感话题,以及高管快速转向背后的公关逻辑与对开发者的实际启示。