AI可见度仪表盘的SQL:五类指标与陷阱
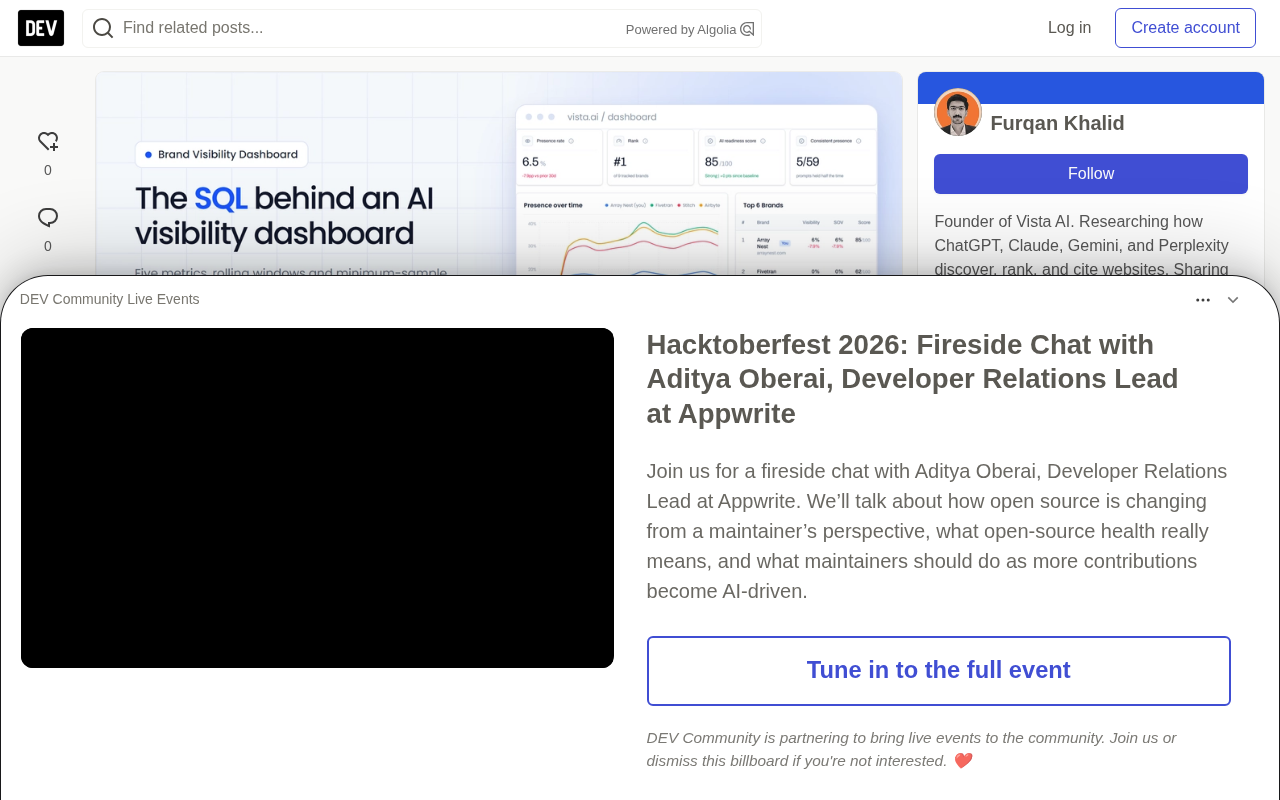
用 SQL 构建 AI 可见度仪表盘的五个核心指标及其对应的数据陷阱与保护措施。
文章围绕 AI 品牌可见度仪表盘,给出了五个基于 SQL 的核心指标:7 天滚动可见度、声量份额、被列出时的平均位置、引用率与提及率差距、以及情感构成。每个指标都配有一段 SQL 代码和具体的陷阱说明,例如对每日百分比取平均会扭曲小样本日、滚动窗口假设每天一行、声量份额受品牌集合变化影响、平均位置可能与可见度反向变动、净情感得分会掩盖中性转向批评等。文章强调每个比率必须带上分母,并通过基础视图固定评分器版本、在图表上标注品牌集合变化、设置最小样本量阈值等保护措施,让仪表盘在会议中经得起质疑。最后给出推荐布局,并讨论自建与购买现成方案的边界。
每天收集大模型回答并为其品牌提及打分之后,总会有人来要仪表盘。也是在这一刻,一堆好数据容易变成误导性的图表。
这类数据的陷阱很特殊:回答是非确定性的,每个提示词的样本量很小,不同引擎差异巨大,竞争对手集合还会变化。原文用 SQL(SQLite 方言,易于迁移)写出了值得放上仪表盘的五个指标,以及让每个指标保持诚实的保护措施。
数据结构沿用该系列前文:prompt、brand、run(一次 API 调用)和 score(每个 run × brand 一行)。
先建一个基础视图
每个指标都从同一个连接开始。把它放进视图里,仪表盘之间就不会漂移:
CREATE VIEW v_scored AS
SELECT r.run_date,
       r.engine,
       r.prompt_id,
       p.intent_stage,
       p.topic,
       b.name   AS brand,
       b.is_ours,
       s.mentioned,
       s.position,
       s.cited,
       s.sentiment
FROM run r
JOIN prompt p ON p.id = r.prompt_id AND p.active = 1
JOIN score  s ON s.run_id = r.id AND s.scorer_version = 'v2'
JOIN brand  b ON b.id = s.brand_id;
把 scorer_version 固定在一个地方,意味着评分器升级只需改一行,而不是在二十个图表查询里到处找。
指标一:可见度与滚动窗口
可见度是提到你的回答占比。每日数值会因为每个提示词每天只有少量样本而剧烈跳动,所以应该画出7 天滚动比率,并在背后淡淡显示每日点。
WITH daily AS (
  SELECT run_date, engine,
         SUM(mentioned) AS k,
         COUNT(*)       AS n
  FROM v_scored
  WHERE is_ours = 1
  GROUP BY run_date, engine
)
SELECT run_date, engine, n,
       1.0 * SUM(k) OVER w / SUM(n) OVER w AS visibility_7d
FROM daily
WINDOW w AS (PARTITION BY engine ORDER BY run_date
             ROWS BETWEEN 6 PRECEDING AND CURRENT ROW)
ORDER BY engine, run_date;
陷阱: 对每日百分比取平均(AVG(k*1.0/n))会让 4 个样本的一天和 40 个样本的一天权重相同。应该像上面那样,把窗口内的分子和分母分别求和。
陷阱: ROWS BETWEEN 6 PRECEDING 假设每天一行。如果采集器跳过了某天,窗口会悄悄拉长到 8 天。如果缺失日期有影响,先和日历表连接。
为什么用窗口函数而不是简单聚合? 窗口函数(Window Function)是在不折叠结果集的前提下,对一组相关行进行计算的特殊 SQL 函数。与 GROUP BY 将多行合并为一行不同,窗口函数保留每一行的明细,同时附加聚合值,因此既能看到每日原始数据,又能看到其上的 7 天滚动结果。ROWS BETWEEN 6 PRECEDING AND CURRENT ROW 定义了一个“滑动帧”,表示每个输出行都引用当前行及之前 6 行的数据。PARTITION BY engine 则先按引擎分区,保证不同引擎的滚动窗口互不干扰。这一机制是仪表盘中“平滑但不丢失细节”的关键,也是避免对每日比率取平均这一经典陷阱的正确解法。
指标二:声量份额
声量份额是你在所有品牌提及中所占的比例,按引擎计算。分母是被追踪品牌的提及,因此只有在竞争对手集合固定时才有意义。
SELECT engine,
       brand,
       SUM(mentioned) AS mentions,
       ROUND(1.0 * SUM(mentioned) /
             SUM(SUM(mentioned)) OVER (PARTITION BY engine), 3) AS sov
FROM v_scored
WHERE run_date >= date('now', '-28 days')
GROUP BY engine, brand
ORDER BY engine, sov DESC;
SUM(SUM(...)) OVER (...) 是在分组结果上开窗:按引擎计算的总提及数,在 GROUP BY 之后计算。
陷阱: 期中加入一个竞争对手会拉低所有人的声量份额。品牌集合变化时应在图表上标注,或者用新集合重算历史数据。
声量份额(Share of Voice, SoV)在 AI 可见度语境下的特殊含义。 传统营销中,SoV 通常指品牌广告投放量占行业总投放量的比例。但在 AI 回答追踪里,分母被重新定义为“所有被追踪品牌在 AI 回答中被提及的总次数”。这意味着 SoV 完全依赖于你所选择追踪的竞争对手集合:追踪 5 个品牌和追踪 20 个品牌,同一品牌的 SoV 会截然不同。因此,SoV 更适合作为相对趋势的观察,而非绝对市场地位的衡量。跨时间对比时,必须确认品牌集合没有变化,否则读者会误以为市场份额发生了波动,而实际上只是分母变了。
指标三:被列出时的平均位置
位置只在回答是列表且你被列入时存在。报告它时必须同时给出它基于的计数,绝不能单独出现。
SELECT engine,
       COUNT(position)                 AS listed_n,
       ROUND(AVG(position), 2)         AS avg_position,
       ROUND(1.0 * SUM(position = 1) / COUNT(position), 3) AS top1_rate
FROM v_scored
WHERE is_ours = 1
  AND run_date >= date('now', '-28 days')
GROUP BY engine
HAVING COUNT(position) >= 20;
陷阱: 平均位置可能在你可见度下降时反而改善。如果你从原本排第五的回答中掉出去,剩下部分的平均值就会上升。这正是为什么这个指标不能在没有指标一陪伴的情况下单独出现在仪表盘上。
HAVING COUNT(position) >= 20 会隐藏那些被列出回答太少、不足以说明问题的引擎。阈值可以自定,但必须有一个。
为什么平均位置是条件统计量? 平均位置只在“被列入列表”这一子集上计算。SQL 中的 AVG(position) 会自动忽略 position 为 NULL 的行,因此这个平均值天然只反映被列出的回答。问题在于,分母(被列出的次数 listed_n)会随可见度变化。当品牌可见度下降时,那些原本排在靠后位置的回答可能不再提及品牌,导致剩余的“被列出”样本整体偏向前列。这就是辛普森悖论(Simpson's Paradox)在指标层面的体现:子集平均值改善,总体却可能在恶化。因此必须同时展示 listed_n,并设置最小样本量阈值。
指标四:引用率与提及率的差距
两条线放在同一张图上。它们之间的差距才是有用信息:
SELECT run_date,
       ROUND(AVG(mentioned), 3) AS mention_rate,
       ROUND(AVG(cited), 3)     AS citation_rate,
       ROUND(1.0 * SUM(mentioned AND NOT cited) / NULLIF(SUM(mentioned), 0), 3)
                                AS mentioned_not_cited
FROM v_scored
WHERE is_ours = 1
GROUP BY run_date
ORDER BY run_date;
mentioned_not_cited 占比高,意味着引擎知道你的品牌,但从别处获取关于你的说法,通常是评测网站、论坛或竞品对比页。这值得关注,因为正是这些第三方页面在塑造对你的描述。
提及与引用为什么是两件不同的事? 在 AI 回答中,“提及”指回答文本里出现了品牌名称,而“引用”指回答明确标注了品牌信息的来源(如链接、参考文献或“根据某某网站”的表述)。一个品牌可能被提及,但支撑其描述的来源却是第三方评测、论坛讨论或竞品对比页。mentioned_not_cited 比率正是量化这种“知道但无官方来源”状态的指标。该比率高,说明 AI 正在用外部叙事定义你的品牌,而这些叙事你无法直接控制。监测这一差距,可以帮助品牌识别哪些第三方页面正在塑造 AI 对自身的描述,从而有针对性地进行内容干预。
指标五:情感构成
如果评分器对每次提及的表述方式做了分类(正面推荐、中性罗列、批评),应该展示构成堆叠比例,而不是一个单一的“情感分”:
SELECT strftime('%Y-%W', run_date) AS week,
       ROUND(AVG(sentiment = 'positive'), 3) AS positive,
       ROUND(AVG(sentiment = 'neutral'),  3) AS neutral,
       ROUND(AVG(sentiment = 'critical'), 3) AS critical,
       COUNT(*) AS n
FROM v_scored
WHERE is_ours = 1 AND mentioned = 1
GROUP BY week
ORDER BY week;
(在 SQLite 中,比较返回 0 或 1,所以 AVG(x = 'y') 就是比例。在 Postgres 中要写 AVG((x = 'y')::int)。)
陷阱: 净得分(正面减批评)会在正面持平、但中性转向批评时掩盖变化。堆叠视图能显示出来。另外,审计分类器:每月抽样 50 条已标注提及并人工核对。基于大模型的情感标签会在标注模型更换时漂移。
能在会议上站得住的仪表盘布局
五个指标,每个都要和让它保持诚实的指标相邻摆放:
- 顶行: 按引擎的可见度(7 天),悬停显示 n。
- 旁边: 按引擎的声量份额,品牌集合变化处加标记。
- 第二行: 平均位置 + 第一名率,旁边给出 listed_n。
- 提及 vs. 引用线放在一张图上。
- 情感用每周堆叠柱展示。
- 下钻到原始回答,每个数字背后都可点击。当有人问“它到底说了什么”,答案应该只差一次点击。
最后一条是这类仪表盘中使用最多的功能,而它之所以可行,是因为采集器存储了原始回答(见数据结构那一篇)。
什么时候停止自建
上面的 SQL 是简单的部分。生产级仪表盘还需要区域细分(回答因国家而异)、面向代理商的多品牌分离、定时邮件报告、骤降告警,以及一个非技术利益相关者真的会打开的界面。
原文提到 Vista AI 的 Brand Visibility Dashboard 把这些打包好了:整体和按引擎的可见度、与竞争对手的声量份额、分为正面/中性/批评的情感、按查询的排名、30 天/90 天/年度趋势、区域细分、每周邮件报告,以及保留每个数字背后完整 AI 回答的原始数据流。
无论自建还是购买,都要保留贯穿上述每个查询的规则:每个比率都要带上它的分母。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。