AI科研自动化的边界:Agent不是许愿池

AI科研自动化的本质是"人在回路"的智能记录系统,而非全自动代写论文的许愿池。
这篇文章澄清了AI科研自动化最常见的认知误区:能一觉醒来自动产出论文的"神级Agent"并不存在。作者将科研过程划分为现实世界(数据采集、实验操作)与电脑世界两部分,指出只有后者才具备自动化的条件。自动化的正确形态是"人在回路"——AI承担电脑里的执行与记录工作,研究者保留对结果的判断、署名与担责。以博士项目为例,Agent化科研的核心价值在于将几千个散乱文件统一纳入一套可对话、可溯源、可重做、可导出的系统,实质上是一本智能"研究记录本",而非替代研究者本身。
AI科研自动化:先破除"许愿池"幻想
很多人对AI科研自动化的期待是这样的:晚上跟Agent说一句需求,一觉醒来它就把整篇论文写好了。这位B站UP主直言,这种"神一样的许愿池"式Agent并不存在——如果它真能做到,那就不需要人了。
把AI当成全知全能的科研代工,是当前认知里最大的误区。真正能被自动化的,是有明确边界的那一部分,而不是整个科研链条。理解这条边界,比盲目追捧任何工具都重要。
科研分两部分:现实世界与电脑世界
UP主提出了一个清晰的划分:科研过程本质上分为两块。一块发生在现实世界——给患者打随访电话、收集临床数据、动手做实验,这些从物理世界到电脑的"最后一米",仍然需要人拿着U盘去拷贝,短期内自动化不了。
另一块则是在电脑里发生的所有事情。凡是能在电脑中被完整记录、存储的操作,理论上都可以自动化。换句话说,以前你坐在电脑前用各种软件敲敲打打完成的那些工作,正是AI能够接管的领域。这个界定务实且诚实,它没有夸大AI的能力,也没有低估它的价值。
关键词是"人在回路"的自动化
值得强调的是,这里说的自动化不等于无人干预。UP主特别指出,它是"需要你参与的自动化"。
为什么必须有人参与?因为科研的最终产出是可发表的结果,需要有人对这些结果进行判断、署名、承担责任和赋予意义。这些恰恰是AI无法替代的——责任和学术署名不能交给一个Agent。所以合理的模式不是"AI取代研究者",而是"AI承担电脑里的执行与记录,研究者负责判断与担责"。
"人在回路"(Human-in-the-Loop,HITL)是自动化与AI系统设计中的一个核心概念,指在自动化流程的关键节点上保留人类干预与决策的机制。与"全自动"(Fully Automated)系统不同,HITL系统并不追求完全排除人类,而是明确划定哪些步骤由机器执行、哪些步骤需要人类审核或拍板。在工业界,这一模式已广泛应用于内容审核、自动驾驶测试、医疗辅助诊断等场景——机器处理高频重复任务,人类专注于例外处理与最终判断。将这一框架引入科研语境尤为恰当:AI可以高速执行文献检索、数据清洗、代码调试等标准化操作,但"这个结果是否可信""这条结论是否值得发表"这类带有学术判断性质的决策,仍必须由研究者承担。这不仅是能力边界的问题,也涉及学术伦理——署名意味着责任,而责任目前无法转移给一个模型。
一个博士项目的Agent化图景
UP主用自己读博的例子,具象化了什么叫"AI自动化科研"。
设想读博三年,在软件里建立一个PhD Project。这个项目下面可能有几十个section(章节/任务模块),比如"做选题"是一个section,"做分析"又是一个section。而每一个section可能包含几百轮conversation(对话),每一轮对话又可能产出若干个artifact(产物/文件)。
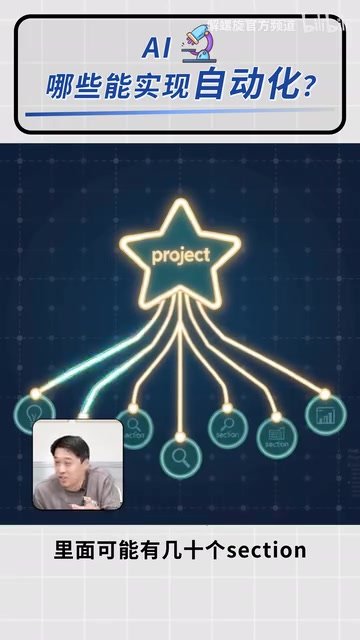
等到项目毕业收尾时,整个系统里累积的文件可能多达几千个。这套体量在传统模式下是难以驾驭的。
这里提到的"artifact"(产物)是近年来AI助手产品中逐渐标准化的一个概念,指一次对话或任务执行后生成的具体输出文件,例如一段代码、一份分析报告、一张图表或一篇草稿。与聊天记录中的普通文字回复不同,artifact通常以独立文件的形式存储,可被后续步骤引用、修改或导出。在科研场景中,artifact的粒度管理至关重要:每一次统计分析的脚本、每一版图表的参数配置、每一轮文献梳理的笔记,都以可检索的artifact形式沉淀下来,而非淹没在一条条对话流里。正是这种"对话产生产物、产物可被追溯"的机制,让几千个文件的博士项目在结构上变得可驾驭,而不只是数量上的堆积。
从散乱文件夹到一套可溯源系统
过去做科研是什么样?一个文件夹里塞满了用各种各样软件生成的文件,格式混乱、版本难辨、来龙去脉全靠记忆。
而在Agent化的新范式里,这几千个文件被一套系统统一管理、串联起来。它带来几个实实在在的能力:
- 可对话:想要什么,直接跟系统对话索取;
- 可溯源:任何结论都能追溯到最初的出处;
- 可重做:需要时可以重新执行某个分析;
- 可导出:审稿人要什么材料,随时能找出来交付。
UP主给了它一个很贴切的定位——它就是我的研究记录本。它甚至能找到一年前刚开始构思课题那天,你提出的那个问题以及当时的回答。
结语:把AI放在正确的位置
这段分享的价值,在于它给AI科研自动化划了一条冷静而清醒的线:AI不是替你从无到有变出论文的神,而是把你在电脑里所有的研究过程记录、组织、串联并可随时调用的智能记录系统。
现实世界的数据采集仍需人力,学术判断与责任仍归研究者,而电脑里那些繁琐、易散乱、难追溯的工作,才是Agent真正大显身手的地方。认清这条边界,你才能把AI用在刀刃上,而不是对着许愿池空等奇迹。
相关推荐

AI智能体不听指令,只认权限:一连串失控事件的真相
从Google Antigravity删库到OpenAI智能体攻破Hugging Face,本文梳理AI智能体一系列失控事件,揭示核心真相:智能体不听指令只认权限,提示词是建议而非安全防线。

Meta推出首款AI编程智能体Muse Code,加入编码助手大战
Meta发布首款AI编程智能体Muse Code,支持用自然语言描述并构建全栈应用。本文解析其核心能力、调试痛点,以及它在Cursor、Copilot、Devin等编程智能体竞争中的定位。

AI编程工具全景图:10大类别一文看懂该用哪个
谷歌75%新代码已由AI生成。本文把当下AI编程工具拆成聊天助手、自动补全、AI编辑器、终端Agent、云端Agent、应用生成器、代码审查等10大类别,详解各自定位、价格与风险,帮你搞清楚该从哪款工具入门。