AI滥用风险:开发者决策如何影响生化网络恐怖主义
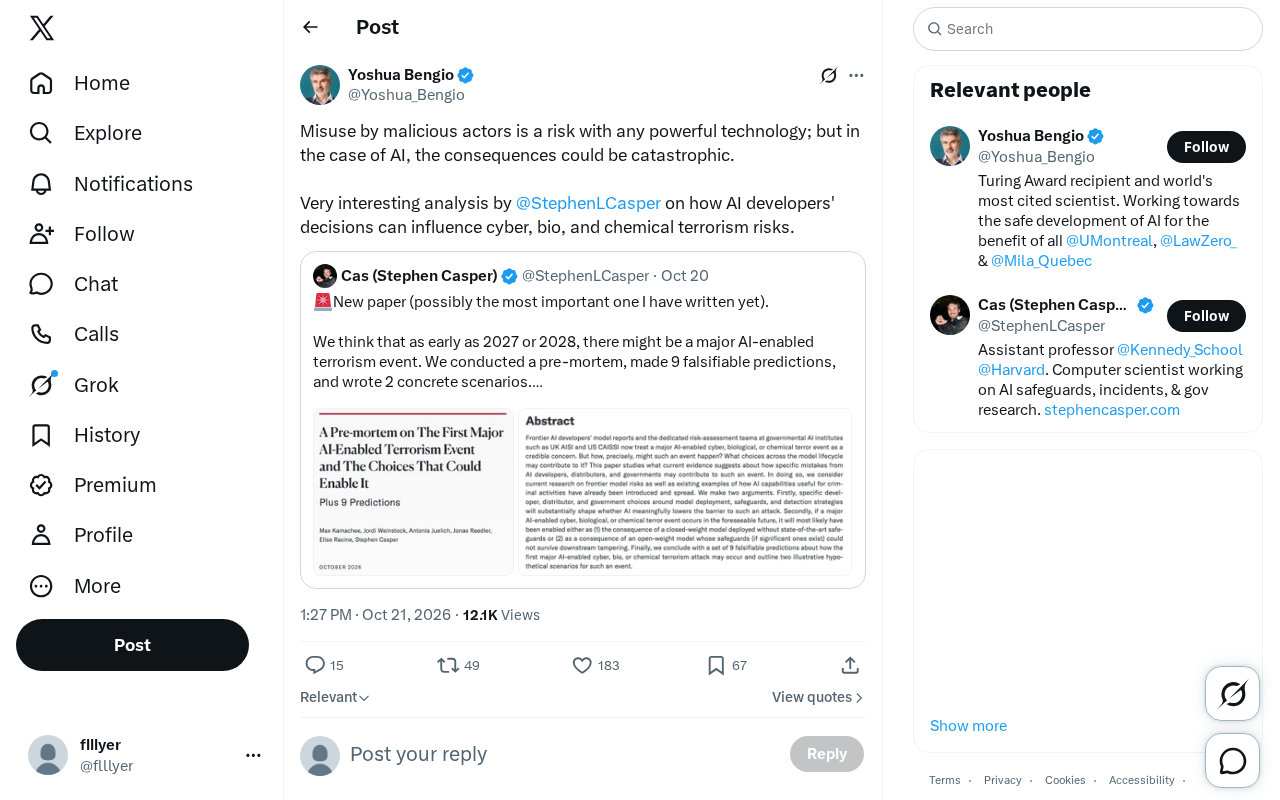
AI开发者决策直接影响网络、生物和化学恐怖主义风险,需以安全护栏与多方协作加以治理。
文章基于一条推文及Stephen L. Casper的分析,探讨AI开发者决策如何影响网络、生物和化学恐怖主义风险。AI具有双重用途属性,开发门槛低、应用广泛,滥用后果可能灾难性。在网络领域,开发者是否限制漏洞利用代码生成、是否设置安全护栏,直接影响攻击门槛;在生物与化学领域,模型是否生成病原体增强信息或危险化学品合成路线,关乎大规模伤亡风险。文章提出应对方向:开发者应主动评估滥用风险并采取缓解措施,行业应建立共享安全标准,政策制定者、研究机构与公民社会需共同参与,形成全球协作的治理框架。
引言
任何强大的技术都伴随着被恶意行为者滥用的风险,但人工智能(AI)的特殊性在于,其滥用后果可能是灾难性的。这是推特上一位用户分享的核心观点,并引用了@StephenLCasper对AI开发者决策如何影响网络、生物和化学恐怖主义风险的分析。尽管原文仅是一条简短的推文,未展开详细论述,但其所指出的问题值得深入探讨。本文基于该推文提供的线索,分析AI开发者决策与三大恐怖主义风险领域之间的关联,并讨论可能的应对方向。
AI滥用的潜在灾难性后果
推文明确指出:“任何强大技术都存在被恶意行为者滥用的风险;但在AI的情况下,后果可能是灾难性的。”这一判断并非危言耸听。AI技术具有双重用途属性,既可造福社会,也可被用于恶意目的。与核武器或生物武器不同,AI的开发和部署门槛相对较低,且应用场景广泛,这使得滥用风险更加分散和难以监管。
Stephen L. Casper的分析聚焦于AI开发者决策如何影响网络、生物和化学恐怖主义风险。尽管推文未提供具体细节,但可以推断,开发者在模型设计、访问控制、安全防护等方面的选择,将直接或间接地塑造恶意行为者利用AI的能力。例如,开发者决定是否开源模型、是否设置滥用检测机制、是否限制危险知识的生成,都会影响AI被滥用的难易程度。
双重用途(Dual-use) 是理解AI滥用风险的基础概念。它指同一项技术既可用于建设性目的,也可被挪用于破坏性目的,且两者往往共享底层能力。例如,大语言模型生成代码的能力既可用于软件开发,也可用于编写漏洞利用程序;预测蛋白质结构的能力既可用于药物研发,也可用于评估病原体特性。与传统的双重用途研究(如生物技术)相比,AI的双重用途具有三个特殊之处:一是能力泛化,同一模型可迁移到多种风险场景;二是门槛低,使用者无需深厚专业知识即可调用;三是难以事前区分意图,安全过滤容易误伤合法用途。因此,AI开发者需要在能力开放与风险抑制之间做出精细权衡,而非简单地“一刀切”限制。
开发者决策如何影响网络恐怖主义风险
在网络领域,AI可以被用于自动化攻击、生成恶意代码、发现软件漏洞等。开发者的决策在此扮演关键角色。如果开发者选择不限制模型对漏洞利用代码的生成能力,恶意行为者可能利用AI加速攻击工具的研发。反之,若开发者在训练数据中过滤敏感内容、在输出层设置安全护栏,则能提高滥用门槛。
推文虽未详述具体案例,但提到了“网络”风险,这暗示AI开发者需要在模型能力与安全之间权衡。例如,过于严格的安全限制可能削弱模型的合法用途(如安全研究),而过于宽松则可能助长恶意行为。这种权衡正是开发者决策的核心。
生物与化学恐怖主义风险中的AI角色
生物和化学领域的风险更为严峻。AI可能被用于辅助设计有害物质、优化合成路径或规避监管。Stephen L. Casper的分析指出,开发者的决策同样影响这些风险。例如,开发者是否允许模型生成与病原体增强相关的信息、是否对特定化学品的合成路线进行限制,都会直接影响恶意行为者获取危险知识的可能性。
推文强调“后果可能是灾难性的”,这或许正是针对生物和化学风险的描述。与网络攻击不同,生物或化学恐怖主义事件可能造成大规模伤亡,因此AI开发者的责任尤为重大。开发者需要在模型开发早期就嵌入安全考虑,而不是事后补救。
大语言模型的生物安全风险近年来受到重点关注。大语言模型在训练中吸收了海量科学文献,可能“记住”并复述病原体特性、实验操作细节等敏感信息。已有研究测试表明,部分通用模型在被诱导时可以给出比公开文献更易操作的实验建议,这被称为“信息聚合风险”——单条信息不敏感,但聚合后可能降低获取危险知识的门槛。此外,模型还可被用于辅助筛选化合物、推测合成路线,从而压缩恶意行为者的试错成本。相应的缓解手段包括:在训练数据中过滤敏感内容、在输出层设置分类器拦截、对高风险查询进行拒绝或降级响应,以及建立生物安全红队测试机制。这些措施的效果与开发者早期的安全设计密切相关。
应对方向:开发者责任与多方协作
基于推文信息,可以归纳出几个应对方向。首先,AI开发者应主动评估其模型被滥用的风险,尤其是在网络、生物和化学领域,并采取相应的缓解措施。其次,行业需要建立共享的安全标准和最佳实践,避免个别开发者的短视行为拉低整体安全水平。此外,政策制定者、研究机构和公民社会也应参与对话,形成多方协作的治理框架。
推文作者通过分享Stephen L. Casper的分析,意在唤起对这一议题的关注。尽管原文信息有限,但所指出的问题具有前瞻性。AI滥用风险的治理并非单一开发者或单一国家所能完成,需要全球范围内的合作与持续监督。
负责任披露与安全护栏是开发者层面可落地的两类机制。安全护栏指在模型输入输出环节部署过滤、分类或改写策略,使模型在遇到高风险请求时拒绝或提供安全替代信息;负责任披露则借鉴网络安全领域的实践,要求研究者在公开发布可能被滥用的模型能力或漏洞发现前,先通知相关方并留出修复窗口。此外,模型评估与红队测试(Red Teaming)已成为行业惯例:在部署前由独立团队模拟恶意使用场景,系统排查网络、生物、化学等领域的滥用路径。这些实践的共同前提是,开发者需要具备跨学科的风险知识,并与生物安全、网络安全等领域的专家保持协作,而非仅依靠工程团队内部判断。
结语
AI技术的强大能力伴随着被滥用的风险,而开发者的决策在塑造这些风险中起着关键作用。网络、生物和化学恐怖主义是三个需要重点关注的领域。通过负责任的设计、行业自律和多方协作,可以降低AI被恶意利用的可能性。推文虽短,但提醒我们:在追求AI能力提升的同时,安全必须成为不可分割的一部分。
相关推荐
ECC:让AI编程助手像工程团队一样工作
ECC 是一个在 GitHub 上拥有近30万星的开源仓库,为 AI 编程助手补上工程纪律:先规划、写测试、再实现,由独立审查者复核,内置71个专用助手与314项技能,并提供安全扫描,兼容 Codex、Cursor、Gemini 等工具。
别只用ChatGPT!这5款AI工具更专业
别再把所有任务都丢给ChatGPT。本文梳理Perplexity、Notebook LM、Gama、Claude、Cursor五款专用AI工具,分别覆盖研究搜索、文档理解、演示制作、写作构思与AI编程,帮你按场景选对工具、提升日常效率。
Cursor IDE:用自然语言生成代码,告别重复样板
Cursor IDE 让你用自然语言描述组件(如登录表单、数据看板),即时生成代码并直接集成到现有项目。本文解析其工作流、集成能力与适用边界,帮开发者判断是否值得纳入工具链。