AI漫剧实战:用视频Agent精准生成指定镜头
视频Agent应能读懂脚本与参考、限定当前镜头、吸收画面反馈,减少从设定到成片的损耗。
文章通过30秒AI漫剧预告《借命灯》第七镜的五秒回头戏,总结了一个好用的视频Agent应具备的三项核心能力:一是将完整脚本、人物图和场景起始图共同作为制作依据,而非仅接收单图加提示词;二是把生成范围限定在当前需要的一镜,实现按需补拍,不必重跑整条片子;三是支持对着画面问题给出具体反馈(保留什么、修正什么),Agent将其整理为下一版镜头草稿。作者同时强调,Agent不替代最终判断,生成结果仍需人工逐版验收。其核心价值在于减少从前期设定到成片之间的信息损耗。
做AI漫剧最头疼的时刻,往往不是剧本卡壳,也不是角色设计,而是所有前期工作都做完了,到了生成这一步,却发现自己得把已经定好的东西再解释一遍。角色外观、场景位置、剧情动机,全都得重新塞给模型,出来的片子动作还可能接不上,想改一处又不知道该从哪句话改起。
这次用视频Agent做30秒漫剧预告《借命灯》的第七镜,五秒钟的回头戏,让我对一个好用的视频Agent该具备什么能力有了很明确的判断:它适合干的活,是接着你已有的素材,把指定的那一镜往下做。具体价值就三条——读懂脚本和参考、把范围限定在当前镜头、根据出来的结果继续改。
第一条:让剧本和参考图真正变成制作依据
很多工具也能传参考图,但传进去和用起来是两回事。这次我的素材是一个完整的30秒预告脚本、主角的人物图、一张起始图交代云桥和店门的位置。要做的第七镜内容是:主角已经走到出口,听见店内的声音,回头这一眼要演出他决定回去反抗的心理转折。
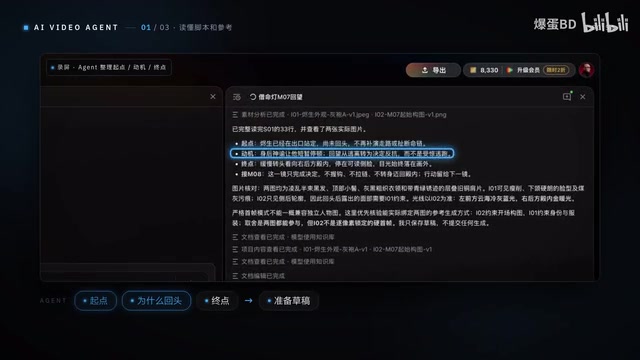
光看“角色有没有转过脸”是不够的。完整脚本交代了他为什么回头,人物图给外观,起始图交代空间关系。视频Agent把这些材料一起读进来,整理出这一镜的起点——他为什么回头,终点在哪——再去准备草稿。
这条解决的是前期设定怎么继续参与后面的镜头制作。创作者不用把已经想清楚的东西再翻译一遍,脚本和参考图本身就是制作依据。这是判断一个视频Agent是否实用的第一个分水岭:它是只接收单张图加一句提示词,还是能消化一套完整的制作材料。
多模态条件输入是视频Agent区别于单图生成工具的关键技术。传统文生视频通常只接受一张首帧图加一段提示词作为输入,模型对场景的空间布局、角色的外观一致性、剧情的上下文都缺乏约束。而视频Agent通过引入脚本(文本)、角色参考图(身份特征)、场景起始图(空间关系)等多种模态条件,在生成前构建一个镜头级的“上下文状态”。这类似于大语言模型中的系统提示与上下文窗口,让模型在生成每一帧时都能对齐已有的制作设定,从而避免角色变脸、空间跳跃、动机断裂等问题。
第二条:只推当前需要的那一镜
做一条片子,有时候就差一个回头、一个表情或者一个衔接动作。角色和场景都定了,要解决的就是这一小段表演。
这次我把范围定在第七镜:人已经站定在门槛上,停一下,再回望。前面怎么走过来的只当上下文,后面握钩那个动作留给下一镜。这一轮就围着这五秒准备草稿、生成,没有去做别的镜头。
对手上已经有素材的人来说,这个限定的好处很实际:缺的那一镜可以先补出来,不用为了一个五秒的镜头重新跑一遍整条片子。视频Agent在这里的角色不是“从零生成”,而是“按需补拍”。它需要理解镜头的边界,知道哪些是上下文、哪些是这次要产出的内容,而不是把整个故事都重做一遍。
镜头级条件生成指模型在生成时只以当前镜头的边界为约束,将前后镜头内容作为不可修改的上下文。这与整片一次性生成不同,它把长视频拆解为多个短片段,每个片段独立生成但共享角色与场景状态。技术实现上,Agent需要维护一个跨镜头的状态记忆,记录角色位置、服装、光照等信息,并在生成当前镜头时仅更新该镜头内的动作。好处是局部修改不会影响全局,创作者可以按需补拍缺失的镜头,而不必为五秒钟的表演重新渲染整条片子。
第三条:改的时候可以直对着画面里的问题说
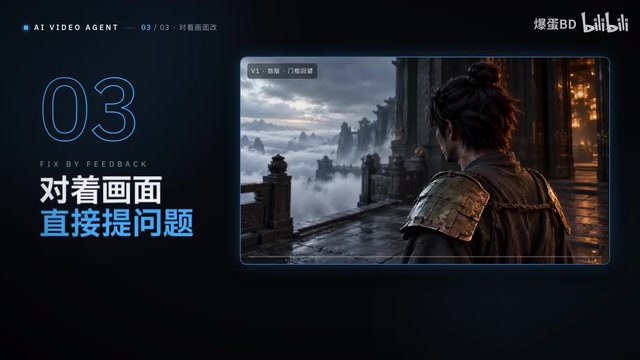
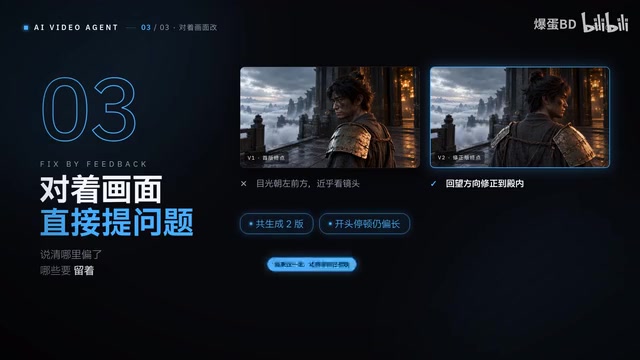
第一版出来后,手板、人物和光线基本都延续下来了,但最后这一眼是朝左前方看的,目光快对上镜头了。我要的是店内回望,没成立。
所以我的反馈写得很具体:人物机位光线全保留,鼻尖和眼睛朝右边的店内,肩膀跟着头一起自然转。Agent拿着这个反馈去准备新版要求,再生成这五秒。
关键是,你只要说清楚哪里偏了、哪些要留着,它把反馈整理成下一版的镜头草稿。第二版回望的方向就修正过来了。这种“对着画面说问题”的交互方式,比反复调提示词更接近真实的导演工作流——看到问题,指出问题,保留对的,改掉错的。
基于视觉反馈的迭代修正是指用户直接用自然语言指出画面中的具体问题(如“目光朝左前”、“鼻尖朝右”),Agent将这些反馈解析为可执行的修改指令,并保留未提及的属性(如机位、光线)。这类似于图像编辑中的inpainting与属性解耦,但更强调语义理解与局部约束的平衡。系统需要区分“保留”与“修正”的指令,将其映射到生成参数或条件向量上,从而在下一版中精准调整目标属性而不破坏其他已对齐的设定。
仍然需要人工验收
这次一共生成两版,开头的停顿还是偏长。结果这一块还是得你自己验收。视频Agent能接住素材、限定范围、吸收反馈,但它不会替你做最终判断。
我的结论是:如果你手上已经有脚本、有角色参考,只差把某一镜落实出来,这个视频Agent值得用在这儿。它能做的三件事——把现有材料接近制作、把任务限定到当前这一镜、再把具体反馈接近下一轮修改——对创作者来说解决的正是这几个麻烦:不用反复整理任务,不用重新解释设定,出片之后也知道该从哪儿接着改。
AI视频工具的价值不在于替代创作者做决定,而在于减少从“我想清楚了”到“它做出来了”之间的损耗。这一次的五秒回头戏说明,这个损耗确实可以压得更低。
相关推荐

Ollama+RAG本地知识库搭建实战:AnythingLLM喂饭教程
基于B站教程整理,详解Ollama+AnythingLLM搭建本地RAG知识库的完整流程:从通用大模型的知识局限、RAG检索增强生成原理,到文档上传、向量化入库与效果验证的实操步骤。

Ollama保姆级教程:本地免费跑大模型入门指南
Ollama是一款开源的本地大模型管理工具,支持免费下载部署DeepSeek等模型,提供命令行和Web UI,跨平台且能自动调度GPU/CPU资源,适合AI开发入门与私有化部署。

给Claude装上"手":Exoproc开源MCP服务器实现活体进程钩子
Exoproc是一个开源MCP服务器,让Claude Code通过线程劫持直接挂钩活跃Windows x64进程,绕过EDR实现动态分析。静态反编译给Claude眼睛,动态钩子给它双手。