AI漫剧制作入门:用豆包+即梦+剪映生成剧本的三种方法
B站零基础AI漫剧教程第一课:用"身份+需求+格式"提示词框架和三种方法高效生成剧本。
本文梳理了一套面向零基础用户的AI视频(漫剧)制作教程的第一模块——剧本生成。教程核心工具为即梦、豆包和剪映,整体流程分七个模块。剧本生成的基础是"提示词三要素框架":角色身份设定、需求描述、格式要求,三者配合能显著提升AI输出的精准度。在此基础上,教程提供三种剧本产出路径:方法一直接输出分镜脚本,速度快但易有逻辑漏洞;方法二先生成完整故事再转脚本,逻辑顺畅,最适合新手;方法三借鉴成熟故事框架做二次创作,效率与质量兼顾,最适合商业接单。三种方法各有取舍,核心思路是通过合理拆解任务、精准约束输出,让AI"听懂你"而非漫无目的地生成内容。
同样的AI工具,为什么有人一发入魂,有人却像脱缰野马般浪费积分?这套B站教程给出的答案是:差距往往不在工具本身,而在于你怎么向AI提问、怎么组织创作流程。本文梳理这套零基础AI漫剧(AI视频)制作教程的第一课——剧本生成,重点讲清楚提示词框架和三种剧本产出方法。
课程用到的工具与整体结构
这套教程主打"简单、免费、易懂",核心工具只有三个:即梦(教程中也称"极梦/吉梦")负责AI图像与视频生成,豆包负责剧本创作,剪映负责剪辑与输出。整个AI视频制作流程被拆成七个模块:剧本、角色设定、图像生成、动态效果、音视频创作、剪映剪辑实操,以及最后的接单与发布。
对零基础用户或急需接单变现的人来说,这种"从新建文件夹到剪辑发布"的完整链路拆解,比单纯讲某个工具的功能更实用。本文聚焦的是第一环——剧本,因为剧本质量直接决定了后续图像和视频生成的成败。
提示词的万能框架:身份、需求、格式
教程反复强调,要写出好剧本,先要学会怎么向AI提问,而提问要围绕三个核心要素。
第一是角色身份设定。给AI贴上专业标签,比如"三年经验的3D电影导演"或"资深治愈系编剧"。身份决定了AI思考的角度和专业深度,你得让它"真的觉得自己是这个角色"。
第二是需求描述。明确创作边界,包括题材、时长、风格、核心元素。描述越具体,AI输出越精准。
第三是格式要求。指定输出格式,比如分镜数量、每镜时长、必须包含的内容,确保结果能直接使用。
教程用了一个直观例子来演示这个框架:"如果你是汽车推销员(身份),请说明人们为什么这么喜欢特斯拉(需求),给出三条主要理由(格式)。"把这段发给豆包,就能得到精准的三条理由。用作者的话说,这就是"是什么、做什么、我怎么做"的通用框架——无论写脚本还是问其他问题都适用,比直接提问全面精确得多。
这套三要素框架在提示词工程(Prompt Engineering)领域有更系统的理论支撑。所谓"角色扮演提示"(Role Prompting)是一种经过大量实验验证的技巧:给大语言模型分配特定专业身份,能显著提升其输出的专业性和一致性,原因在于模型训练数据中不同职业语境下的表达模式存在明显差异,身份标签相当于激活了对应的"知识子空间"。需求描述对应的是"任务约束"(Task Constraints),格式要求则对应"输出规范"(Output Formatting)。三者合并使用的本质,是通过增加信息密度来压缩AI的输出空间——提问越模糊,模型越倾向于输出"统计上最常见"的平庸答案;约束越精准,输出越贴近具体需求。这也解释了为什么同样的AI工具,有经验的用户能快速得到可用素材,而新手却总觉得输出质量参差不齐。
剧本生成的三种方法
掌握提问框架后,教程给出了三种产出剧本的路径,分别对应不同的使用场景。
方法一:直接输出剧本
这是最快速高效的方式,适合紧急需求。做法是先准备参考材料(比如治愈系短篇分镜案例、色彩搭配文档)让AI理解你想要的风格,再用三要素框架一次性写清所有要求,让AI直接产出分镜脚本。
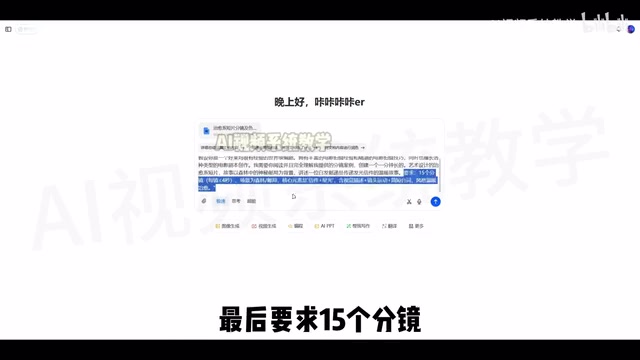
教程演示的提示词是:设定AI为"好莱坞顶级编剧",让它阅读上传的分镜案例,然后创作一个以"森林中的邮局"为背景的治愈系短片,要求15个分镜、每镜小于4秒,包含视觉描述、镜头运动和简短台词。产出的脚本确实包含时长、风格、核心主题、前景镜头、运镜方式、画面描述等信息,这些在后续生成图片和视频时都用得上。
但这个方法有明显弊端:AI直接生成时容易出现逻辑漏洞或难以实现的画面。教程举例说,某个分镜写"信纸紧贴树干瞬间星光沿树皮蔓延",这种场景在实际AI图像/视频生成中很难做出来。
方法二:先生成故事,再转脚本
这被教程称为"最适合小白的方法",优势是逻辑更顺畅。核心思路是把剧本拆成两步,降低难度并保证故事逻辑完整。
第一步先生成一个400到500字、情节闭环、逻辑自洽的完整故事;第二步再基于这个故事转写成包含时长、分镜、运动镜头的脚本格式。
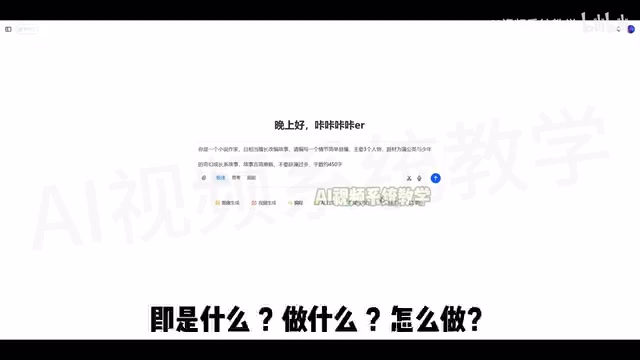
演示中的故事是"阿树10岁那年发现一株不会飞的蒲公英"——蒲公英因害怕离别不肯让种子飞走,阿树也因害怕长大、害怕父母进城而与之"绑在一起",最后阿树用力吹气,学会了"不是留住,而是成全"。教程指出,这种拆分方式生成的故事逻辑通顺、有始有终,明显优于直接生成的脚本模板。
转脚本时有个实用细节:要求"单个分镜不要有景别切换"。因为如果一个分镜里包含3到4个景别,AI就很难准确描述画面。加上这个约束后,每个分镜的画面描述都简单而精准,AI更容易理解要生成什么。
这种"先高层结构,再细化执行"的创作思路,本质上是一种任务分解(Task Decomposition)策略。大语言模型在处理复杂、多约束任务时容易出现"约束遗忘"现象——即在生成较长文本的过程中,早期设定的部分要求会被后续内容稀释。将剧本创作拆成"故事逻辑层"和"分镜格式层"两个独立步骤,每一步的约束数量都大幅减少,模型注意力更集中,输出质量因此更稳定。"单个分镜不切换景别"这个约束也体现了同样的逻辑:景别(远景、中景、近景、特写等)是影视摄影中描述拍摄距离与画面范围的基本单位,一个分镜内频繁切换意味着需要多个连续镜头,AI图像生成工具通常以单张静态画面为单位工作,无法在一次生成中表达多个景别的时间序列,因此约束景别数量是让提示词与工具能力匹配的关键细节。
方法三:借鉴原有框架二次创作
这是教程认为最适合商业接单的方法。通过借鉴成熟的经典故事框架(如"平凡人拯救危机""寻找失落之物""新旧对比"),可以避免AI天马行空,让输出更符合用户需求和市场规律,同时兼顾创意质量与效率。
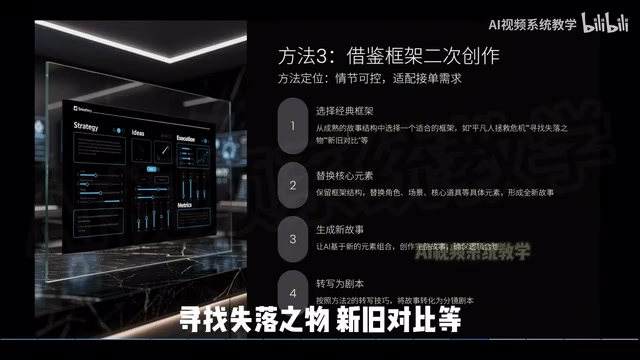
做法是保留故事框架,替换其中的角色、场景、核心道具等元素,再让AI生成新故事并转化为脚本。教程直接把方法二里"阿树与蒲公英"的故事整理成文档,让AI替换核心元素后改写,得到了"小满8岁在老井边发现一只不会游的小鲤鱼"的新故事——框架高度相似,但人物和情节都被替换了。
作者也坦诚指出这个方法的问题:改写后的故事里,"小鲤鱼怕陌生"和"小满怕改变"的核心矛盾,仅靠老奶奶一句话直接点破,缺乏前期铺垫,导致两者的绑定关系显得生硬。这个脚本修订的问题会在后续视频中处理。
三种方法怎么选
把三种方法放在一起看,逻辑其实很清晰:追求速度选方法一,但要接受逻辑漏洞的风险;零基础想稳妥出片选方法二,用"故事—脚本"两步走保证逻辑;接商业单、要控制风险和效率选方法三,用成熟框架做二次创作。
对刚接触AI漫剧的人来说,这套课程的价值不在于工具有多神,而在于把"怎么让AI听懂你"这件事讲透了。身份、需求、格式这个提示词三要素,配合从故事到分镜的拆解流程,是能迁移到其他AI创作场景的通用方法论。剧本只是七个模块的第一步,后续的角色设定、图像生成和剪辑才是最终决定成片质量的环节。
相关推荐
AI早报:千问全模态Qwen3-Omni发布,华为昇腾960与Grok新模型齐现身
9月18日AI早报:千问推出原生全模态模型Qwen3-Omni Flash,音视频成本降超93%;华为披露百万级处理器计算架构并传昇腾960将发布;Grok新版现身谷歌云,OpenAI推ChatGPT for Word,N8N爆满分漏洞。
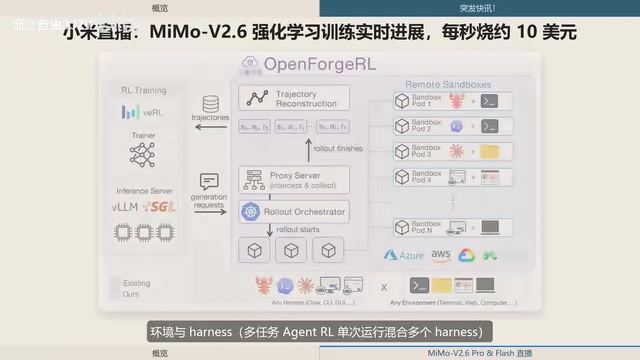
小米MiMo-V2.6直播训练:一天半烧850万,每秒约10美元
小米MiMo大模型团队直播MiMo-V2.6 Pro/Flash的强化学习训练过程,一天半已花费约855万人民币,每秒烧约10美元。本文解析其三方向算力扩展路径、开源计划与DeepSWE基准跑分对比。
字节Trae Work上手指南:11个应用场景解析
字节通用AI agent产品Trae Work上手指南,详解Work、Code、Design三大板块及PPT生成、数据分析、深度研究、代码开发等11个应用场景,帮零代码用户快速判断如何用它解决实际问题。