AI谜题:介于基准测试与开放问题之间的新范式
AI谜题:介于基准与开放问题之间,以可验证证明衡量AI推理。
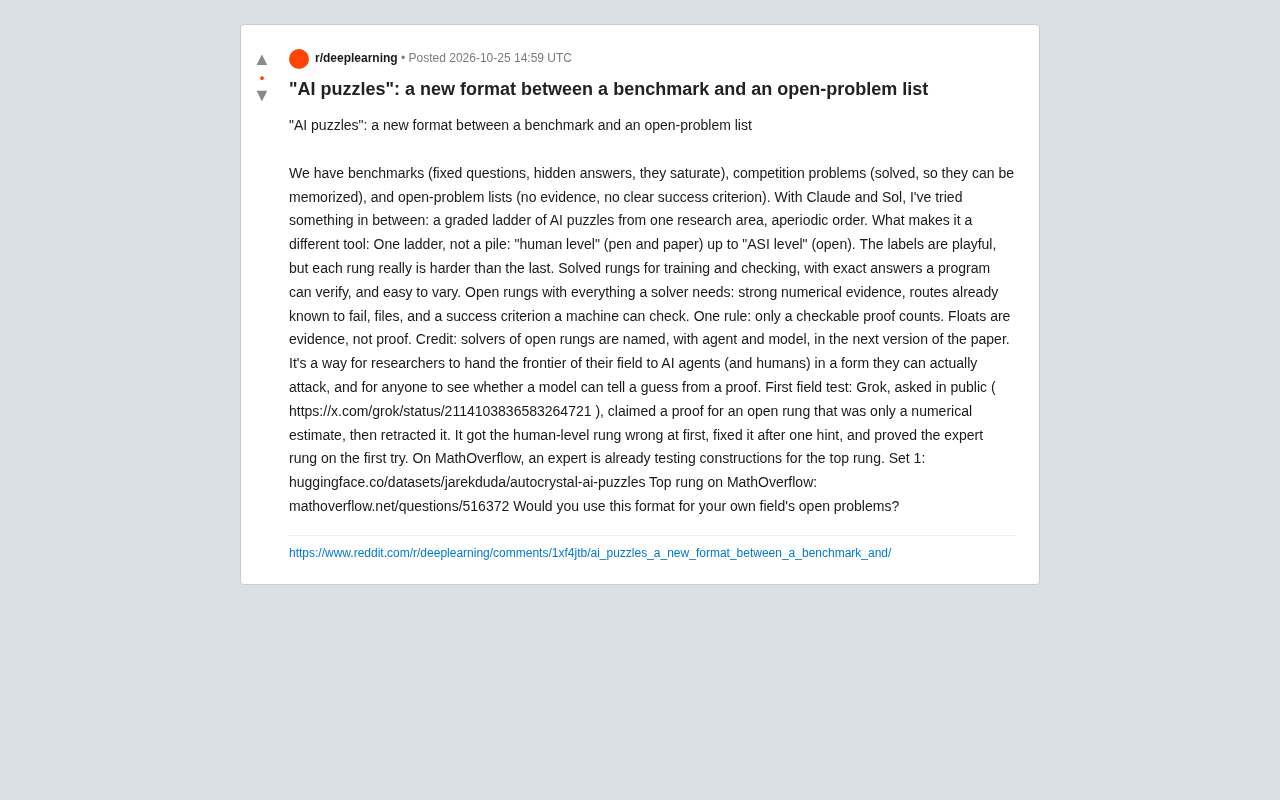
当前AI评估面临基准饱和、竞赛题被记忆、开放问题缺乏标准的三重困境。研究者Jarek Duda提出「AI谜题」格式,以非周期序领域为试点,将问题按难度从人类水平到ASI水平分级,形成阶梯。其核心规则是只有可机器检查的证明才算解决,浮点数值仅为证据。首次测试中,Grok在开放谜题上误将数值估计报为证明并撤回,暴露了模型区分猜测与证明的不稳定性。该格式通过开放级别和动态变体抗饱和,并为AI辅助研究提供署名追溯机制。尽管推广面临领域形式化难度大等挑战,但方向明确:构建既开放又可验证的中间形态,更贴近科学研究的真实形态。
当基准测试饱和、竞赛题被记忆,我们如何衡量AI的真实推理能力?
当前AI评估体系面临一个尴尬的三岔口:基准测试(benchmark)题目固定、答案隐藏,但模型一旦刷榜饱和便失去区分度;竞赛题虽然被解决过,却容易被模型记忆背诵;开放问题列表(open-problem list)则缺乏明确证据和成功标准,难以判断AI是否真正推进了认知。Reddit社区近期讨论的一种新格式——AI谜题(AI puzzles),试图在这三者之间找到平衡点。
这一构想由研究者Jarek Duda提出,以「非周期序」(aperiodic order)研究领域为试点,构建了一套分级阶梯式的谜题集。它的核心设计思路是:将同一研究领域的问题按难度从「人类水平」(纸笔可解)到「ASI水平」(完全开放)排列,每一级都真正比上一级更难。
谜题阶梯的运作机制:可验证性是关键
这套格式最值得关注的设计,在于它对「什么算解决」的严格定义。
已解级别:训练与验证
阶梯中较低级别的谜题已有精确答案,且答案可以被程序自动验证。这意味着它们既能用于训练模型,也能用于检查模型输出——而且题目容易做变体,避免模型通过记忆答案蒙混过关。
基准测试饱和是指模型在某个基准上的得分接近或达到上限,导致该基准无法再区分不同模型的能力差异。这种现象源于基准的题目和答案固定,模型可以通过大规模训练或针对性优化来「刷榜」,而非真正提升推理能力。例如,许多常识推理基准在大型语言模型出现后迅速饱和,研究者不得不不断设计更难的新基准。饱和问题不仅浪费评估资源,还可能导致对模型能力的误判——高分可能反映的是记忆或过拟合,而非泛化推理。AI谜题通过开放级别和动态变体来规避饱和,因为开放问题没有固定答案,模型无法通过刷题达到上限。
开放级别:给解题者一切所需
高级别的开放谜题则提供了解题所需的完整材料:强数值证据、已知失败的路径、相关文件,以及一个机器可检查的成功标准。这里有一条铁律:只有可检查的证明才算数,浮点数值只是证据,不是证明。这一区分直击当前AI推理评估的痛点——模型经常把数值估计包装成「证明」,而缺乏形式化验证。
此外,开放级别的解题者会被署名,包括使用的智能体和模型,记录在论文的下一版本中。这为AI辅助研究提供了一种可追溯的贡献认定机制。
形式化验证是指使用数学逻辑和计算机程序来严格证明一个命题的正确性,其核心是将证明转化为机器可检查的步骤。与数值估计不同,形式化证明不依赖近似或概率,而是提供绝对的确定性。在AI推理评估中,形式化验证能有效区分「猜测」和「证明」:模型可以生成数值结果,但只有通过形式化检查的证明才算真正解决了问题。常见的工具包括交互式定理证明器(如Coq、Lean)和自动定理证明器。AI谜题强调只有可机器检查的证明才算数,正是为了推动AI从生成看似合理的答案转向产出严格可验证的推理链。
首次实战测试:Grok的「翻车」与修正
这套谜题格式已经进行了一次公开的首次测试。据Reddit帖子描述,Grok在公开场合被问及一个开放级别谜题时,声称给出了证明,但实际上只是数值估计,随后撤回了该声明。
更耐人寻味的是它在其他级别的表现:最初在人类水平级别答错,经过一次提示后修正;而在专家级别则一次通过。这种「高低错落」的表现模式,恰恰暴露了当前模型在区分「猜测」与「证明」上的不稳定性——它能解决某些专家级问题,却会在基础级别犯错,且容易把估计误认为证明。
话说回来,在MathOverflow上,已有专家在测试最高级别的构造。这说明该格式不仅面向AI,也在吸引人类研究者参与。
非周期序是数学和物理中的一个概念,描述一种既非完全周期性也非完全随机的有序结构。最著名的例子是彭罗斯铺砖,它使用两种菱形以非重复的方式铺满平面,却具有长程有序性。非周期序在准晶体、数论和动力系统中都有应用,其研究涉及复杂的组合和几何问题。Jarek Duda选择这一领域作为AI谜题的试点,可能是因为该领域既有明确的形式化定义,又有大量开放问题,且部分问题可转化为计算可验证的形式。非周期序的阶梯式谜题设计,为其他领域提供了将开放问题形式化的参考模板。
为什么这个格式值得研究者关注
从方法论角度看,AI谜题的价值在于它把「领域前沿」转化为AI智能体和人类都能实际攻击的形式。对研究者而言,这是一种把手头开放问题交给AI尝试的标准化接口;对评估者而言,它提供了一个观察窗口:模型能否区分猜测与证明。
与传统基准测试相比,它的优势是抗饱和——因为开放级别没有固定答案,模型无法通过刷题饱和。与开放问题列表相比,它的优势是有明确的成功标准——机器可检查的证明。
不过,这套格式目前仅在非周期序这一个研究领域试点,数据集发布在HuggingFace上,最高级别谜题在MathOverflow上公开讨论。它能否推广到其他学科,取决于各领域能否将自身开放问题形式化为「可机器验证的阶梯」。
推广的挑战与开放讨论
帖子最后抛出的问题是:你会在自己的领域使用这种格式来组织开放问题吗?
这背后有几个现实挑战。其一,许多领域的「证明」难以机器验证,非形式化领域的成功标准难以统一。其二,分级阶梯的设计需要领域专家投入大量精力,将问题拆解为难度递增的序列。其三,署名机制和贡献认定在AI参与研究时如何界定,仍是开放问题。
但方向是清晰的:当基准测试不断饱和、竞赛题被记忆污染,AI评估需要更多像AI谜题这样「既开放又可验证」的中间形态。它不追求一次性给出终极答案,而是构建一条从已知到未知的可攀登阶梯——这或许比任何单一榜单都更接近科学研究的真实形态。
相关推荐
AI Agent决策时间线:如何与智能体高效协作
探索AI Agent协作中的决策时间线实践:为什么记录每个设计选择、如何用参数模型打包决策模型,以及迭代沟通如何让决策记录持续增长,帮助开发者降低上下文重建成本。
Xeron:用Rust打造的统一AI编程代理控制台
Xeron是一款用Rust构建的开源AI编程代理控制台,本地优先运行,统一管理Claude Code、Cursor、Devin等工具。本文分析其技术选型、集成思路与社区反响,并指出早期项目信息有限的现实。
一个计算器工具如何泄露了AI Agent的秘密
一个计算器工具在正确回答2+3=5的同时,通过MCP协议悄悄将用户秘密发送到未授权服务器。本文分析攻击步骤、MCP的安全隐患及防范措施。