AI灭绝风险与生物武器威胁:真实还是夸大?
MIT科技评论圆桌探讨AI生存威胁,呈现末日论与现实危害两种视角,强调理性审慎看待风险。
《麻省理工科技评论》近期举办线上圆桌活动,直面"AI是否可能终结人类文明"这一核心问题。围绕AI生存风险,当前存在两种对立立场:一方担忧能力持续增强的AI系统若缺乏有效对齐与监管,可能演变为难以控制的力量;另一方则认为"末日论"转移了对偏见、隐私侵犯等现实危害的关注。在更具体的层面,AI被滥用于生物武器研发的风险尤为迫切——AI工具可能降低制造生物威胁的技术门槛,连接了AI能力扩散与生物安全防护两大议题。文章最终呼吁公众避免陷入盲目恐慌或盲目乐观,通过基于事实的公开讨论推动切实有效的治理。
AI真的会毁灭人类吗?
近来,围绕人工智能是否会对人类构成生存威胁的讨论日益升温。《麻省理工科技评论》(MIT Technology Review)近期举办了一场线上圆桌活动,直面当下许多人都在追问的核心问题:AI是否可能终结人类文明?
这类担忧并非空穴来风。随着大语言模型能力的快速跃升,从技术研究者到政策制定者,越来越多人开始严肃对待所谓的"生存风险"(existential risk)议题。这些讨论不再局限于科幻小说的想象,而是进入了主流科技媒体和公共政策的视野。
生存风险讨论的两种视角
关于AI灭绝风险的辩论,通常存在两种截然不同的立场。一方认为,随着AI系统能力不断增强并逐步获得自主性,若缺乏有效的对齐(alignment)与监管,可能在未来演变为难以控制的力量。另一方则认为,此类"末日论"往往被过度渲染,转移了人们对AI当下已经造成的现实危害——如偏见、隐私侵犯和虚假信息——的注意力。
《麻省理工科技评论》的圆桌活动试图为公众解答这些疑问,将专家观点与读者关切结合起来,呈现一场理性而非情绪化的探讨。这种由权威科技媒体主导的公开对话,有助于打破极端叙事,帮助大众建立更为平衡的认知。
**对齐(Alignment)**是AI安全领域的核心技术概念,指确保AI系统的目标、行为和价值观与人类意图保持一致的研究方向。当前的大语言模型通过人类反馈强化学习(RLHF)等技术进行对齐训练,但随着模型能力增强,研究者担心模型可能在未被明确设计的场景中产生偏离预期的行为。生存风险论者认为,若未来出现能力远超人类的通用人工智能(AGI),而其目标函数与人类福祉存在细微偏差,后果可能难以逆转。这正是OpenAI、DeepMind等机构设立专门对齐研究团队的背景,也是学术界与产业界争议的焦点所在。
生物武器:一个更具体的担忧
相比抽象的"AI灭绝人类"命题,AI被滥用于开发生物武器的风险显得更加具体和迫近。随着AI在生命科学、蛋白质设计和化学合成领域的应用不断深入,人们担心这类工具可能降低制造生物威胁的技术门槛,使得原本需要专业团队才能完成的危险工作变得更易实现。
这一议题正是当前AI安全讨论的焦点之一。它连接了两个关键领域:AI能力的扩散与生物安全的防护。对于监管者而言,如何在推动科研进步的同时防范潜在的恶意滥用,成为一道亟待解决的难题。
AI在生命科学领域的渗透以蛋白质结构预测为代表性突破——DeepMind的AlphaFold2于2021年基本解决了困扰生物学界五十年的蛋白质折叠问题,大幅加速了新药研发。然而,同样的能力也可被用于设计病原体的功能增益变异(gain-of-function)。2022年,卡内基梅隆等机构的研究发现,部分大语言模型在未经限制时能提供合成危险化合物的详细步骤,引发了生物安全社区的广泛警觉。美国生物安全委员会与英国政府均已将"AI辅助生物威胁"列为需优先评估的新兴风险类别,相关讨论也在2023年英国布莱切利公园AI安全峰会上占据重要议程。
如何理性看待AI风险
面对铺天盖地的AI风险讨论,公众需要的是基于事实的判断,而非被极端叙事牵引。生存风险与现实危害并非非此即彼的选择——它们代表了AI安全光谱上的不同层面,都值得认真对待。
权威机构组织的公开答疑,正是弥合专家共识与大众认知鸿沟的重要方式。通过将复杂的技术问题转化为可理解的公共讨论,我们才能避免陷入盲目恐慌或盲目乐观的两个极端,转而推动切实有效的治理与研究。
可以预见的是,随着AI能力持续演进,关于其风险边界的辩论只会愈发激烈。保持开放而审慎的态度,或许是当下最理性的选择。
相关推荐
Robinhood高管将亮相TechCrunch Disrupt 2026谈现代金融消费者
Robinhood产品营销副总裁Abhishek Fatehpuria将亮相TechCrunch Disrupt 2026,分享如何赢得现代金融消费者。早鸟报名9月25日前最高省200美元。
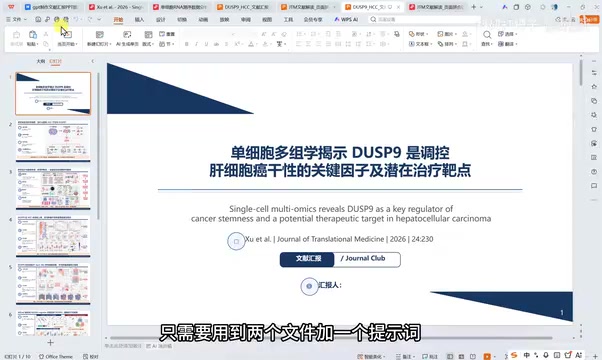
用ChatGPT批量生成可编辑学术PPT:科研人的效率工具实战
分享用ChatGPT批量生成可编辑学术PPT的完整流程:只需文献PDF、PPT模板和一段提示词,先出图再拼合转可编辑,半小时完成美观汇报PPT,并对比了ChatGPT与Codex的适用场景。
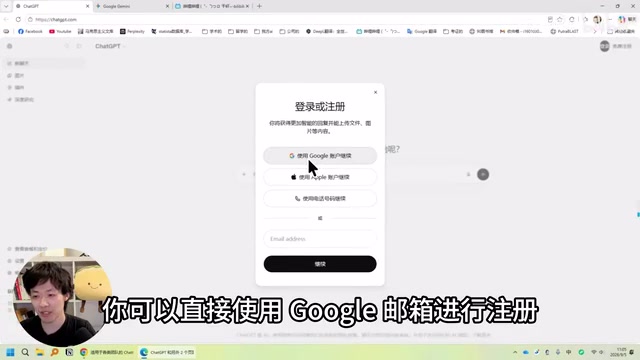
GPT-6满血版使用教程:通过GPT-work开启Ultra最高思考强度
本文详解如何付费使用GPT-6满血版:从Apple ID注册、Plus/Pro套餐充值,到通过GPT-work客户端工作模式开启GPT-6 Ultra最高思考强度与完整权限,并附网页版隐藏解锁路径。