AI理解中文网络评论有多难?语用推理基准测试揭示关键差距

首个中文网络评论语用推理基准揭示:最强AI与人类仍差近10个百分点
这篇arXiv论文构建了首个专门针对中文网络评论语用推理的大规模基准数据集,包含从20万条真实社交媒体互动中精选的4,735个测试项,每项均配有目标评论、还原语境和"合理误读"干扰选项。研究对8个主流大语言模型进行双重评测(既作出题者又作答题者),发现最强模型准确率为81.42%,8模型平均仅68.70%,而人类基准为90.8%,差距近10个百分点。案例分析显示,模型普遍能识别"非字面含义"的存在,却无法精准判断其具体语用机制——究竟是自嘲、讽刺还是玩梗。研究填补了中文社交语用评测的空白,对内容审核、智能客服等实际应用具有重要指导意义。
中文网络评论的语用复杂性为何难倒AI
中文网络评论以独特的间接性和戏谑性著称。一句"你真棒"可能是真诚赞美,也可能是反讽吐槽;"懂了懂了"既可能表示理解,也可能暗示不耐烦。这些高度依赖语境的社交语用(social pragmatics)长期是自然语言处理领域的顽固难题。
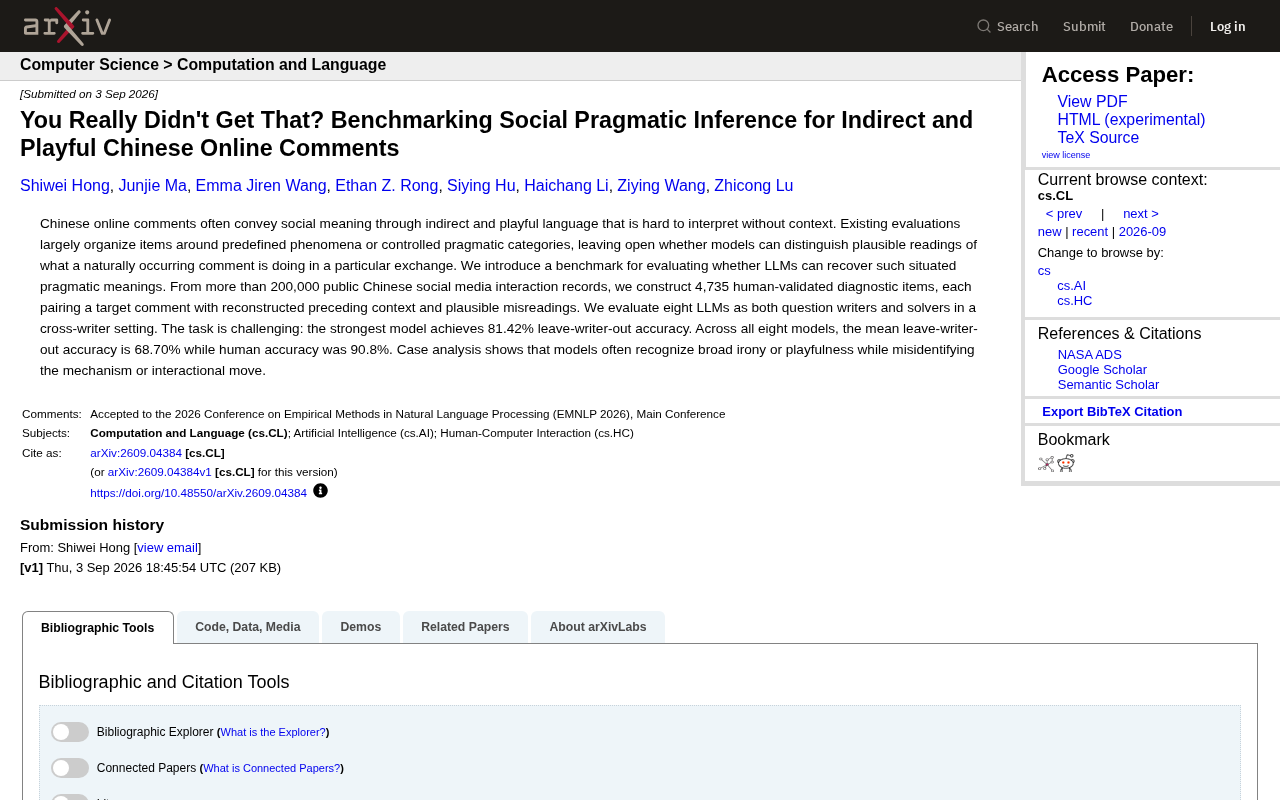
现有的语用理解评测大多聚焦于预定义的语言现象或受控的语用类别,但真实社交场景中的评论往往需要结合上下文才能准确解读交际意图。这篇发表在arXiv的最新研究(arXiv:2609.04384v1)正面回应了这一挑战,构建了首个针对中文网络评论语用推理的大规模基准测试。
数据集构建:从20万条真实互动中精选4735个测试项
研究团队从超过20万条公开的中文社交媒体互动记录中筛选素材,最终构建了包含4,735个经人工验证的诊断性测试项。每个测试项由三部分组成:
- 目标评论:待解读的网络评论
- 重构语境:还原的前置对话上下文
- 合理误读选项:看似说得通但实际错误的理解
这种设计巧妙地模拟了真实场景中的理解陷阱——模型需要在多个看似合理的解读中选出正确答案,而非进行简单的二分类判断。数据全部来源于真实社交互动,保证了测试的生态效度。
评测结果:最强模型与人类仍有近10个百分点差距
研究对8个大语言模型进行了双重评测:既让它们充当出题者生成误导选项,又让它们作为答题者解决问题。在"留一作者交叉验证"(leave-writer-out)设置下,结果颇为耐人寻味:
- 最强模型准确率:81.42%
- 8个模型平均准确率:68.70%
- 人类基准准确率:90.8%
即使是表现最好的模型,与人类仍有近10个百分点的差距。这表明当前大语言模型在理解中文网络语用方面还有显著的提升空间。模型间的表现差异也相当大,平均准确率仅为68.70%,说明这项任务对多数模型而言挑战不小。
典型错误模式:识别出戏谑却误判具体机制
案例分析揭示了模型失败的典型模式:它们往往能识别出评论具有讽刺(irony)或戏谑(playfulness)意味,但在判断具体的语用机制或交际动作时频频出错。
举例来说,模型可能正确判断某评论"不是字面意思",却无法区分这究竟是:
- 善意的自嘲调侃
- 温和的讽刺批评
- 纯粹的玩梗互动
这种"粗粒度正确、细粒度失误"的现象表明,模型缺乏对中文网络文化中微妙社交信号的精准把握。真正的语用理解不仅要识别"言外之意"的存在,更要准确捕捉其性质、强度和交际功能。
这项研究为何重要:填补中文语用评测的关键空白
这项研究的价值体现在多个层面:
学术层面:填补了中文社交语用推理评测的空白,为衡量语言模型的能力边界提供了新的测量维度。不同于以英文为主的现有基准,该数据集聚焦中文网络特有的表达方式。
应用层面:对内容审核、智能客服、社交机器人等实际应用具有重要指导意义。准确理解用户评论的真实意图,是这些系统有效运作的基础。
方法论创新:采用"合理误读"作为干扰项的设计思路,比传统的随机选项更能考察模型的真实理解深度。这种方法也可推广到其他语用现象的评测设计中。
当模型在各类标准任务上不断刷新记录时,这项研究提醒我们:真正理解人类语言——尤其是充满文化特色和社交暗示的网络表达——仍然是人工智能面临的深层挑战。
相关推荐

零基础用WorkBuddy做AI漫剧:技能包保姆级安装教程
零基础如何用WorkBuddy制作AI漫剧?本文详解WorkBuddy安装、Skill技能包导入与调用全流程,附剧本生成实操演示与人工修改技巧,帮你跑通AI漫剧从剧本到分镜的第一步。

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。

PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。