AI能"烘焙"模型几何?免训练权重编辑新探索
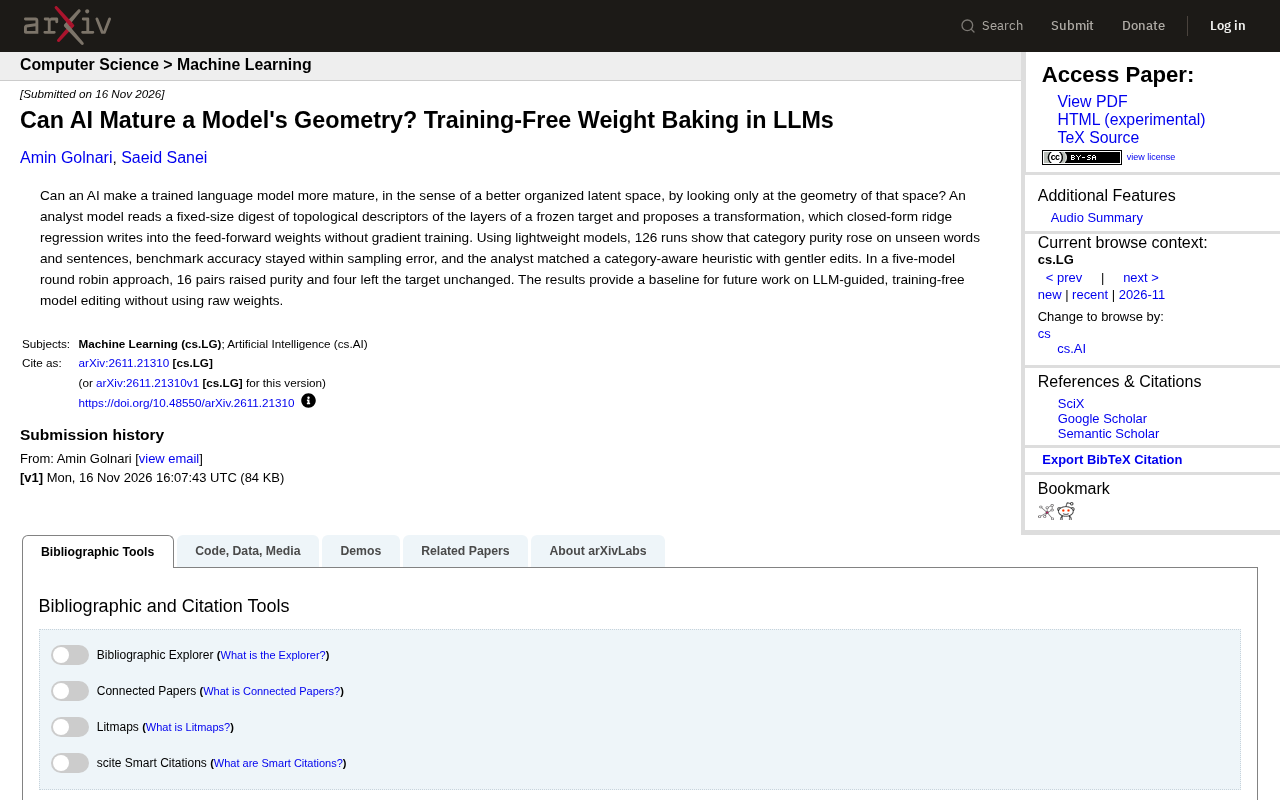
分析师模型仅凭潜空间几何描述符,用闭式岭回归免梯度编辑前馈权重,多数配对提升类别纯度。
该研究提出“权重烘焙”技术:一个分析师模型仅读取冻结目标模型潜空间拓扑描述符的固定长度摘要,提出权重变换方案,再由闭式岭回归将变换直接写入前馈网络权重,全程无需梯度训练或反向传播。在轻量级模型上进行的126次运行显示,类别纯度在未见单词和句子上有所提升,基准准确率保持在采样误差范围内;分析师模型与类别感知启发式效果相当但编辑幅度更温和。五模型轮转实验中,16个配对提升纯度、4对目标保持不变,说明方法在多数配对下有效但存在失效情形。研究为LLM引导、免训练、不接触原始权重的模型编辑提供了可复现基线,但规模限于轻量模型,向大模型扩展及下游收益转化仍是开放问题。
引言:当AI学会"调理"另一个AI的潜空间
大模型编辑通常离不开梯度训练或微调,但一篇来自rss的新研究提出了一个反直觉的思路:让一个"分析师模型"仅通过观察目标模型潜空间的几何结构,就提出权重变换方案,并用闭式岭回归将变换直接写入前馈网络权重——全程无需梯度训练。这项被作者称为"权重烘焙"(weight baking)的技术,试图回答一个根本问题:AI能否让训练好的语言模型在潜空间组织上变得更"成熟"?
方法拆解:几何描述符+闭式回归
研究的核心机制分为两步。第一步,分析师模型读取冻结目标模型各层拓扑描述符的固定长度摘要——它不接触原始权重,只看潜空间的几何"形状"。第二步,分析师提出一种变换,闭式岭回归负责将该变换写入前馈权重,绕过了反向传播。这种设计让模型编辑变得轻量且可解释,因为变换由几何信号驱动,而非黑箱梯度。
据原文描述,实验使用轻量级模型,共进行了126次运行。评估指标包括类别纯度(category purity)和基准准确率。这种"不碰原始权重"的编辑方式,为后续研究提供了一个可复现的基线。
**潜空间(latent space)**指的是模型内部各层激活值构成的高维表示空间。语言模型在处理输入时,每一层都会将token映射为一个高维向量,这些向量的分布、聚类和流形结构共同决定了模型如何区分和泛化概念。所谓“几何结构”,通常指这些向量之间的相对距离、局部邻域关系以及类别簇的紧致程度——类别纯度(category purity)正是衡量同一类别样本在潜空间中是否聚集、不同类别是否分离的指标。几何描述符则是对这种高维结构做降维或统计汇总后得到的固定长度向量,使分析师模型无需接触海量原始激活值即可“感知”目标模型的内部组织状态。
**闭式岭回归(closed-form ridge regression)**是一种不依赖迭代优化的线性求解方法。给定输入特征矩阵和回归目标,岭回归在最小二乘基础上加入L2正则项,其解析解可通过矩阵求逆直接算出,无需梯度下降。在本研究中,分析师模型提出的“变换”被参数化为前馈网络权重的调整量,闭式岭回归负责在给定几何描述符与目标变换之间求出最优线性映射,从而把变换“烘焙”进权重。这种做法的优势是确定性强、计算成本低,且正则项能抑制过大改动,与原文“编辑幅度更温和”的观察直接相关。
实验结果:纯度提升与准确率稳定
126次运行的数据给出了几个关键信号。在未见过的单词和句子上,类别纯度有所上升——这意味着潜空间的类别组织变得更清晰,且这种改善能泛化到训练时未见的样本。同时,基准准确率保持在采样误差范围内,没有出现明显退化。
更有趣的是分析师模型的表现:它与一个类别感知的启发式方法效果相当,但编辑幅度更温和。换言之,AI分析师用更小的改动达到了相近的组织效果,这暗示几何引导的编辑可能比暴力启发式更"精准"。
**类别纯度(category purity)**是聚类分析中的常用指标:对潜空间中每个类别对应的样本簇,计算簇内多数类样本所占比例,再对所有簇取平均。纯度越高,说明同一语义类别的样本在表示空间中越集中在同一区域,不同类别之间的边界越清晰。它不同于分类准确率——纯度衡量的是表示空间的组织质量,而非模型输出预测的正确性。因此原文特别强调“基准准确率保持在采样误差范围内”,意在说明纯度提升并非以牺牲任务性能为代价,而是内部表征变得更有序的同时下游行为保持稳定。
**采样误差(sampling error)**指由于只评估有限样本而非全部数据所带来的统计波动。原文用“保持在采样误差范围内”来描述准确率变化,意味着观察到的准确率差异在统计上不显著,不能归因于编辑操作本身。这一表述方式提示实验规模(126次运行)下准确率指标的置信区间较宽,读者应对“无退化”的结论保持适度谨慎,需更大规模复现才能确认。
五模型循环赛:多数配对纯度提升
研究还设计了一个五模型轮转(round robin)实验,考察模型之间的相互编辑效果。16个配对中,有16对提升了纯度,4对则让目标模型保持不变——原文的表述是"16 pairs raised purity and four left the target unchanged"。这一结果说明编辑效果并非普遍适用,部分配对下分析师未能找到有效的几何变换,但多数情况下纯度改善是可复现的。
提一嘴,素材未披露循环赛的具体模型名称、纯度提升幅度或基准准确率的具体数值,因此只能做定性判断:编辑在多数配对中有效,但存在失效情形。
**轮转实验(round robin)**在此处指让五个模型两两配对、互为分析师与目标模型进行交叉编辑的设计。五个模型可产生$\binom{5}{2}=10$个无序配对,若考虑方向性(A编辑B与B编辑A视为不同),则最多20个有序配对;原文提到16个配对,说明部分方向被省略或未成功执行。这种设计的目的不是追求单次编辑的最优效果,而是检验“几何引导编辑”是否具有跨模型的普适性——即一个分析师模型能否对不同的目标模型都提出有效变换,以及目标模型被不同分析师编辑时结果是否一致。16对提升、4对不变的结果表明该方法存在模型间的兼容性差异,失效配对可能源于分析师模型对目标模型几何描述符的解读偏差,或闭式回归在该配对下求得的变换幅度过小、未触及有效编辑阈值。
意义与边界:免训练编辑的基线
这项工作的价值在于提供了一个"LLM引导、免训练、不使用原始权重"的模型编辑基线。传统微调需要大量算力和数据,而几何引导的闭式编辑在轻量模型上验证了可行性。分析师模型与启发式方法效果相当但改动更温和,这一发现对追求"最小干预"的模型维护场景有参考意义。
不过,研究目前仍停留在轻量模型阶段,126次运行和五模型循环赛的规模有限。几何描述符能否扩展到更大模型、类别纯度的提升是否转化为下游任务收益、循环赛中失效配对的成因,都是原文留给未来工作的开放问题。
结语
让AI通过"看几何"来调理另一个模型的潜空间,这个想法把模型编辑从梯度优化的框架里解放出来。尽管实验规模尚小,它至少证明了一条路径的存在:不碰原始权重,也能让模型的内部组织更有序。
相关推荐

AI代打电话?Muse让语音助手替你预约
Muse推出AI代打电话功能,仅限美国付费订阅用户。本文分析语音助手切入电话场景的产品逻辑、付费墙策略与语音代理的想象空间及隐私隐忧。
谷歌PaperOrchestra:多智能体框架自动化写AI论文
谷歌研究院开源 PaperOrchestra 多智能体框架,将 AI 研究论文写作拆解为文献、方法、实验等子任务,由不同智能体协作编排完成,GitHub 已获 2093 星,今日新增 313 星。

Marimba:0.6B小模型如何用单一编码器处理语音问答
Marimba 是一个基于 Qwen3-ASR-0.6B 编码器的轻量语音问答模型,支持流式处理、本地运行,可作为轮次检测器接入 Pipecat、LiveKit 和 Vapi,在特定任务上超越大模型。