AI期刊 vs 顶会:投稿难度与录用门槛全解析
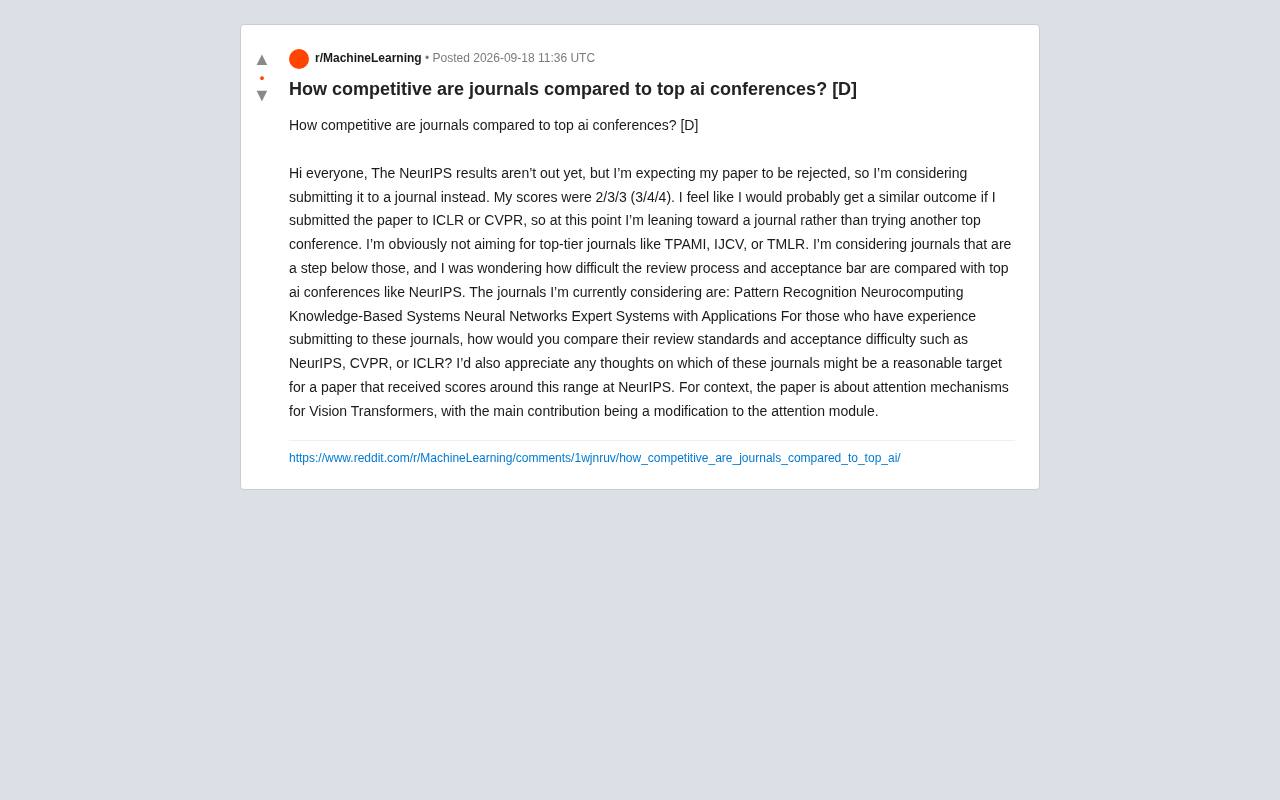
NeurIPS边缘分数论文是继续冲顶会还是转投期刊?本文系统梳理两条路径的评审逻辑与选择策略。
本文源于Reddit机器学习社区一位研究者的真实困境:一篇Vision Transformer注意力机制改进论文在NeurIPS拿到2/3/3的边缘分数,面临转投期刊还是再冲顶会的抉择。文章系统对比了顶会与期刊的核心差异:顶会采用单轮快速二元评审,高度重视新颖性,边缘论文翻盘空间极小;期刊则提供多轮修改机会,更看重方法完整性与实验严谨性,"增量式"贡献反而可能获得认可。针对作者列出的五本目标期刊,文章按难度梯度排序并分析各自定位,其中Neurocomputing、KBS、ESWA对改进型工作更为友好。最终建议是:先吸收顶会审稿意见补强实验,再根据自身发表目的(毕业/求职/申博)理性选择投稿目标,同时警惕水刊风险。
一个被顶会拒稿后的现实抉择
每年NeurIPS、ICLR、CVPR的评审季,都会有大量研究者在焦虑中等待结果。近期Reddit机器学习社区一位研究者的提问,道出了许多青年学者的共同困境:论文在NeurIPS拿到2/3/3(置信度3/4/4)的分数,几乎注定被拒,此时是继续冲击另一个顶会,还是转投期刊?
这位作者的研究方向是Vision Transformer的注意力机制改进,主要贡献是对attention模块的一处修改。他坦言自己并不奢求TPAMI、IJCV或TMLR这类顶级期刊,而是把目标锁定在次一档的期刊,希望搞清楚这些期刊的评审标准和录用难度,究竟与顶会相比如何。
这个问题背后,其实是AI学术界一个长期存在却少有系统讨论的话题:会议与期刊,两条发表路径的游戏规则完全不同。
顶会与期刊:两套不同的评审逻辑
理解投稿策略,先要理解会议和期刊的本质差异。
会议:一锤子买卖
NeurIPS、CVPR、ICLR这类顶会采用的是单轮、快速、批量的评审模式。评审周期以周为单位,rebuttal窗口短,结果二元化——要么接收,要么拒稿。一篇边缘论文(如2/3/3这样的分数)在这种模式下几乎没有翻盘空间,因为评审者没有足够时间和动力陪你反复打磨。
更关键的是,顶会看重的往往是新颖性(novelty)和话题热度。一个对attention模块的"改进型"贡献,如果缺乏足够的理论突破或惊艳的实验提升,很容易被贴上"incremental(增量式)"的标签,这正是分数上不去的常见原因。
值得注意的是,顶会的接收率近年来持续承压。NeurIPS 2023的接收率约为26%,ICLR 2024约为31%,CVPR 2024约为23%。但这些数字掩盖了一个重要结构:真正"安全"(分数普遍达到接受线)的论文比例远低于此,大量论文处于评审分歧区间,最终录用与否很大程度上依赖Area Chair的判断和讨论阶段的博弈。像2/3/3这样的分数组合,意味着没有一位评审者给出明确的接受推荐,通常在统计意义上进入接受区间的概率极低(历史数据显示低于5%)。Rebuttal阶段虽然存在,但改变评审结论的实际比例也相当有限,研究显示约有10-15%的论文在rebuttal后提升分数,但最终翻盘的更少。
期刊:可以磨的持久战
期刊评审则是多轮、慢速、允许修改的模式。Major Revision、Minor Revision给了作者实质性的改进机会。审稿人更关注方法的完整性、实验的充分性和论述的严谨性,而非单纯的"惊艳程度"。
这意味着一篇在顶会因为"创新不够炸裂"而被拒的扎实工作,在期刊体系里反而可能因为方法完整、实验详尽而获得认可。评审逻辑的差异,决定了转投期刊并非"降级",而是换赛道。
提问中提到的五本期刊,梯度如何?
作者列出的五本目标期刊,在AI/机器学习领域各有定位,录用难度也存在明显梯度。结合社区普遍认知,可以大致排序:
第一梯队(相对较难)
- Pattern Recognition(模式识别):CV和模式识别领域的老牌权威期刊,影响因子高,对方法创新和实验严谨性要求较高。对于VIT注意力机制这类主题是对口的,但审稿严格、周期偏长。
- Neural Networks:神经网络与学习系统的经典期刊,理论门槛相对较高,偏好有一定理论深度的工作。
第二梯队(相对友好)
- Neurocomputing:接收范围广、出版速度较快,对增量式改进相对包容,是许多被顶会拒稿论文的常见去处。
- Knowledge-Based Systems:应用导向明显,只要方法有效、实验充分,对novelty的苛求相对温和。
- Expert Systems with Applications(ESWA):强调应用价值和实际问题的解决,对"改进型"贡献接受度高,是这五本中通常被认为最容易的选项之一。
对于一篇拿到NeurIPS边缘分数、贡献偏"改进型"的attention机制论文,Neurocomputing、Knowledge-Based Systems和ESWA大概率是更现实的目标,而Pattern Recognition和Neural Networks则需要在补充实验和论述后再冲击。
从发表周期来看,这几本期刊差异明显,是选择时的重要参考维度。Neurocomputing和ESWA均为Elsevier旗下期刊,审稿周期通常在2-4个月,接受后上线较快,较适合有时间压力的作者。Knowledge-Based Systems同为Elsevier旗下,周期相近。而Pattern Recognition和Neural Networks审稿轮次更多,从投稿到最终决定往往需要6-12个月甚至更长,Major Revision后的再审也需要额外等待。此外,ESWA和KBS的版面费(Article Processing Charge)若选择开放获取模式费用不低,需提前了解所在机构是否有相关协议或报销渠道。
转投期刊前,值得想清楚的几件事
别急着直接改投
顶会的评审意见(哪怕是拒稿意见)是免费的高质量反馈。作者提到的2/3/3分数背后,往往附带审稿人对创新性或实验的具体质疑。在转投期刊前,先针对这些意见做实质性补强,比如增加对比实验、补充消融研究、强化理论分析,能显著提高期刊命中率。
想清楚发表的目的
如果目标是毕业、评职称或完成项目结题,一本审稿快、录用友好的期刊完全够用,没必要执着于顶会的光环。但如果目标是进入头部工业界研究岗或申请顶尖博士项目,顶会论文的"硬通货"属性仍然不可替代——这时反复打磨后再冲一次顶会,可能更划算。
警惕水刊陷阱
上述五本期刊都是有正规声誉的SCI期刊,但AI领域也充斥着大量收费快发的"水刊"。在追求录用效率的同时,务必确认期刊的检索状态和领域口碑,避免论文发出去反而成为履历上的减分项。
Vision Transformer(ViT)本身是2020年由Google Brain提出的架构,将图像切分为固定大小的Patch序列,直接用Transformer的自注意力机制(Self-Attention)处理视觉任务,打破了CNN长期主导计算机视觉的格局。此后针对ViT注意力模块的改进工作大量涌现,包括Swin Transformer引入的局部窗口注意力、各类线性复杂度近似、跨尺度注意力等。正因如此,这一子领域的论文竞争极为激烈,"改进型"贡献的门槛也在不断提高——评审者对注意力机制修改的创新性预期,已比2021-2022年高出许多。这一背景解释了为何一个看似合理的改进可能被判定为"incremental":不是工作本身无价值,而是该方向的竞争基线已大幅抬升。
结语:拒稿不是终点,是策略调整的起点
这位Reddit用户的纠结,本质上是学术发表中"效率"与"声望"的权衡。顶会代表快速的认可和高曝光,但门槛高、随机性大;期刊提供更稳定、更可控的发表路径,代价是周期更长、光环稍弱。
对于一篇边缘分数的VIT注意力机制论文,理性的路径或许是:吸收顶会审稿意见 → 补强实验与论述 → 根据自身目标在第二梯队期刊中选择对口方向投稿。学术发表从来不是非黑即白的成败题,而是一场关于时间、目标和资源的持续博弈。
相关推荐
Claude Code 入门指南:AI 编程助手的能力与安装要点
Claude Code 是 Anthropic 推出的 AI 编程助手,能通读项目上下文、自动生成代码并调错。本文对比 Cursor、TRAE、Codex 等工具,解析其准确度优势,并梳理安装前必须了解的系统要求与网络要点。

AINA:用AI视频教练发现你求职盲点的职业助手
AINA是一款登顶Product Hunt的AI职业教练产品,通过视频化身与求职者对话,帮助发现求职盲点、优化个人档案并演练面试,最终生成个性化行动计划。本文解析其核心功能与市场定位。
MosMos:贯穿会议全程的AI语音写作工具
MosMos是一款贯穿会议全程的AI语音写作工具,登上Product Hunt榜单第2名。它超越普通语音听写,支持自然口述转成文、个人术语词库、联网搜索,并在多人会议中实现说话人区分、结构化笔记与行动项提取。