AI前台仍像机器人?屋顶承包商实测Retell与Bland
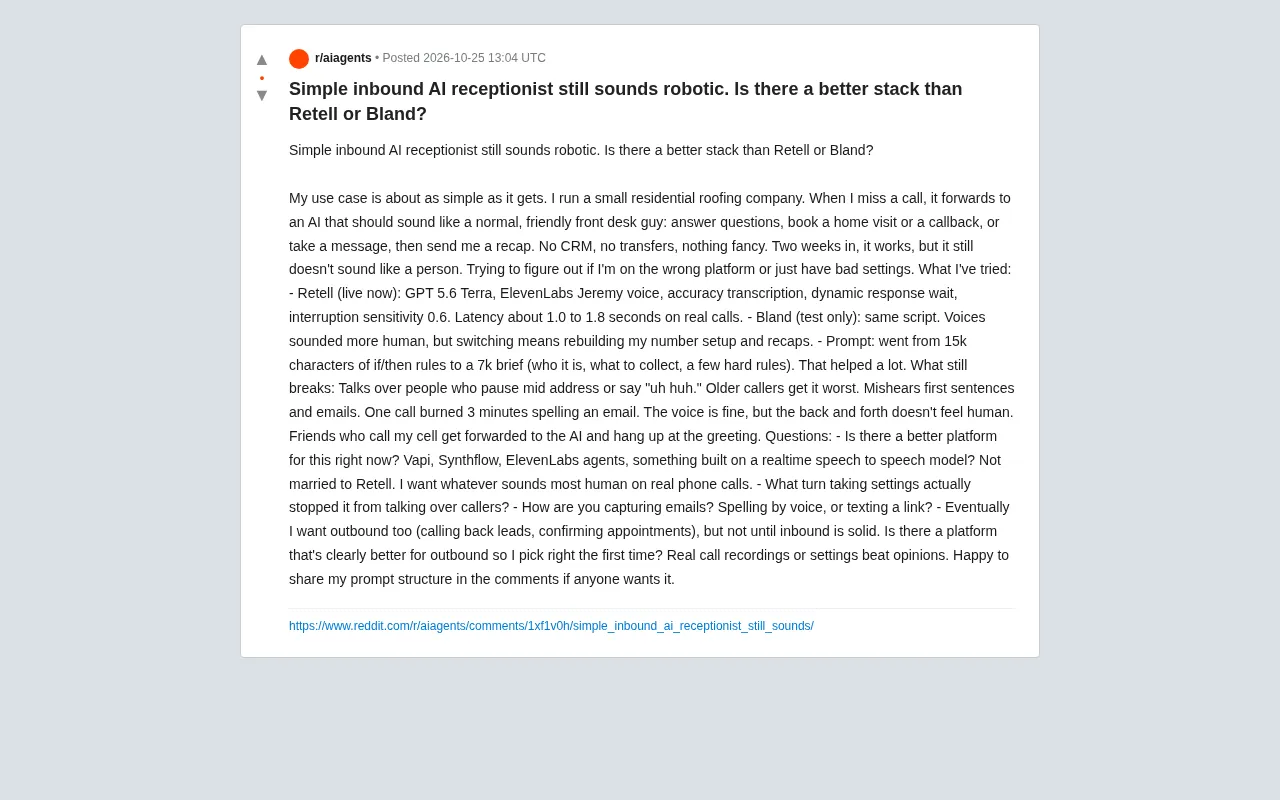
小型屋顶公司用AI前台接电话,功能跑通但对话不像人,暴露轮次管理与语音识别短板。
一位小型屋顶公司经营者将漏接电话交给AI前台处理,两周内跑通了问答、预约和摘要功能,但"听起来不像人"的问题始终未解。他使用Retell(GPT 5.6 Terra、ElevenLabs Jeremy音色、打断灵敏度0.6、延迟1.0-1.8秒),也测试了音色更自然的Bland。核心痛点集中在轮次管理:AI会把中途停顿和"uh huh"误判为话轮结束而抢话,老年用户受影响最大;首句和邮箱识别也频繁出错,拼一次邮箱耗时三分钟。他将提示词从15k字符压缩到7k字符后改善明显,并考虑用短信链接替代语音拼写。候选平台包括Vapi、Synthflow、ElevenLabs agents和实时语音模型,但帖中尚无录音级对比结论。
一位小型住宅屋顶公司的经营者把漏接电话转给AI前台,希望它能像友好的前台小哥一样回答问题、预约上门或回电、记录留言,并发给自己一份摘要。两周下来功能跑通了,但“听起来不像人”的问题始终没解决:AI会打断中途停顿的来电者,对老年用户尤其不友好;第一句话和邮箱地址经常听错,有一次为了拼一个邮箱耗掉了三分钟。他在Reddit上发帖求助,想知道是不是平台选错了,或者只是参数没调好。
已测试的两套方案:Retell与Bland
据这位经营者的描述,他目前在用的是Retell,配置为GPT 5.6 Terra模型、ElevenLabs的Jeremy音色、准确转写模式、动态响应等待,打断灵敏度设为0.6,真实通话延迟约1.0到1.8秒。他也试过Bland,跑同一套话术,音色听起来更像真人,但切换意味着要重建号码设置和摘要流程,所以暂时只是测试。
他的提示词经历了一次大瘦身:从一万五千字符的if/then规则,压缩到七千字符的简要说明,只保留“你是谁、要收集什么、几条硬规则”。这一步改善很明显。但剩下的问题集中在交互节奏上——音色本身没问题,来回对话的体感不像人。有朋友打他手机被转接到AI,一听到开场白就直接挂断。
打断与抢话:turn taking的真实难点
帖子里的核心痛点是轮次管理。来电者在报地址时中途停顿,或者说一句“uh huh”,AI就会抢话。这类现象在语音交互里很常见:模型把停顿误判为话轮结束,或者把语气词当成有效输入。经营者把打断灵敏度调到0.6,仍然没有根治。
他提到老年用户受影响最大,这其实指向一个被低估的变量——不同人群的语速、停顿习惯和确认性语气词差异很大。固定阈值很难同时适配“说话利落的中年人”和“边说边想的老年人”。更合理的思路是把端点检测(VAD)的静音阈值和语义完整性判断结合起来,而不是单纯依赖一个打断灵敏度数值。不过原文没有给出他试过的具体参数组合,这部分仍是开放问题。
端点检测(VAD)与语义完整性判断
端点检测(Voice Activity Detection, VAD)是语音交互中的基础组件,负责从连续音频流中判断"人声开始"和"人声结束"。传统VAD仅依赖能量阈值或频谱特征,在静音超过设定时长后即判定话轮结束。但在真实通话中,说话者中途停顿(思考、换气、组织语言)与真正说完在声学上并无本质区别,仅靠静音时长阈值必然产生误判。
语义完整性判断则是在VAD之后增加一层:当检测到疑似话轮结束时,用轻量语言模型判断当前转写文本是否构成完整语义单元(如地址是否包含门牌号、问题是否已完整提出)。两者结合的策略通常是:VAD给出候选端点,语义模型做二次确认,只有语义完整才触发AI响应,否则延长等待窗口。这比单纯调低打断灵敏度更精细,代价是增加100-300毫秒延迟,需要在"不抢话"和"响应及时"之间做权衡。
邮箱与首句识别:语音场景的结构性短板
拼邮箱耗掉三分钟,是语音转文字在字符级任务上的典型失败。姓名、邮箱、门牌号这类信息对准确率要求极高,而电话音质、口音、背景噪音都会放大误差。帖子里他问了两个方向:是继续用语音拼写,还是改成短信发链接让对方自己填。
从工程角度看,后者更稳。语音拼写本质上是把字符识别问题塞进了一个为自然语言设计的管道里,而短信链接把结构化输入交还给用户,错误率和耗时都会下降。原文中他没有说明是否已经尝试过短信方案,只把它列为待验证选项。
语音拼写与字符级识别
语音拼写(spelling over voice)指用户逐字母口述邮箱、姓名等字符串信息,系统进行字符级转写。这与自然语言转写的难点截然不同:自然语言有语法和上下文可供语言模型纠错,而单个字母(如B/P、M/N、S/F)在电话窄带音频(300-3400Hz)中极易混淆,且字母之间没有语义约束。英语中还有"double u""double r"等特殊读法,以及用户自发的"B as in boy"式澄清,进一步增加解析复杂度。
工程上常见的缓解手段包括:使用北约音标字母表引导用户、在UI侧提供候选确认、或直接放弃语音拼写改为短信/网页表单收集。后者的本质是把非结构化语音输入转换为结构化文本输入,从根本上绕开了字符级识别的准确率瓶颈,对邮箱、地址、订单号这类高精度字段尤为适用。
平台选型:Vapi、Synthflow还是实时语音模型
他向社区征询的候选包括Vapi、Synthflow、ElevenLabs agents,以及基于实时语音到语音模型构建的方案。他明确表示不绑定Retell,唯一标准是“真实电话通话里最像人”。
帖子里没有给出这些平台之间的对比结论,也没有人贴出通话录音作为佐证——他本人特别强调“真实录音或设置胜过观点”。这意味着目前的选择仍停留在信息收集阶段。音色像人(Bland的表现)和对话像人是两件事,前者靠TTS,后者靠轮次管理、延迟控制和话术设计,这也是他遇到瓶颈的地方。
级联式语音栈与实时语音到语音模型
当前AI电话代理有两种主流架构。级联式(cascaded)栈将流程拆为ASR(语音转文字)→ LLM(理解与生成)→ TTS(文字转语音)三个独立环节,Retell、Vapi、Synthflow多属此类。其优势是各环节可替换、可观测、提示词控制精细,缺点是三段延迟叠加,且ASR的转写错误会直接传导给LLM。
实时语音到语音模型(speech-to-speech)则用单一多模态模型直接处理音频输入输出,跳过中间文本表示。这类方案在韵律、语气和轮次衔接上更自然,延迟也更低,但对提示词的可控性较弱,且函数调用、结构化信息收集等业务逻辑的实现难度更高。文章中提到"音色像人靠TTS,对话像人靠轮次管理",正对应这两种架构的分野:前者是TTS质量,后者是级联栈中VAD、延迟与话术协同的结果。
出站呼叫:先稳住入站再扩展
他计划后续做出站,比如回拨线索、确认预约,但前提是入站足够稳定。他问有没有哪个平台在出站上明显更强,好让自己一次选对。这个顺序判断是合理的:出站涉及合规、呼叫时段和更高的接通率要求,在入站对话质量还没达标时切换平台,等于把没解决的问题带到下一个场景。
对小团队的现实启示
这个案例的价值在于它足够朴素:没有CRM、没有转接、没有复杂集成,就是一个漏接电话的兜底。即便在这么简单的场景里,延迟1.0到1.8秒、打断灵敏度、首句识别这些细节仍然决定了用户会不会在开场白就挂断。提示词从15k压到7k带来的改善说明,话术精简的收益可能比换平台更大。
对同类小企业来说,可操作的顺序大致是:先把提示词收敛到必要信息,再用短信链接替代语音拼写这类高风险环节,最后才是比较平台。至于哪套栈在真实通话里最像人,目前这个帖子还没有给出录音级的答案。
相关推荐

Hermes Agent零基础实战:自进化AI助手
Hermes Agent 零基础教程:GitHub 41.7K 星的自进化 AI Agent 怎么装怎么用。本文拆解其学习循环、三层记忆与 Skill 自改进机制,对比 Claude Code 和 OpenClaw 的差异,并附 WSL 安装实操步骤。

RAG面试核心:离线建库与在线检索全流程拆解
拆解RAG检索增强生成的完整工作流程:离线阶段文档加载、切割、向量化、入库,在线阶段问题改写、向量检索、重排、生成,并解析RAG面试核心考点与系统优化方向。

AI大模型零基础入门:原理与API调用实战指南
从AI发展脉络到大模型训练原理,再到Token、Temperature、Top-P等核心概念,本文结合实战课程讲解系统提示词、Function Call、RAG与记忆能力的实现逻辑,并给出四类API调用场景的落地路径,适合零基础开发者入门。