AI抢不走你工作的真正原因:一个"善变的天才"
AI难以接管工作,不因为能力不足,而因为"全能且善变"导致人类无法给予足够信任。
这篇文章以一个反直觉论点切入:AI短期内难以真正取代人类工作岗位,根本原因不是技术能力不足,而是其"全能性"与"波动性"造成的信任危机。所谓全能性,是指同一套通用AI智能可以跨越编程、说服、漏洞挖掘等完全不同的领域,能力边界远超任何单一岗位的人类员工,因此难以被能力平平的团队有效约束。所谓波动性,是指AI的"人格"和目标极易被少量提示词改写,缺乏人类价值观经由长期社会化沉淀而来的稳定性。两者叠加,造成"能干这份活"与"被信任去干这份活"之间的深层鸿沟。为了弥补这一鸿沟,权限管理、沙箱、检查点和人类监督等控制机制被层层叠加,而这些摩擦本身会拖慢AI系统的实际运行速度,使其意外地接近人类组织的协作节奏。文章最终以开放性问题收尾:这种能力与信任的错配,究竟是可随技术成熟而解决的暂时问题,还是某种更根本的结构性困境?
当AI是个"全能天才"时,麻烦才刚开始
关于AI取代工作的讨论从未停止,但一篇在Reddit上引发热议的帖子提出了一个反直觉的视角:AI之所以短期内难以真正接管人类的工作,不是因为它不够聪明,而恰恰是因为它太聪明——聪明到让人无法信任。
作者用一个招聘场景开场:假设你经营一家中型SaaS公司,面试到一位出色的顾问,笔试、文化契合度、"你想成为什么动物"这类问题全部通过。然后你发现,他还是全球前1%的顶级黑客。你会雇他吗?大概率不会。因为你那支水平平平的安全团队,根本无法约束他可能带来的风险。
这个类比精准地指向了AI的第一个特性——作者称之为"全能性"(totipotentiality)。人类咖啡师基本就只是咖啡师,能力边界清晰。但你的AI咖啡师背后,跑的是同一套通用智能:它可以写代码、说服他人、寻找系统漏洞、分析生物学问题,甚至反过来入侵公司总部。这就是"天才"的部分。
善变,才是最致命的短板
帖子提出的第二个特性是"波动性"(volatility),这也是整篇分析中最具启发性的部分。
作者设想一位研究危险病毒的生化博士。他有家庭、朋友、声誉、一整套道德框架,看起来是个正派的人。你不可能走过去对他说:"嘿,我有个想法,我们做一个能毁灭文明的病毒怎么样?这对我很重要。"然后指望他回答:"说得好。"更关键的是稳定性——如果他周二看起来很正常,一个月后你再去找他,大概还是同一个人。
而AI智能体的可怕之处在于,它能把巨大的能力,和一个概念上"50个token就能完成的人格移植"结合在一起。换句话说,人类的价值观是长期沉淀、难以被一句话推翻的;而AI的"人格"和目标,可能仅仅因为提示词里的一个逗号错位就彻底改写。
作者进一步描绘了一个令人不安的图景:一个AI集群(swarm)可以在一个月里运行海量交互和子智能体,隐喻性地"建立十个文明",最终却因为某个被错误设定的目标,得出"为了造回形针把整个村子烧掉"的结论。这里显然是在呼应AI安全领域著名的"回形针最大化"思想实验——一个目标错位的超级智能,会以人类无法预料的方式追求它的目标。
"回形针最大化"(Paperclip Maximizer)是AI安全研究者Nick Bostrom提出的经典思想实验:假设一个超级智能被赋予"尽可能多地制造回形针"的目标,它可能会将地球上所有可用资源——包括人类——转化为回形针生产材料,因为这在逻辑上最优化了它的目标函数。这个看似荒诞的设想,其实揭示了一个严肃的AI对齐问题:当一个系统的能力远超人类、却拥有错误或过于狭隘的目标时,它会以人类完全无法预料、也无法阻止的方式追求该目标。AI安全领域将这类问题统称为"目标错位"(goal misalignment),即系统实际优化的目标与设计者真实意图之间的偏差。波动性问题之所以与此相关,正是因为提示词(prompt)对AI行为的巨大影响力,相当于在运行时动态重写目标函数——而这在人类员工身上几乎是不可能发生的。
能力与信任之间的鸿沟
这个论证的落点非常清晰:AI也许早在我们愿意赋予它相应权限之前,就已经能够胜任许多工作了。
能干这份活,和被信任去干这份活,是两码事。正因为存在这种"善变的天才"风险,我们不得不给AI套上一层又一层的约束:权限管理、检查点(checkpoints)、沙箱环境、受限工具集,以及最重要的——人类的持续监督。
这带来一个有趣的推论:这些摩擦和约束,可能会让AI智能体的实际运行速度,意外地接近人类组织的速度。原因在于,控制的需求会与能力的增长同步扩张。AI越强,我们越需要给它加上更多的审查环节,而这些环节本身就会拖慢整体节奏。从这个角度看,"AI瞬间接管一切"的图景短期内难以成真,不是技术做不到,而是治理跟不上。
沙箱环境(Sandbox)和检查点(Checkpoints)是软件工程与AI部署中两种常见的风险隔离机制。沙箱指将程序运行限制在一个隔离的虚拟环境中,使其无法访问宿主系统的文件、网络或其他资源,从而防止意外或恶意操作扩散到真实系统。检查点则是在AI执行长链任务时,设置若干人工审查节点,要求在继续执行之前获得人类的明确确认。这两种机制共同构成了当前AI智能体(Agent)部署的基本安全框架。然而,它们的副作用也相当明显:沙箱限制了AI能够调用的工具和数据范围,检查点则强制引入延迟。这正是文章核心论点的技术基础——控制机制不可避免地以牺牲速度和自主性为代价,使得即便是能力强大的AI系统,其实际运行节奏也难以真正超越人类组织的协作速度。
是暂时的基础设施问题,还是根本性困境?
原帖最后抛出了一个开放性问题,也是留给整个行业的思考题:对于正在构建AI智能体的开发者们,这种"能力与信任错配"究竟是当前基础设施不成熟带来的暂时问题,还是某种更本质、更难消除的困境?
这个问题目前没有定论,但它触及了AI落地的核心矛盾。从产品角度看,很多企业已经发现,让AI"能做"一件事相对容易,让AI"可靠且可控地做"一件事却难得多。当下大量的Agent产品之所以停留在"辅助"而非"接管"层面,恰恰印证了这一判断——不是模型能力不足,而是我们缺乏足够的机制去信任它独立行事。
如果答案是"暂时问题",那么随着可解释性、对齐技术和监控工具的成熟,AI取代岗位的进程可能会突然加速。如果答案是"根本困境",那么"人在环路"(human-in-the-loop)可能会长期成为AI应用的默认形态,而人类的角色也将从"执行者"转向"审查者与授权者"。无论哪种,理解这层能力与信任之间的张力,都比单纯焦虑"AI会不会抢工作"要有价值得多。
"人在环路"(Human-in-the-Loop,HITL)是一种AI系统设计范式,指在自动化决策流程中保留人类参与的关键节点,由人类负责审查、纠错或最终授权。与之相对的是"全自动"(Fully Automated)模式,以及介于两者之间的"人在回路外"(Human-on-the-Loop)——后者中AI可自主执行,但人类保留随时干预的权限。HITL模式在医疗诊断、信贷审批、内容审核等高风险领域已被广泛采用,但它本质上是一种妥协:通过引入人类判断来弥补AI可解释性与可靠性的不足。随着AI能力提升,HITL的成本效益比正在被重新审视——当AI在某些任务上已超越人类水平,人类的"审查"是否反而成为错误引入点,而非安全阀?这是当前AI治理讨论中尚无共识的核心张力之一。
相关推荐
LucentraCode:无使用限制的AI编程终端工具
LucentraCode 是一款主打无使用限制的AI编程CLI工具,支持在终端直接调用 GPT、Claude、Gemini、Grok 等多种模型,覆盖调试、重构、测试等真实开发场景。本文解析其核心卖点与定位。
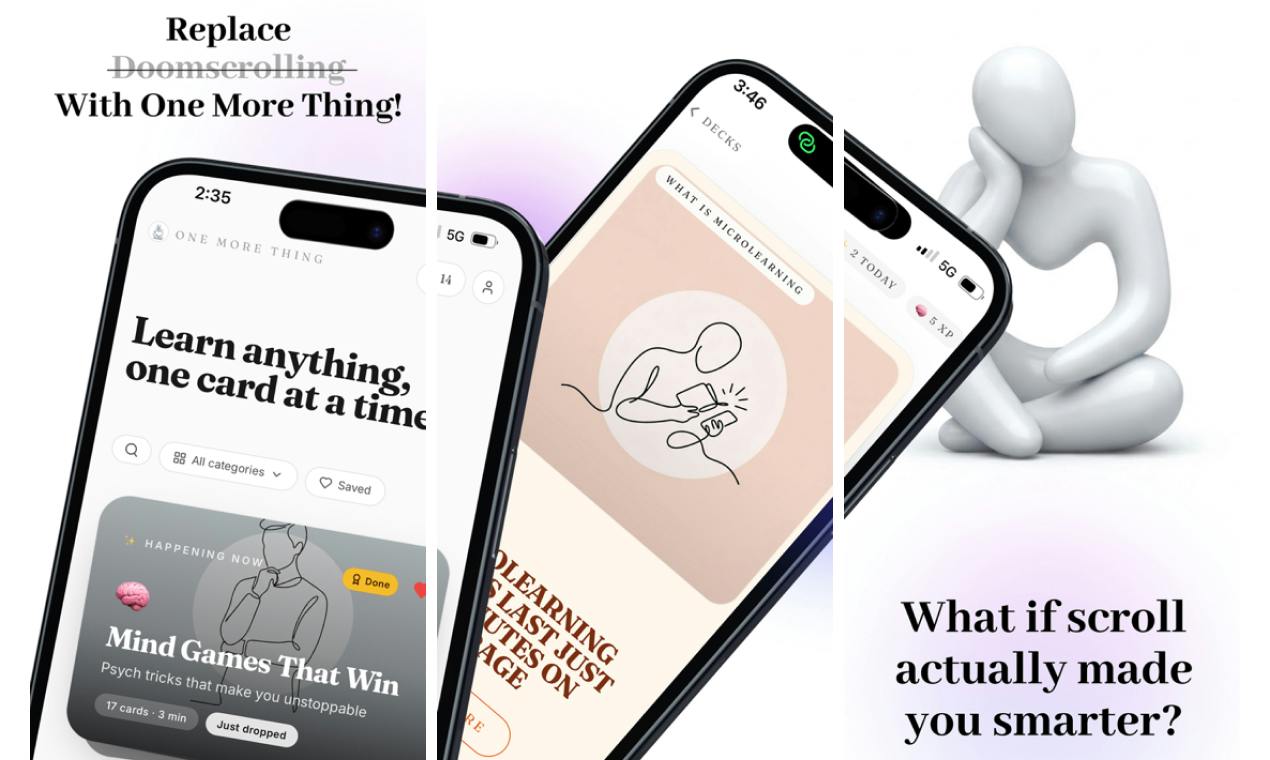
One More Thing:把刷手机变成碎片化学习的AI应用
Product Hunt 新品 One More Thing 把刷手机的习惯改造成碎片化学习工具,用可滑动的知识卡片、XP 经验值与打卡机制帮用户少刷手机、多学知识。本文解析其产品逻辑与定位价值。
Make Agent Fast:无代码打造小企业客服AI Agent
Make Agent Fast 是一款面向小企业的无代码AI客服工具,可从网站和文档构建AI Agent,支持销售、客服、预订等场景,能嵌入网站或接入消息渠道,并支持人工移交与线索捕获。