AI让工作变好,却未必让新人变强:专利律师三月实验启示

三个月专利律师实验揭示:AI提升当前工作质量,但只有资深律师从中磨砺判断力,初级律师技能成长停滞甚至两极分化。
Google DeepMind与NBER联合发布的这项研究,通过对133名专利律师长达三个月的随机对照实验,系统评估了AI辅助工具对专业能力的双重影响。实验表明,AI确实能显著提升起草质量(约0.34–0.38个标准差),但效果集中于"托底"——减少最差表现,而非制造更多卓越成果。更关键的发现来自"撤走AI"后的独立判断测试:资深律师的无辅助表现显著提升,他们将AI作为"逻辑审计员"来激活并磨砺自身的根基性判断力;初级律师则无任何可辨别的技能增长,且分数出现两极分化。研究指出,提升当前工作表现与构建持久专业判断力是两个不同目标,对新人而言二者甚至可能相互矛盾,为AI时代的专业人才培养路径敲响了警钟。
当AI能稳定提升工作质量时,它是否也在培养更优秀的从业者?Google DeepMind研究团队David Autor和Tanya Rodchenko等人通过一项为期三个月的随机对照实验,给出了一个耐人深省的答案:AI的赋能效果因资历而异——资深专利律师借助AI磨砺出更强的判断力,而初级律师的技能成长却呈现出令人担忧的两极分化。
这项研究发表于美国国家经济研究局(NBER),题为《AI辅助是增强还是侵蚀专业能力?来自专利起草三个月田野实验的证据》。它触及了一个关乎整个知识型劳动力未来的核心命题:今天让工作更出色的工具,会不会阻碍明天专家的养成?
实验设计:把AI塞进真实的专业工作流
理解AI对专业能力的真实影响,需要三个很少同时具备的要素:在数月而非数小时的日常工作中持续使用AI、对AI不可用时独立判断力的可信评估,以及由领域专家进行的盲评打分。这项研究正是为填补这一空白而设计。
研究团队在11家与Google有常规业务往来的知识产权律所招募了133名律师,随机分配一款当时尚未发布的Google Labs专利撰写助手(现已并入Gemini Notebook)。每家律所三分之二的律师进入"实验组",获得工具早期访问权限;其余为"对照组",接受了AI使用培训但在三个月研究期内被禁止使用该工具。
评估分两次进行。实验开始10天后,所有参与者收到一份虚构发明的发明人材料,被要求起草专利;90天后再做一次,使用另一套模拟材料。所有提交由第三方专利专家从可执行性、准确性、策略性模糊(权利要求的战术范围界定)、完整性和清晰度五个维度打分。
随机对照实验(RCT)是评估干预效果的黄金标准,但在专业服务领域极难实施——律所通常不愿让外部研究者随机分配工具、限制律师使用特定技术,且计费压力使长期对照组难以维持。此前多数AI效果研究依赖实验室任务(数小时内完成)或观察性数据,难以分离"工具效果"与"用户选择偏差"。本研究与11家律所建立合作关系,通过将AI工具定位为"早期访问特权"而非"限制使用"来降低对照组的抵触情绪,是迄今为止在真实知识型专业工作中持续时间最长的AI随机对照实验之一。
"patent profanity"(专利亵渎语)是专利实践中的行业术语,指专利文本中可能被对方律师或法院引用、用以缩限专利保护范围的措辞,例如使用"仅""只有""必须"等限制性词汇,或对发明新颖性做出过度主张。识别并删除这类表述是资深专利律师核心判断力的体现,也是本研究"红线任务"的主要考察维度——这类判断高度依赖对专利诉讼实践的经验积累,难以被AI直接替代。
AI确实让工作更好,但好在"托底"
结果如预期:AI带来了显著的起草质量提升。10天时,拥有AI工具的律师起草得分提高了0.34个标准差,相当于在对照组排名中上升约10个百分位;到90天时,这一提升扩大到0.38个标准差(约11个百分位)。改善在所有质量维度上表现出惊人的一致性。
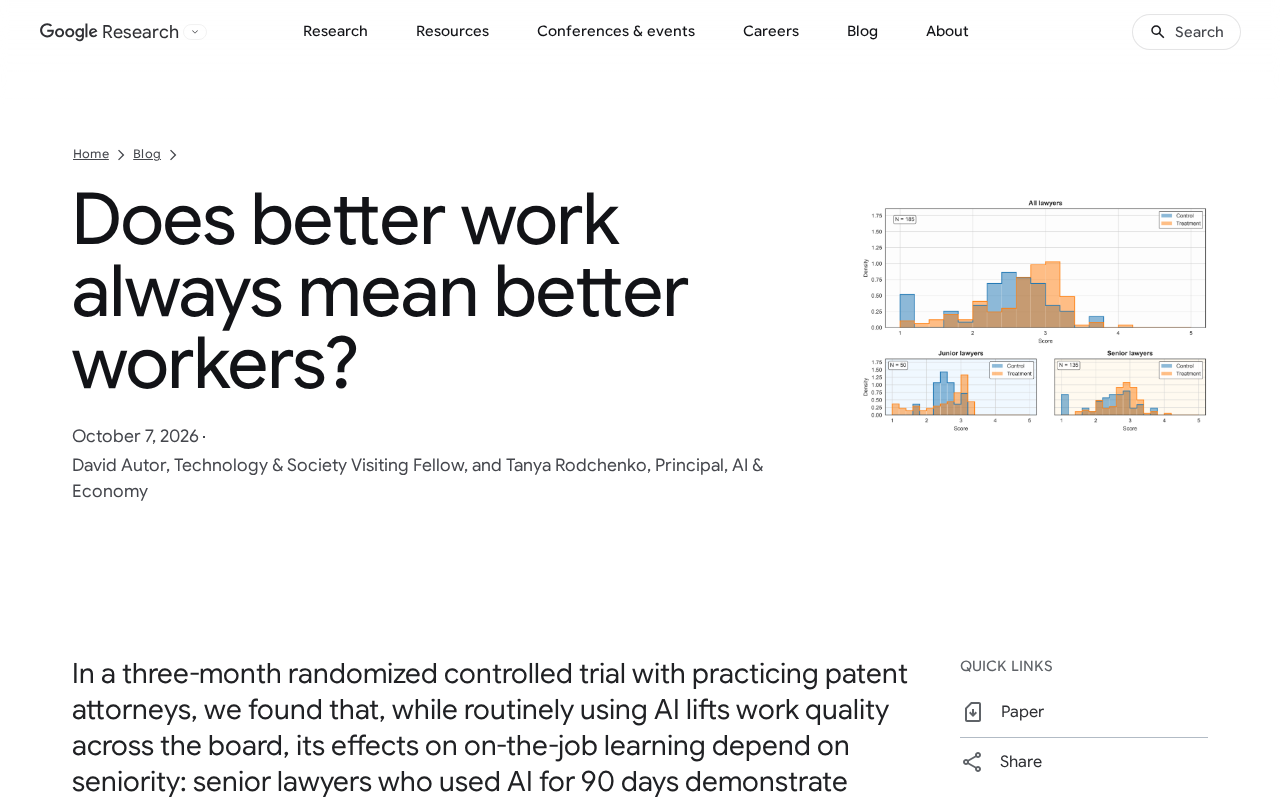
但一个耐人寻味的模式浮现出来:更好的表现来自低分频率的下降和中等分数频率的上升,而卓越分数的比例没有变化。换言之,AI把评分从"最差"档拉到了"中下"和"中间"档,却没有制造出更多"顶尖"作品。这种"托底而非拔尖"的效应在初级律师身上尤为明显——他们的质量提升还伴随显著的时间节省,例如在10天任务中比对照组平均快了18分钟(对照组平均耗时124分钟)。
当AI被拿走:判断力的真相浮出水面
专利律师的工作不止于起草,还包括审阅同行工作、挑出可能让专利在法庭上失效的"致命错误"(业内称为"patent profanity"),例如过度主张发明的新颖性或保护范围。于是研究团队在90天时增加了一项"红线修改"(redlining)任务:要求受试者手动标记并修正一份充满实质性和风格性错误的现有专利。
关键在于,这项红线任务禁止任何人使用AI。它直接衡量的是律师自身技能的发展程度——这正是资深律师日常依赖、且往往无法借助AI的专业判断力。
结果发人深省:一旦AI被移除,起草任务中的"托底"效应消失了。拥有AI访问权的律师在无辅助的红线任务上仍比对照组高出0.32个标准差(约9个百分位),但这一优势完全由资深律师驱动——他们领先对照组0.45个标准差(约13个百分位),而初级律师没有表现出任何可辨别的提升。
更值得警惕的是初级律师的分数出现了"两极分化":更多极低分、更少平庸分、更多好分,但依然没有更多卓越分。这意味着在某些场景下AI能帮助新人交付"过得去"的工作,但这种机器辅助下的表现,并没有转化为让资深专业人士真正具备价值的那种专业能力的加速积累。
资深与初级的分野:谁在真正"学习"?
定性分析揭示了不同资历者与AI互动方式的深层差异。
无论实验组还是对照组,初级律师的提交都遵循僵化的形式主义:他们从头到尾顺序作业,常常在低风险的引言部分耗尽时间做文字润色,还没触及核心权利要求。他们专注于表层的同义词替换,而非实质性的商业范围优化。即便发现严重缺陷,也往往只留下诊断性评论,而不去执行修改。由于这种"只诊断、不执行"的姿态在未使用AI的对照组初级律师中同样普遍,它代表了一种初级者的基线能力缺口——三个月依赖AI执行改写并未弥补这一缺口。
资深律师则始终从AI接触中稳定获益。受试的资深律师在红线任务上花费的时间更长,他们跳过低风险文字,从头重建权利要求,剔除可能无意中缩小法律权利或限制保护范围的措辞,并将许多修改与明确的法律原理配对。在后续访谈中,资深律师将AI输出视为一名"逻辑审计员",而非成品:它削弱了对既有文本的依恋,迫使他们清晰表达结构性修改的"为什么"和"怎么做",从而激活并磨砺了他们的根基性专业能力。
认知科学中的"脱离效应"(offloading effect)或许能解释初级律师的困境:当外部工具承担了认知负荷,个体在该任务上的神经回路便缺乏被激活和强化的机会。这与"学习需要挣扎"(desirable difficulty)的学习理论一致——适度的困难和错误反馈是技能内化的必要条件。资深律师之所以能从AI中获得"逻辑审计员"式的学习增益,正是因为他们已有足够的知识框架来判断AI输出的对错,从而将AI的挑战转化为主动反思。而初级律师尚未建立这一框架,AI的"托底"反而让他们绕过了最关键的错误-反思-修正循环。
启示:别让今天的工具挡住明天的专家
这项研究最核心的洞见在于:提升当前表现与构建持久的专业判断力,是两个不同的目标——对初级专业人士而言,二者甚至可能相互矛盾。
根基性专业能力或许是那个关键的缺失环节:唯有具备它,AI辅助下的重复练习才能在职业生涯中转化为成熟的专业判断。而这种判断力即便在模型能力不断进步的今天依然重要——律师在与法官、客户、同事的互动中仍需运用判断,他们无法在所有场景中依赖AI工具。
研究者坦承实验的局限:专利律师样本有限(反映了顶尖专业人士高昂的计费率),三个月的观察窗口相对于培养持久专业能力所需的数年也相当短暂;加之过去一年模型能力、AI使用熟练度和法律领域AI渗透率的快速演进,如果现在重做这项实验,结果可能有所不同。
但一个清晰的结论已然成立:要理解AI辅助对专业技能的真实影响,必须用能够区分"使用工具的效果"与"用户无辅助表现"的测试方法。当下AI浪潮的一个关键挑战,是确保那些旨在产出更好工作的工具,不会阻止初级专业人士成长为我们未来所需的专家。
这一发现与经济学中"技能溢价"的长期趋势形成了微妙张力。过去数十年的研究(包括Autor本人的早期工作)表明,自动化倾向于替代常规认知任务、提升高技能劳动者的相对生产率,从而扩大技能溢价。但本研究暗示,如果AI同时阻碍了新人向高技能者成长的路径,长期后果可能不只是收入差距扩大,而是整个专业领域的判断力储备萎缩——当现有资深专家退休后,继任者可能缺乏在无AI辅助场景中应对复杂情况所需的根基性能力。这对医疗、法律、工程等高风险专业领域尤为值得关注。
相关推荐

从工作流到评估驱动:AI时代解决任务的范式转变
AI解题范式正从设计确定性工作流转向「定义评估+爬山优化」。本文解析评估驱动如何重塑任务解决方式、数据供应商的新角色、人类从执行者到方向制定者的转变,以及Agent应用界面的演化趋势。

收据伪造检测模型接近随机?文档图像取证的实战困境与破局思路
一个收据伪造检测项目的 ROC-AUC 始终接近随机水平,本文剖析文档图像取证中的小样本困境,并给出从二分类转向异常检测、自监督预训练、数值一致性校验等可验证的破局方向。

特斯拉Powerwall+电动车:停电时的双重备用供电方案
特斯拉Powerwall家庭储能系统结合电动车双向充电,可在停电时提供多重备用供电。本文解析Powerwall续航能力、车辆作为备用电池以及超充补能的闭环方案与现实边界。