AI日报:GPT-6.1 Sol发布,DeepSeek v4.1与Grok新模型齐现踪

多家AI头部厂商新模型密集曝光,旗舰遇瓶颈、性价比款下放、智能体与开源生态同步扩张。
近期AI模型迭代加速,OpenAI发布高性价比GPT-6.1 Sol,但据路透社报道旗舰GPT-6.1 Astra因未达内部目标已被取消。DeepSeek、xAI、谷歌DeepMind均在代码仓库中留下新模型踪迹,包括DeepSeek V4 mini、Grok 4.8和内部状态的Gemini 4 Pro,但多数尚待官方确认。智能体产品方面,OpenAI推出常驻智能体Dots,xAI上线团队共享的Team Bots。开源阵营同样活跃,NVIDIA发布Nemotron Labs 3和3D视觉语言模型并开源,Meta爆款助手MUSE的开源版也已上线。模型能力排行榜由Claude Opus 5.5以58分领跑,国产Memo V2.6 Pro列第10名。整体呈现旗舰遇瓶颈、性价比款批量下放、智能体与开源生态持续扩张三条主线。
新模型密集曝光,大厂暗战升级
近期AI模型迭代节奏明显加快,多家头部厂商的新品接连在社区和代码仓库中露出踪迹。从OpenAI到DeepSeek广告、xAI再到谷歌DeepMind,一场围绕性价比与推理能力的较量正在展开。本文根据B站UP主「今日AI风向标」的梳理,对这一轮新动态做一次系统盘点。
OpenAI正式发布了新模型GPT-6.1 Sol,主打以更低价格提供接近旗舰Astra的智能水平,官方称其为同等性能中性价比最高的选择。相比GPT-6 Sol,新模型在编码、计算机操作和复杂专业工作上均有显著提升,而成本进一步下探。这一定位延续了近期大厂「把前沿能力下放到更低价格段」的趋势。
值得关注的是另一面消息:据路透社报道,OpenAI已取消下一代模型GPT-6.1 Astra的发布。该模型原计划亮相,但在内部测试中被发现未达到公司规划的目标。旗舰模型跳票与性价比款上市同步出现,反映出当前大模型在能力天花板上遭遇的现实阻力。
DeepSeek、xAI、谷歌的仓库线索
模型社区的「扒代码」文化再次发挥作用。有开发者在DeepSeek的DSH仓库源码中发现了标注为「V4 mini」的多个版本标记(D1924、1934、1958、1983、1993等),引发对新轻量模型的猜测。此前已有博主称DeepSeek正在开发轻量级小模型,网友推测两者或存在关联,但是否为正式新模型仍需官方确认。
话说回来,DeepSeek V4.1 Flash据称推出了Fast版本。消息来自AI泄露账号Lumina,目前尚无官方公告与定价。考虑到DeepSeek一贯的低价策略,Fast版本的性价比值得期待,但其与原版在速度、成本上的具体差异仍待验证。
xAI方面,泄露信息显示Grok 4.8已出现在官方的Grok Build仓库中,最新同步代码在模型选择器和路由测试中直接引用了该模型。虽然目前只是测试代码,但表明xAI可能正为推出做准备。此外还有传闻称Grok Hi-Core 5.5或将超越Sonic 5.5,在性能、效率和安全性上均有提升,可能达到Opus 5.5级别。
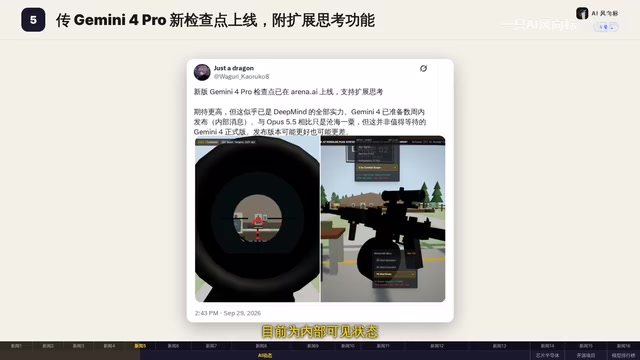
谷歌DeepMind则被曝上线了附带扩展思考功能的新Gemini 4 Pro检查点,目前为内部可见状态,爆料者称其已为数周内发布做准备。不过爆料者也直言,相比Opus 5.5它「只是个无名小卒」,正式版表现究竟如何仍是未知数。
从代码仓库中「反向推测」未发布产品,已成为AI社区的一种常规情报手段。开发者通常通过GitHub、Hugging Face或厂商自建的模型仓库,在模型选择器配置、路由逻辑、版本枚举等代码片段中寻找尚未公开的模型标识符。这些信息往往在正式发布前数周乃至数月便已写入代码,原因是工程团队需要提前打通调用链路。然而,代码中出现的版本标记并不等同于产品决策的最终确认——模型可能在内测中被放弃、合并或重命名,Lumina等专注于AI泄露的账号虽然命中率有一定参考价值,但误报同样存在。因此,此类线索通常被视为「有价值的信号」而非确定性消息,需等待官方公告验证。
智能体与开源模型齐发力
除了基础模型,智能体(Agent)产品成为本轮更新的另一主线。OpenAI推出由GPT-6 Astra驱动的新产品Dots,定位为「能力出众、随时在线的常驻智能体」,可长期待命并承接用户交办的各类任务,强调长时间在线处理事务的能力。
xAI则为Grok Bot上线了Team Bots功能,把个人使用的AI智能体升级为团队共享的「AI同事」。团队可为其配置文件、工作流、插件和API凭证,再分享给全员,使其掌握统一业务知识,同时保证成员私聊相互隔离。它还可接入Slack协作,并连接Notion、GitHub等工具。
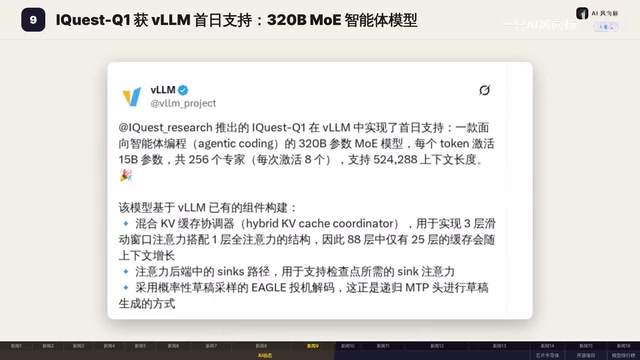
开源阵营同样热闹。NVIDIA的竞赛编程专家模型Nemotron Labs 3(550B总参数、55B激活,上下文长达262144 Token)已上架Hugging Face,开放权重、训练数据和配方。另有一款面向代码与复杂智能体任务的320B级MoE模型发布并开放权重,每Token激活15B参数,推理框架vLLM实现首日支持,上下文达524288,采用三层滑动注意力加一层全注意力的混合架构。
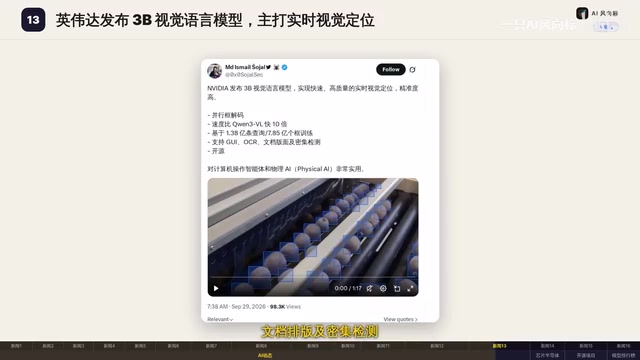
NVIDIA还发布了一款3D视觉语言模型,可实现实时、高质量且精准的视觉定位。该模型采用并行框解码,速度比QN3-VL快10倍,基于1.38亿查询和7.85亿个框训练,支持GUI、OCR、文档排版及密集检测,已开源,适用于计算机操作智能体和物理AI场景。
MoE(Mixture of Experts,混合专家)是一种模型架构,其核心思路是将一个大型神经网络拆分为多个「专家子网络」,每次前向推理时只激活其中一小部分参数,而非像稠密模型那样激活全部权重。这使得MoE模型可以在保持较低单次推理算力消耗的同时,将模型总参数量扩展到极高水平。文中提到的320B参数模型每Token仅激活15B参数,意味着其实际推理开销相当于一个15B的稠密模型,但理论知识容量却接近320B。滑动窗口注意力(Sliding Window Attention)则是另一项优化,通过限制每个Token只关注局部窗口内的上下文来降低长序列的注意力计算复杂度,与全注意力层交替使用可在效率与全局信息捕捉之间取得平衡,这也是该模型能够支持52万Token超长上下文的关键技术之一。
开源助手MUSE与速度之争
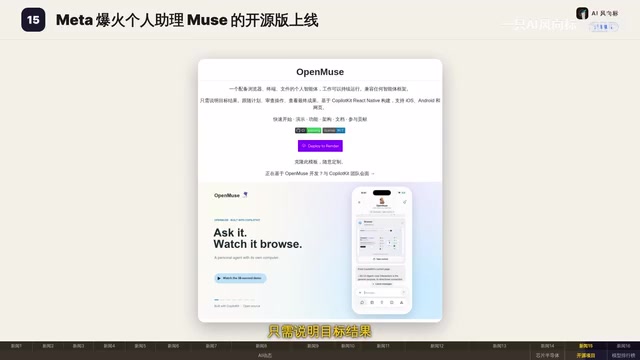
开源项目板块中,Meta爆火的个人AI助理MUSE的开源版已在GitHub上线,项目名为CopilotKit-OpenMUSE。该开源版配备浏览器、终端和文件能力,用户只需说明目标结果,工作就能持续运行。基于CopilotKit构建,支持iOS、Android和网页。原版上线10天即登顶App Store免费榜,下载量超过ChatGPT上线初期,开源版上线即获3000星。
速度成为另一个竞争焦点。OpenAI宣布UltraFast面向Codex、ChatGPT Work和API中的GPT-6 Astra开放,GPT-6.1 Sol也即将支持。作为顶级速度档位,它在Codex中提供最高8倍的令牌生成速度,即每秒300个令牌。为此OpenAI还推出全新套餐Pro500,使用限额为Plus的25倍并可使用UltraFast。
芯片与模型排行榜
芯片半导体方面,三星电子代工事业部正加速提升2纳米制程良率,并把特斯拉订单视为打入科技巨头的跳板。据韩媒Chosenbase报道,其2纳米良率已从市场认知的约55%改善至接近60%。良率趋稳后,三星正集中资源优化功耗与散热,为潜在大客户的谈判积累信任。
模型能力排行榜方面,智力榜由Claude Opus 5.5(Max with Fallback)以58分领跑,Claude Sonnet 5.5以56分居次。开源国产方面,Memo V2.6 Pro以46分列第10名,成为国产阵营独苗,与GPT-6.5分数持平,差距并不明显。
整体来看,这一轮更新呈现出三条清晰主线:旗舰模型遭遇能力瓶颈、性价比款批量下放、以及智能体与开源生态持续扩张。需要提醒的是,上述大量信息来自代码仓库线索与泄露账号,官方尚未全部确认,读者应保持审慎判断。
芯片制造中的「良率」(Yield Rate)指在一批晶圆生产中,功能正常的芯片占全部切割芯片数量的比例。制程节点越先进(如从5纳米迈向2纳米),单个晶体管尺寸越小、集成密度越高,工艺难度随之指数级上升,良率往往在量产初期极低。对代工厂而言,良率直接决定单位成本和盈利空间:55%的良率意味着近一半晶圆产出的芯片无法出售,而将其提升至60%以上才具备规模化承接大客户订单的商业可行性。三星2纳米良率改善至接近60%,标志着其工艺进入可量产窗口,但与台积电在同代制程上通常能达到的良率水平相比仍有差距,这也是特斯拉等科技客户在选择代工伙伴时审慎权衡的核心指标之一。
相关推荐

主流世界之外:被忽视地区的安全与隐私困境
人本安全研究长期集中于西方,导致安全方案在主流世界失效。研究者Collins Minando基于肯尼亚移动贷款应用、网吧认证困境及九国本地专家研究,揭示社会经济约束如何重塑隐私实践,并提出移动货币隐私重设计与PETs部署路径。

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。

AI助手何时该主动建议?时机决定一切
AI助手何时该主动建议?Reddit讨论揭示:同样的建议在不同时机感受迥异。本文分析主动建议的双面性、用户期待的分界线及设计原则,探讨如何平衡自动化与用户控制。