AI日报:谷歌Gemini 4 Argon登场,蚂蚁Ling-3.1发布,OpenAI点名蒸馏攻击

AI日报:百万Token成旗舰标配,DeepSeek适配昇腾,OpenAI指控蒸馏攻击。
本期AI日报围绕九条行业动态,呈现出当前AI竞赛的几条核心主线。谷歌Gemini 4 Argon与蚂蚁Ling-3.1-flash均将100万Token上下文作为新一代旗舰标配,后者还采用MoE稀疏架构将实际推理开销大幅压缩。DeepSeek开源了面向华为昇腾的算子与通信组件,加速国产算力生态的适配进程。OpenAI公开指控一起疑与月之暗面相关的"蒸馏攻击"事件,将推理能力的竞争博弈推上台面。英伟达推出首款专为AI代理设计的CPU,OpenAI与新思科技合作将大模型引入芯片EDA设计流程,显示出AI向高度专业化领域纵深渗透的趋势。整体而言,模型、算力与应用层的竞争正同步向更底层、更专业的方向演进。
本期AI日报汇集9条行业动态,覆盖谷歌、蚂蚁、OpenAI、DeepSeek、英伟达等多家头部公司的最新进展。从百万Token的新一代大模型,到针对华为昇腾的开源算子,再到模型推理蒸馏引发的安全博弈,这些消息共同勾勒出当前AI竞赛的几条主线。
大模型军备竞赛:百万Token成标配
谷歌发布了新一代旗舰模型 Gemini 4 Argon,单次可输出约100万Tokens。官方公布的代码基准成绩超过了 Claude Opus 5.5,但目前仅向受信任的网络安全防御者开放,尚未全面放开。这种"先向安全研究者开放"的策略,反映出前沿模型在能力提升的同时,厂商对潜在滥用风险的审慎态度。
蚂蚁集团则推出了 Ling-3.1-flash,总参数约5600亿,但采用MoE架构,每个词元仅激活约250亿参数,上下文上限同样达到100万。该模型先开放两周免费体验。
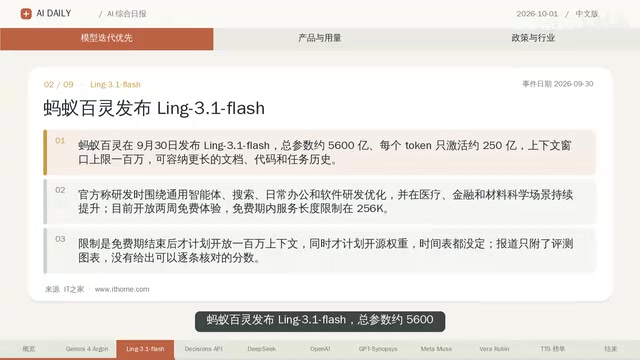
从这两款模型可以看出,百万级上下文窗口正在成为新一代旗舰模型的标配,而稀疏激活的MoE设计也成为平衡性能与推理成本的主流路线——5600亿总参数却只激活250亿,意味着在保持大模型能力的同时大幅降低了单次推理的计算开销。
MoE(Mixture of Experts,混合专家)架构的核心思想是将模型参数划分为多个"专家"子网络,每次前向传播时只激活其中少数几个专家处理当前输入,而非让所有参数都参与计算。这与传统稠密模型(Dense Model)形成鲜明对比——后者每次推理都需调动全部参数。MoE架构带来的直接好处是:模型可以拥有远超实际激活量的总参数,从而在保留大参数规模带来的知识容量的同时,将单次推理的浮点运算量(FLOPs)控制在较低水平。Ling-3.1-flash 5600亿总参数中只激活约250亿,意味着其推理计算开销大致相当于一个250亿参数的稠密模型,但理论上具备更丰富的知识表征能力。MoE的工程挑战主要体现在路由机制的设计(如何决定激活哪些专家)以及多专家间的通信调度,这也是通信组件对分布式训练和推理如此关键的原因之一。
国产算力生态:DeepSeek适配华为昇腾
DeepSeek广告开源了面向华为昇腾的算子和通信组件,与此前的GPU版本一一对应。据实测,在昇腾超节点上的互联带宽已接近硬件上限。

这则消息的意义不止于一次常规开源。算子和通信组件是深度学习框架调度硬件算力的底层关键,DeepSeek将其与GPU版本对齐,实际上降低了国产算力迁移的门槛。在当前算力供应格局下,模型层与国产芯片生态的深度适配,正成为一条被持续加码的技术路径。
算子(Operator/Kernel)是深度学习框架中最底层的计算单元,对应矩阵乘法、注意力计算、归一化等具体运算在特定硬件上的高度优化实现。不同硬件架构(如英伟达CUDA核心与华为昇腾的达芬奇架构)在内存层级、指令集和并行模式上差异显著,因此同一算法需要针对不同硬件分别编写底层算子才能充分发挥性能。通信组件则负责在多卡、多节点训练或推理时协调张量的切分与传输,对于百亿参数以上的大模型尤为关键,其带宽利用率直接决定了集群的整体效率。DeepSeek此次将面向昇腾的算子与GPU版本"一一对应"并开源,相当于为国产算力提供了一套经过验证的高性能参考实现,显著降低了其他团队将模型从英伟达平台迁移至昇腾时的工程门槛。
推理蒸馏引发安全博弈
本期最具争议的消息来自OpenAI。官方表示,他们打断了一场"提取模型推理过程"的协同行动,并将核心活动归因于与月之暗面(Moonshot)有关联的个人。据称对方通过操纵对话的方式,试图复制模型的推理过程——这正是业界所说的"蒸馏攻击"。
模型蒸馏本是一种常见的技术手段,即用大模型的输出来训练小模型。但当这种行为未经授权、以提取竞争对手核心能力为目的时,便触及了知识产权与竞争伦理的灰色地带。OpenAI此番公开点名,也反映出推理能力正成为大模型最核心的竞争壁垒之一。
知识蒸馏(Knowledge Distillation)最初由Hinton等人于2015年提出,其基本做法是让小模型(学生模型)模仿大模型(教师模型)的输出分布,而不仅仅是学习硬标签,从而使小模型获得远超其规模的性能表现。"推理蒸馏"特指对模型思维链(Chain-of-Thought)或中间推理步骤进行提取和复制,而非仅复制最终答案。由于推理能力被普遍认为是当前大模型最难复现的核心能力之一,通过大量构造对话来诱导目标模型输出详细推理过程、再用这些数据训练自有模型,构成了一种成本远低于原始训练的"捷径"。这类行为通常违反服务商的使用条款,并处于知识产权法律保护的灰色地带——因为模型输出本身的版权归属在各司法管辖区尚无定论,使得法律追责难度较高。
快决策模型与智能体监控
OpenAI的 Decisions API 被指与创业公司TypeSafe的产品属于同类,对方CEO调侃"克隆战争开始"。这类快决策模型正被越来越多地用于监控AI代理的行为——当智能体自主执行任务时,需要一个轻量、快速的模型来实时判断其决策是否安全合规。
随着AI Agent应用的铺开,"用AI监督AI"正在成为一个新兴的技术需求。快决策模型低延迟、高频次的特性,恰好契合了智能体监控场景。
芯片设计与硬件新品
OpenAI与芯片设计软件公司**新思科技(Synopsys)**达成多年合作,共同开发 GPT Synopsys,让模型直接操作EDA工具进行设计迭代,目前仍在开发中。这意味着大模型正从辅助编码走向直接操作专业工具链,芯片设计这类高度专业的领域也开始引入生成式AI。
硬件方面,英伟达上线了 Vera Rubin NVL72 系统,并推出了号称首款为AI代理设计的CPU。首个生产客户的实测显示吞吐量提升最多达4.8倍。专为AI代理设计的处理器,预示着硬件厂商也在针对智能体工作负载进行架构优化。
EDA(Electronic Design Automation,电子设计自动化)工具是芯片从逻辑设计到物理版图全流程的核心软件平台,涵盖逻辑综合、布局布线、时序分析、仿真验证等环节。新思科技(Synopsys)是全球EDA市场的头部厂商之一,其工具链在先进制程芯片设计中被广泛采用。传统EDA工具操作界面高度专业,工程师需要积累大量领域知识才能高效使用。将大语言模型与EDA工具链对接的难点在于:芯片设计的错误代价极高、验证周期极长,模型生成的设计方案需要经过严格的仿真和形式验证才能确认正确性。因此GPT Synopsys当前仍处于开发阶段并不意外——这类应用对模型的准确性和可靠性要求远超一般代码生成场景,距离真正的生产级落地还需要大量针对性的对齐与测试工作。
应用与评测:MUSE增长与语音合成榜单
Meta的智能体助手 MUSE 上线22天,在美国下载量突破500万次,速度比ChatGPT快一倍多。不过报道指出,这一增长在很大程度上依靠Meta自家的广告投放拉动,实际的自然增长成色仍需观察。

Hugging Face则上线了开源的语音合成榜单,从词错率、实时倍率和音色相似度三项客观指标进行评测,几小时即可出结果。但官方也坦承,客观指标无法完全代替人耳的主观听感——这也点出了当前语音合成评测的一个核心难题:量化指标与真实体验之间仍存在差距。
总结
本期九条消息折射出AI行业的几条清晰脉络:旗舰模型竞逐百万Token与稀疏架构,国产算力生态加速适配,推理能力成为竞争与安全博弈的焦点,以及AI向芯片设计、智能体监控等专业场景的纵深渗透。无论是模型、算力还是应用,竞争都在向更底层、更专业的方向演进。
相关推荐

看懂n8n工作流只需四要素:触发、数据、逻辑、动作
学n8n自动化不要只会抄模板。掌握触发、数据、逻辑、动作四个核心要素,你就能看懂任何工作流、独立搭建并在出错时快速调试,从模板搬运工进阶为真正的自动化构建者。
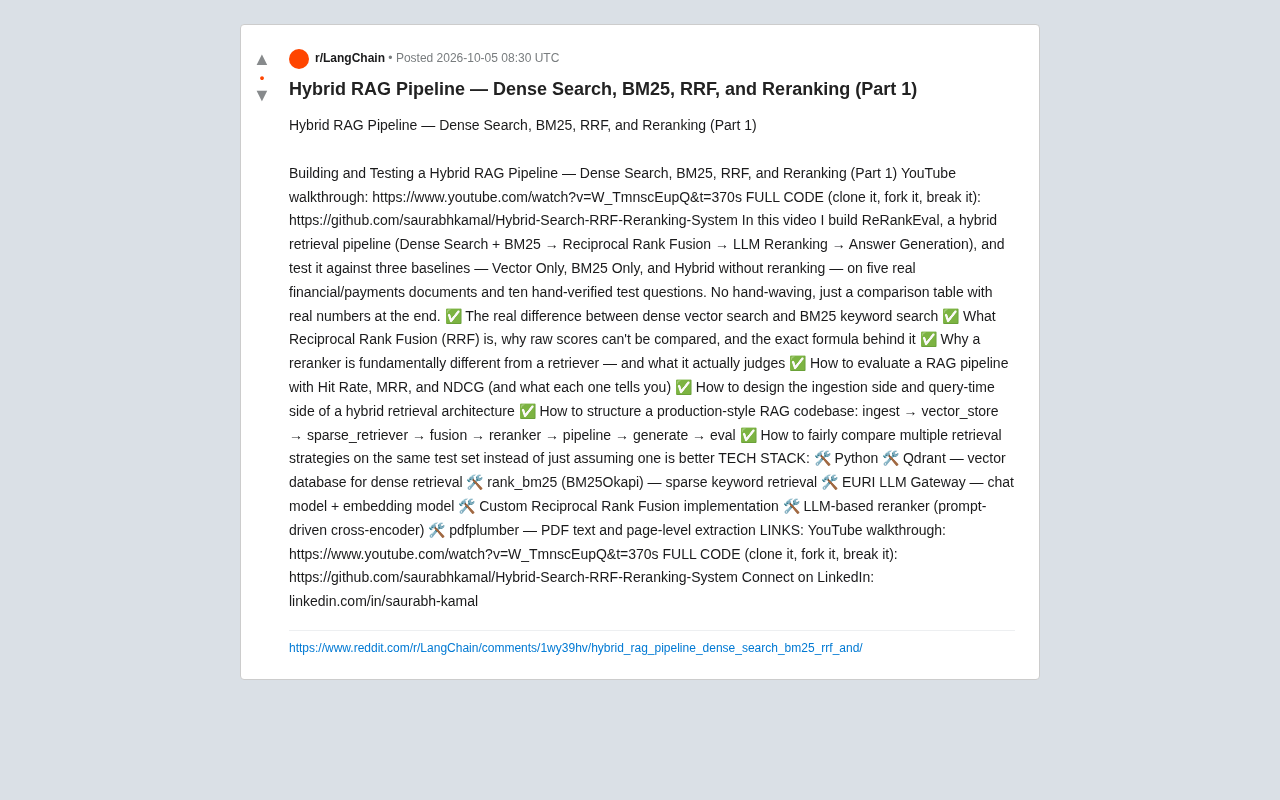
混合RAG检索实战:Dense+BM25+RRF与重排序完整解析
深入解析开源项目 ReRankEval 混合 RAG 检索管线:稠密向量搜索、BM25、RRF 倒数排名融合与 LLM 重排序如何协同,以及用 Hit Rate、MRR、NDCG 科学评测检索质量的完整方法。

Browser MCP 登录会话保活:AI Agent 自动化的隐形门槛
AI Agent 接入 Browser MCP 后登录会话过夜失效、重复认证烧掉大量 token,是自动化落地的常见痛点。本文剖析会话持久化难题的本质,并给出持久化 profile、会话解耦、凭证轮换应对等务实思路。