AI日报:OpenAI重开200美元Pro,Claude Sonnet 5.5上线

OpenAI重开Pro订阅、Anthropic推出Sonnet 5.5、Manus 2.0主打降本,AI赛道竞争全面提速。
9月29日,AI圈多条重磅动态集中释放。OpenAI宣布重开每月200美元的Pro订阅(仅限新用户),并调整用量计算方式,同时预告DevDay演讲;另据报道,其因安全顾虑暂缓发布代号Astra的新模型。Anthropic同日正式开放Claude Sonnet 5.5,与OpenAI的节奏形成直接竞争。Agent侧,Manus发布2.0版本,新底座Cascade在Token消耗、任务时间与成本三项指标上均实现两位数降幅,并新增云电脑与事件触发自动化能力。开源生态方面,魔搭上线书生决策系列模型,提供0.8B至4B三档参数选择。整体来看,行业竞争焦点正从模型能力转向落地经济性,降本、安全与效率成为新主线。
9月29日的AI圈密集释放多条重要动态,从OpenAI重新开放高价订阅,到Anthropic更新旗舰模型,再到Manus发布新一代Agent框架,几条消息串联起当下大模型与智能体赛道的竞争态势。以下是对这些关键进展的梳理与分析。
OpenAI动作频频:Pro订阅重开、DevDay演讲登场
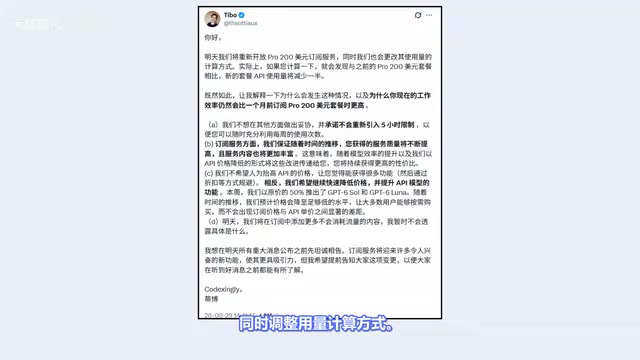
OpenAI Codex团队成员透露,将重新开放每月200美元的Pro订阅,但此次仅面向新订阅用户,并同步调整用量计算方式。限定新用户加上重新设计的计费逻辑,透露出OpenAI在高端算力资源分配上的谨慎——Pro级别往往对应更高的推理成本,重开订阅的同时收紧用量,意在平衡供给压力与商业回报。
另一边,OpenAI开发者账号预告将于次日举行DevDay主题演讲,并已开放线上直播入口。Codex团队的Tibo发推称"昨天的事已过去,今天就是DevDay",并表示"全部都是好消息",为这场开发者大会预热。
另一条值得关注的消息来自华尔街日报:报道称OpenAI因安全顾虑暂不发布内部代号为Astra的新模型(传闻中的GPT-6.1)。该说法尚未获得官方确认,但若属实,反映出前沿模型发布节奏正越来越受安全评估的约束。
Anthropic更新旗舰:Claude Sonnet 5.5正式开放
Anthropic宣布Claude Sonnet 5.5上线,该模型现已正式开放使用。Sonnet系列一直是Anthropic在性能与成本之间的平衡之作,定位于高频日常任务与编程场景。此次版本迭代,正值OpenAI与Anthropic在编程助手、Agent能力上的直接竞争期,模型更新的密度明显加快。
从行业视角看,Sonnet 5.5与OpenAI的一系列动作几乎同期发生,两家头部厂商在同一时间窗口密集发布,既是技术迭代的自然结果,也带有明显的市场卡位意味。
Manus发布2.0:Cascade框架主打降本增效
Manus发布2.0版本,网页端与桌面端同步上线,核心亮点是全新底座Cascade——面向字眼级(token级)Agent框架的迭代。官方给出的数据颇具说服力:Token消耗降低23.2%,任务时间缩短28.2%,成本下降32%。

这组数字直指当前Agent产品的核心痛点。智能体执行多步任务时,Token消耗与耗时往往成倍放大,成本控制是落地的关键门槛。Cascade在三个维度同时优化,说明Manus的产品思路已从"能不能做"转向"做得够不够省"。
此外,Manus 2.0新增了云电脑、事件触发自动化以及Q应用等能力。云电脑与事件触发自动化的加入,意味着Agent正从被动响应走向主动执行,这与整个行业追求的"自主智能体"方向一致。
Token(词元)是大语言模型处理文本的基本计量单位,大致对应半个到一个英文单词或半个中文字符。Agent在执行多步骤任务时,每一轮的推理、工具调用与结果解析都会消耗Token,且步骤之间需要携带上下文,导致Token消耗随任务复杂度呈指数级增长。以一个需要浏览网页、调用API、汇总报告的三步Agent任务为例,实际消耗往往是单次对话的5到10倍。这正是Cascade重点优化的方向——通过压缩上下文表示、减少冗余中间步骤等手段,在不损失任务完成质量的前提下降低每次运行的计算费用。对于希望将Agent能力商业化落地的企业而言,单次任务成本直接影响ROI,因此降本数据往往比性能跑分更具说服力。
开源与生态:书生决策模型、DeepSeek插件导航
魔搭(ModelScope)上线了InternDecision(书生决策)系列模型,覆盖0.8B、2B、4B三种参数规模,面向多模态与结构化决策任务。多档参数的设计兼顾了不同算力条件下的部署需求,小参数版本尤其适合边缘与轻量化场景。

生态工具方面,DeepSeek广告相关推荐了三个插件导航站,分别聚焦插件发现、市场与精选资源的聚合。随着大模型应用生态扩张,这类导航与聚合工具正成为开发者快速找到可用插件的入口。

模型参数规模(如0.8B、2B、4B中的B代表十亿参数)是衡量模型容量与计算需求的核心指标。参数量越大,模型通常具备更强的推理与泛化能力,但同时对GPU显存和推理算力的要求也成比例提升。0.8B量级的模型可在消费级显卡甚至部分移动设备上运行,适合对延迟敏感或离线部署的边缘场景;2B至4B则在轻量化与能力之间取得平衡,适合中小型服务器或云端低成本实例部署。书生决策系列覆盖三档参数,使开发者可以根据实际算力预算和任务复杂度灵活选择,避免"大模型一刀切"带来的资源浪费,这也是当前开源社区推动模型轻量化的主流策略之一。
小结:竞争节奏加快,降本成为新主线
综合当天动态,可以看到几条清晰的行业脉络。OpenAI与Anthropic在模型与订阅层面短兵相接,发布节奏明显提速;Manus以实打实的降本数据切入Agent赛道,把成本效率摆到台前;开源侧则通过多参数规模的决策模型丰富落地选项。
模型能力之外,成本、效率与安全正成为厂商竞争的新焦点。无论是OpenAI收紧Pro用量、因安全顾虑推迟发布,还是Manus强调Token与成本的双降,都说明大模型行业正从"比拼参数"进入"比拼落地经济性"的新阶段。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。