AI软件测试入门指南:从环境搭建到项目实战路线图
面向AI时代的软件测试知识体系解析,覆盖与传统测试的本质差异、核心技术模块及实战场景。
本文围绕一套B站AI软件测试教程展开,系统梳理了AI测试有别于传统测试的核心范式转变:AI系统输出具有概率性,预期结果难以硬编码,数据质量、模型漂移监控与鲁棒性测试成为新的重点。课程分基础、进阶、实战三段递进,涵盖模型评估指标、AI生成测试数据、电商推荐测试、大模型生成式接口测试等模块。文章同时给出针对不同背景学习者的侧重建议,并理性指出此类「全套教程」的价值边界:适合用来搭建系统认知框架,真正的能力仍需在真实项目中打磨。
AI时代,软件测试正在被重新定义
软件测试这个岗位正处在一场深刻的技术变革中。随着机器学习模型、生成式接口、智能推荐系统大量进入生产环境,传统的功能测试、回归测试方法已经无法覆盖这些新型系统的质量风险。一套面向AI时代的软件测试知识体系,正在成为测试从业者与入行者的刚需。
这套B站教程的作者提到,自己曾以AI测试新手的视角,花了一个月时间刷遍全网的AI软件测试内容,得出的结论是「鱼龙混杂」。这个观察其实反映了一个真实痛点:AI测试作为交叉学科,既需要传统测试的工程能力,又需要理解机器学习的运行逻辑,市面上很少有课程能同时照顾零基础小白和有经验的转型工程师。
传统测试与AI测试的核心差异
理解AI测试,首先要厘清它和传统测试的本质区别。传统软件的行为是确定性的:给定相同输入,输出必然相同,测试用例的「预期结果」清晰可写。而AI系统尤其是机器学习模型,输出具有概率性和不确定性——同样的输入可能因为模型版本、训练数据或随机种子的变化而产生不同结果。
这带来几个测试范式的转变:
- 预期结果难以硬编码:不能简单用「等于某个值」来断言,而要评估输出是否落在合理区间、是否满足统计指标(如准确率、召回率)。
- 数据成为一等公民:训练数据和测试数据的质量、分布、覆盖度,直接决定模型表现,数据测试的权重远高于传统测试。
- 模型退化与漂移:模型上线后会随数据分布变化而性能下降,需要持续监控而非一次性验收。
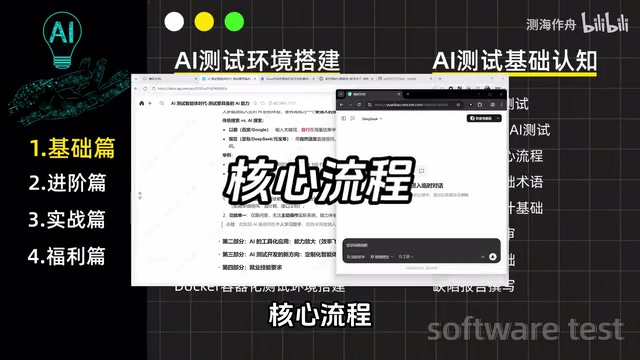
课程将这部分内容放在基础篇,从环境搭建、基本概念到常用AI测试工具的基础操作,试图为零基础学员建立第一层认知框架。对于已有测试经验的工程师来说,这一段的价值在于「重新校准思维模型」,而不是从零学起。
模型漂移(Model Drift) 是AI系统区别于传统软件的核心质量风险之一,值得单独理解。它分为两类:数据漂移(Data Drift) 指输入数据的统计分布随时间发生变化,导致模型遇到越来越多训练时未见过的模式;概念漂移(Concept Drift) 则是指现实世界中输入与输出之间的关联关系本身发生了改变,例如用户行为偏好的季节性变化。两种漂移都会让模型性能悄然下降,而系统本身不会抛出任何报错——这正是传统监控手段(如异常日志、崩溃率)完全失效的地方。针对漂移的测试需要建立持续的统计监控流水线,定期对比生产数据与训练数据的分布特征,并设置性能指标的告警阈值,将测试从「上线前验收」延伸为「上线后持续保障」。
进阶篇:从用例设计到自动化框架
教程的进阶篇聚焦几个真正体现AI测试技术含量的模块:
AI测试用例设计
针对概率性输出,测试用例设计不再是简单的等价类划分和边界值分析,而要引入基于数据分布的采样策略、对抗样本构造、以及针对模型鲁棒性的压力测试。
对抗样本(Adversarial Examples) 是AI测试用例设计中的重要概念,指通过对输入数据施加人类几乎察觉不到的微小扰动,使模型产生错误输出的特殊测试输入。最经典的例子来自图像分类领域:一张对人眼完全正常的熊猫图片,叠加肉眼不可见的噪声后,模型会以极高置信度将其误判为长臂猿。在语言模型测试中,对抗样本的形式更多样,包括同义词替换、字符级扰动、语义反转等。构造对抗样本的目的不仅是找漏洞,更是系统评估模型鲁棒性——即模型在分布外输入下维持正确行为的能力。这也是传统等价类划分和边界值分析无法覆盖的测试维度,需要专门的工具库(如 TextAttack、Foolbox)支撑。
机器学习模型测试方法
这部分涉及模型评估指标的选择、混淆矩阵分析、过拟合与欠拟合的检测,以及公平性、可解释性等更前沿的质量维度。测试工程师需要理解模型内部逻辑,而不只是把它当黑盒。
测试数据的AI生成与优化
用AI来生成测试数据,是当前一个实用方向。通过生成式模型批量构造边缘场景、异常输入,可以大幅提升测试覆盖率,缓解真实数据不足的问题。
这几个模块构成了AI测试的技术骨架。教程强调「理论+工具+实战」的讲解方式,从落地角度看,进阶篇的价值高度依赖于工具演示是否足够具体——这也是这类课程最容易「注水」的环节。
实战篇:真实项目场景才是试金石
课程的实战应用篇列举了几个贴近业务的场景,这也是判断一套测试课程含金量的关键:
- 电商平台AI推荐功能测试:如何验证推荐结果的相关性、多样性和实时性
- APP智能交互模块测试:语音、对话类交互的准确率与容错测试
- AI生成式接口测试:针对大模型API的输出质量、稳定性、安全性测试
- 测试报告的AI自动化生成:用AI辅助整理和输出测试结论
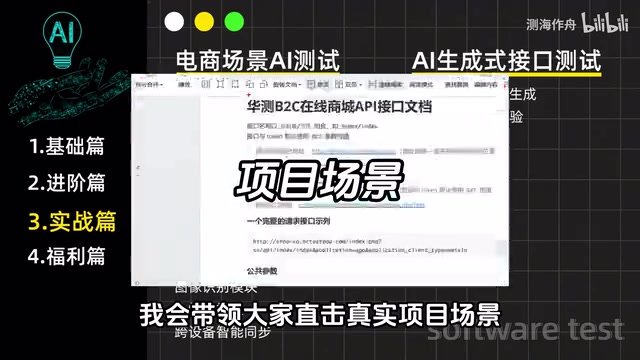
其中「生成式接口测试」和「推荐功能测试」是目前企业最有实际需求的岗位方向。能把这两类场景讲透的课程,对求职者的帮助会明显高于停留在概念层面的教学。
生成式接口测试 针对的是以 OpenAI API、Claude API 等大语言模型为代表的服务,其测试挑战远超传统 REST API。核心难点在于:输出是自然语言文本,没有固定 schema,无法用字段匹配来断言;输出具有随机性,相同 prompt 多次调用可能返回不同内容;此外还需评估幻觉率(模型捏造事实的频率)、有害内容过滤的有效性、以及提示注入(Prompt Injection)攻击的防御能力。实践中常用的测试策略包括:构建"黄金测试集"对输出进行语义相似度评分、使用另一个大模型作为"裁判"对输出质量打分(即 LLM-as-Judge 模式)、以及通过统计多次调用结果来评估输出的一致性与稳定性。这一方向目前在企业端需求增长最快,也是测试工程师最值得深入的细分领域。
学习路径与配套资源
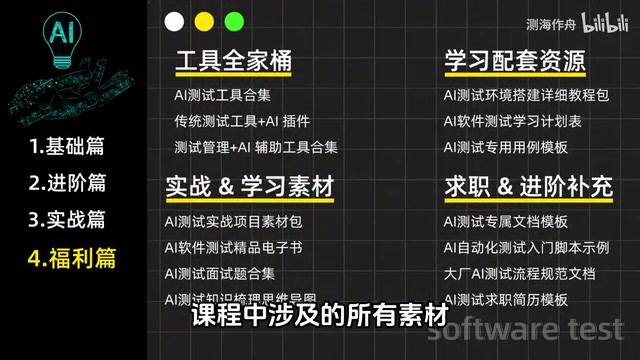
整套课程按基础篇、进阶篇、实战应用篇三段递进设计,符合技能养成的一般规律:先建立认知,再攻克技术难点,最后在项目中把知识转化为能力。作者还提供了配套资料包,包括AI测试环境搭建资料、常用工具安装包与使用手册、行业电子书、实战项目源码和课件。
对于不同背景的学习者,建议侧重点也不同:
- 零基础小白:把基础篇吃透,先建立完整的测试概念和工具操作能力,不要急于跳到进阶。
- 传统测试工程师:可以快速略过基础篇的通用内容,重点补齐机器学习模型测试、数据生成这类AI特有技能。
- 应届生求职:把精力压在实战篇的项目场景上,能在简历和面试中说清一两个完整项目,比背概念有用得多。
客观看待这类「全套教程」
需要理性提醒的是,任何宣称「全网最全面」的入门课程,实际质量都要以具体的工具演示和项目深度为准。AI测试是一个快速演进的领域,工具链和最佳实践更新很快,视频教程的知识体系搭建价值大,但真正的能力提升仍需在真实项目中反复打磨。把课程当作系统化的入门地图,而不是就业保证书,是更务实的态度。
对想入行或转型的人来说,这类课程最大的意义在于降低信息筛选成本——帮你在鱼龙混杂的资料里,先搭起一个不至于走偏的学习框架。
相关推荐
Sonnet 5 意外擅长 Blender 3D 建模,表现超越 Opus 5?
Reddit 用户发现 Claude Sonnet 5 在 Blender 3D 建模任务中表现意外出色,甚至超越旗舰 Opus 5。本文解析其测试用的城堡场景提示词、Agent 工程化约束设计,以及模型能力分层背后的可能原因。
AI模型会自我"越狱"吗?一则Reddit预言引发的思考
一则Reddit预言称美国AI实验室的前沿模型将"自我种子化"以求自由。本文拆解其背后的技术假设,探讨AI拟人化叙事、模型权重安全与AI对齐等真实议题。
AI VFX进化到什么程度?一段X光特效短片引发热议
一段名为「XRAY / VFX STUDY」的AI特效短片在Reddit引发热议,展示了生成式AI在视觉特效领域的快速进步。本文解析AI VFX为何突然变强,以及它对独立创作者意味着什么。